
XiaoMi-AI文件搜索系统
World File Search SystemAutomated

自动文本识别
自动文本识别是一个困难但重要的问题。它可以概括为:如何使计算机能够识别预定义字母表中的字母和数字,可能使用上下文信息。已经进行了各种尝试来解决这个问题,使用不同的特征和分类器选择。自动文本识别系统在准确性方面已经达到了人类的表现,并且在单一大小、单一字体、高质量、已知布局、已知背景、文本的情况下,速度超过了人类的表现。当上述一个或多个参数发生变化时,问题变得越来越困难。特别是,尽管近四十年来不断进行研究,但要达到人类在识别不同大小、不同风格、未知布局、未知背景的草书方面的表现,远远超出了当今算法的范围。在本报告中,我们详细分析了该问题,介绍了相关困难,并提出了一个解决自动文本识别问题的连贯框架。

深层:使用深度学习和公共多光谱图像促进大规模自动化树库存
Deeptrees项目提供了用于培训,微调和部署深度学习模型的工具,以使用德国的数字矫正图计划(DOP)以20 cm的分辨率从德国的数字矫正图计划(DOP)中使用公共访问的图像进行诸如Tree Crown分割,树状特征检测和树种分类。这些DOP图像是根据“ Amtliches popographis-kartographissches Informationssystems”(AKTIS)指南进行标准化的,以确保其长期使用的可靠性和一致性[2]。利用深层python软件包,我们成功地绘制了萨克森州(137,293,260棵树)和萨克森 - 安哈尔特(81,449,641棵树)的218,742,901棵树,展示了该工具在森林,Urban和乡村环境中的可伸缩性(图1)。这些数据集为市政当局和机构提供了宝贵的见解,以管理街道树木,监测城市绿化和评估森林健康,从而实现更明智的决策和可持续的管理实践。

新空间的未来趋势:自动提示和提示
与生产可靠的Geoint相关的挑战之一是地球特征,结构和特征签名的不断发展的本质。此挑战通常与基于活动的智能(ABI)相关联:一种分析方法,该方法可以整合来自多个来源的数据以发现相关模式并确定和表征变化。以变化的速度监视和提取有价值的见解通常需要持续且快速重新审视能力。具有有效捕获动态特征和目标的能力,未来的空间体系结构可以开始发现并建立跨感兴趣的区域领域的关键关联和相互依存关系。商业空间组织正在越来越多地使用大量较小的卫星系统,以提供在快速展开的事件和活动中维持步伐所需的收集频率。
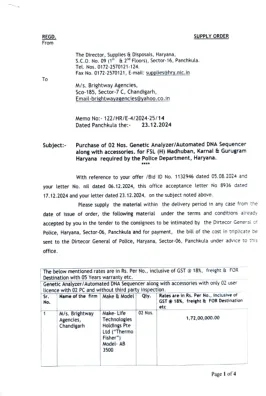
购买02号遗传分析仪/自动化DNA Sequencer以及配件。对于FSL(H)Madhuban,Karnal&Gurugram Haryana,需要P केंदीयलयलय 从教科书中学习任何三首诗。 •做5 ... 一个基于证据的排名,2024 全印度高等教育调查2021-22 KVDRDO生物学节日家庭作业2024年12月 3.0 Ojee的教学大纲 - 2025 b''
1。电气要求:220 V,AC 50Hz。2。基于聚合物的8个具有升级性的毛细血管,具有自动采样板系统的自动DNA分析仪/测序仪,具有6个基于染料或更好的化学。3。CCD或带有固态长寿命激光探测器的最新高级技术摄像头。4。应具有最新版本的设备操作和数据收集软件。供应商/供应商应免费提供所有随后的设备操作和数据收集软件升级,从供应之日起五年。制造商证书/承诺应附有技术规范提供文件。5。应具有最新版本的经过验证的软件,用于碎片尺寸(法医str,简短的串联重复,基于人类的标识),并提供其他两个用户许可证,以及每个LICERNSE的必要硬件,包括网络和连接性。该软件应具有具有广泛安全性的功能,并审核功能支持最新发表的研究论文。6。遗传分析仪应在国际准则(例如DNA分析方法(SWGDAM))等国际准则上进行法医DNA分析验证。7。仪器应为支持所有市售的STR套件的开放平台。供应商/供应商应在这方面提交合格证书。8。y-STR(100个反应)。9。10。对最终用户实验室科学家的现场培训。11。0q&PQ文档。应提供基质标准,聚合物容器,毛细管阵列(36厘米),阳极和阴极缓冲液,去离子甲酰胺,试剂和消耗品和塑料软件等以及Str套件,即常染色体 - STR(200反应)。供应商还应提供交钥匙解决方案,以功能化仪器,但不限于:合适的反振动工作台,微型固定,微型,涡流,合适的可变容量移液,96个井板板板微型中心,合适的容量存储设备,适用于具有4'C温度和-20*C温度范围的PCR套件的合适能力,可用于保持4'C和-20*C温度范围的适用量设备及其最佳性能。完整的智商完成现场验证研究。12。兼容Ontine UPS与一个小时的备份(7 kVa)。13。应提供合适的高质量彩色打印机。

crd-automated-decision-decision-initial-statement.pdf
2021年4月30日,理事会举行了关于算法和偏见的民权听证会。理事会从使用算法,人工智能和机器学习工具作为自动化系统的一部分,从使用算法,人工智能和机器学习工具中,可能导致就业,住房,医疗保健和其他环境的歧视获得了专家证词和公众评论。简而言之,在就业背景下,自动化决定系统是一个计算过程,它以影响申请人和/或员工的方式做出决策或促进人类决策。(请参阅下面的第11008.1(a)节,了解理事会关于就业的拟议完整定义“自动化否决系统”。就业。(请参阅新闻稿:DFEH举行有关算法和偏见的民权听证会(2021年5月6日)https://calcivilrights.ca.gov/wp-content/uploads/sites/sites/sites/32/32/2021/05/05/algorithms-hensing-press-propers.press.pdf(上次访问了302. 302. 302. 302:302:302:302:302.3;算法和偏见听证会(4月30,2021)https://www.youtube.com/watch?v=iq_6f9lmufu(上次访问于2023年9月5日)。白宫在最近的AI人权法案的蓝图中解释说:
使用基于机器学习的识别系统
摘要 - 手动跟踪教室出勤,这是一种备受推崇的传统方法,由于其对错误和效率低下的敏感性而提出了重大挑战。这些限制不仅消耗了宝贵的教师时间,而且损害了学术记录的准确性,从而影响了学生参与和表现的评估。回答这个问题,我们提出了一种使用基于机器学习的识别系统自动化课堂出勤的方法。这项研究旨在提高教育环境中出勤跟踪的准确性,效率和可靠性。我们研究的核心在于系统的设计和实施,阐明体系结构,数据流和集成到课堂环境中。我们的分析结果表明该系统可以跟踪出勤率的能力,同时提供有关其性能指标的准确信息。我们还深入研究了在课堂上实施此类技术的道德和实际考虑。通过使用基于机器学习的识别来自动化该过程,教育机构可以提高其运行效率,降低错误,并最终提供更有生产力的学习环境。我们的研究为教育研究和技术进步的未来途径打开了大门。关键字 - 自动出勤,出勤跟踪,面部识别,机器学习,课堂技术


机器学习Clifford不变的Ade Coxeter元素
摘要。胸肌分割是乳腺磁共振成像(MRI)的各种计算机辅助应用中的关键步骤。由于胸部和乳房区域之间的伪影和同质性,胸肌边界估计并不是一项琐碎的任务。在本文中,提出了一种基于深度学习的全自动分割方法,以准确描述轴向乳房MR图像中的胸肌边界。提出的方法涉及两个主要步骤:胸肌分割和边界估计。对于胸肌分割,基于U-NET结构的模型用于从输入图像中分离胸肌。接下来,通过候选点检测和轮廓分割来估计胸肌边界。使用两个Real-World数据集,我们自己的私人数据集和一个公开可用的数据集对所提出的方法进行了定量评估。第一个数据集包括12名患者乳房MR图像,第二个数据集由80名患者乳房MR图像组成。所提出的方法在第一个数据集中达到了95%的骰子得分,第二个数据集的骰子得分为89%。在大规模定量乳房MR图像上评估该方法的高分割性能表达了其在将来的乳腺癌临床应用中的潜在适用性。