
XiaoMi-AI文件搜索系统
World File Search SystemDetect

使用计算机视觉检测年龄和性别检测
摘要:在计算机视觉的领域,使用OpenCV的年龄和性别检测是一种关键应用,展示了复杂算法和真实世界应用的融合。该项目努力开发一个能够准确估算图像或视频流的年龄和性别的强大系统。利用OpenCV的力量,一个流行的开放式计算机视觉库,再加上机器学习技术,该系统旨在自动将个人分类为预定义的年龄组和性别类别。通过面部特征分析,深度学习模型和图像处理技术的结合,系统可以以惊人的精度辨别年龄和性别属性。通过将该技术集成到各种领域,例如监视,营销和用户体验自定义,该项目努力为各种社会和商业挑战提供实用的解决方案。年龄和性别的抽象性质使这项努力多基础,需要一种细微的方法,包括数据预处理,模型培训和绩效优化。最终,该项目有助于进步计算机视觉应用程序,从而促进了许多领域的创新和效率。关键字:CNN,深度学习,性别分类,年龄检测。I.在当今相互联系的世界中引言,在那里,数字互动和社交媒体渗透到日常生活中,了解人口统计学(例如性别和年龄)变得越来越重要。II。II。智能设备的扩散促进了大量数据的收集,其中大部分包含对人类行为和互动的宝贵见解。在利用这些数据,性别和年龄预测算法的无数应用程序中,它们在增强用户体验,个性化内容并告知决策的潜力中脱颖而出 - 在各个领域制定过程。由于其丰富的信息内容,面部照片已成为性别检测和年龄预测算法的主要来源。利用图像处理,特征提取和分类技术方面的进步,研究人员和开发人员设计了复杂的方法来分析面部特征并准确推断人口统计学属性。这些方法通常涉及阶段,例如增强图像,以提高质量和分割以隔离相关特征,从而为后续分析奠定了基础。通过训练大型数据集的神经网络,我们旨在开发能够准确地将性别预测为“男性”或“女性”的强大模型,并可能基于实验参数对年龄组进行分类。除了技术复杂性之外,人类面部图像对各个行业和社会领域都具有深远的影响。从安全和娱乐到招聘和身份验证,从面部图像中检测性别和年龄的能力可以简化流程,增强安全措施并为战略决策提供了信息。相关作品本文使用应用于面部图像的深度学习技术介绍了有关性别识别的研究。此外,面部表情,人类交流的重要方面,提供了对情感状态和反应的见解,使面部图像分析成为心理学家和研究人员的宝贵工具。通过阐明这些技术的方法,挑战和潜在应用,我们旨在为计算机视觉中的知识不断增长,并促进具有真实世界影响的实用解决方案的发展。作者探索了卷积神经网络(CNN)的使用进行特征提取和分类,从而实现了有希望的
使用机器学习技术的假新闻检测
摘要 - 社交媒体中的人们传播了许多信息,以更新其状态并与他人分享关键新闻。但是,这些平台中的大多数并未迅速验证个人或其帖子,人们无法手动识别假新闻。因此,需要一个能够检测假新闻的自动化系统。这项研究提出了使用四种机器学习算法构建模型。实验中采用的数据集是两个数据集的综合,其中包含几乎相等数量的有关政治的真实和虚假新闻文章。预处理阶段首先要通过删除标点符号,令牌化,特殊字符,白色空间,冗余单词消除,数字和英文字母,然后启动并停止数据离散化。然后,我们分析了收集到的数据,其中80%的数据最初用于训练每个模型。之后,应用四种明显的分类算法。使用新闻文章中的虚假新闻,诸如逻辑回归,决策树,随机森林和梯度提升分类器之类的方法。使用其余20%的数据评估了受过训练的分类器的精度。结果表明,决策树模型的最佳精度为99.60%,梯度提升为99.55%。此外,随机森林显示99.10%,逻辑回归98.99%。此外,我们还探索了根据混乱矩阵的结果获得最高精度,回忆,F1得分的最佳模型。索引术语 - 社会媒体,虚假新闻检测,机器学习,分类器,逻辑回归,决策树,随机森林,梯度提升。

文章检测难以捉摸的DNA拷贝数变体...
拷贝数变体(CNV)在遗传性疾病和癌症的分子发病机理以及正常的人间变异中起着重要作用。但是,它们仍然很难在主流测序项目中识别,尤其是涉及外显子组测序,因为它们通常发生在非针对分析的DNA区域中。为了克服这个问题,我们开发了非高峰,这是一种用户友好的CNV检测工具,该工具以denoising方法为基础,并且使用“''target''DNA读取,通常通过测序管道来丢弃它。我们根据96种癌症的靶向测序以及来自三种不同人群的遗传性视网膜疾病的个体的130个个体进行了基准测试。对于两组数据,非高峰均表现出出色的性能(> 95%的灵敏度和> 80%的特定峰与实验验证),可在仅检测单独的硅数据中的CNV,这表明其对分子诊断和遗传研究的直接适用性。

机器人上肢矫形器的意图检测策略:考虑可用性、日常生活应用和用户评价的范围审查
可穿戴机器人上肢矫形器 (ULO) 是辅助或增强用户上肢功能的有前途的工具。虽然这些设备的功能不断增加,但对用户控制可用自由度的意图的稳健和可靠检测仍然是一项重大挑战,也是接受的障碍。作为设备和用户之间的信息接口,意图检测策略 (IDS) 对整个设备的可用性具有至关重要的影响。然而,这方面及其对设备可用性的影响很少根据 ULO 的使用环境进行评估。进行了范围界定文献综述,以确定已通过人类参与者评估的应用于 ULO 的非侵入式 IDS,特别关注与功能和可用性相关的评估方法和发现及其在日常生活中特定使用环境的适用性。共确定了 93 项研究,描述了 29 种不同的 IDS,并根据四级分类方案进行了总结和分类。与所述 IDS 相关的主要用户输入信号是肌电图 (35.6%),其次是手动触发器,例如按钮、触摸屏或操纵杆 (16.7%),以及上肢节段的残余运动产生的等长力 (15.1%)。我们确定并讨论了 IDS 在特定使用环境中的优缺点,并强调了在选择最佳 IDS 时性能和复杂性之间的权衡。通过调查评估实践来研究 IDS 的可用性,纳入的研究表明,主要评估了与有效性或效率相关的客观和定量的可用性属性。此外,它强调了缺乏系统的方法来确定 IDS 的可用性是否足够高以适合用于日常生活应用。这项工作强调了针对用户和应用程序选择和评估用于 ULO 的非侵入式 IDS 的重要性。对于该领域的技术开发人员,它进一步提供了有关IDS的选择过程以及相应评估协议的设计的建议。
m3-uda:无监督域自适应胎儿心脏结构检测的新基准
胎儿心脏视图的解剖结构检测对于诊断胎儿先天性心脏病至关重要。实际上,不同的Hos-Pitals数据之间存在较大的域间隙,例如由于采集设备的不同而引起的可变数据质量。此外,产科专家提供的准确的符号信息非常昂贵甚至无法使用。本研究探讨了无监督的域自适应胎儿心脏结构检测问题。现有的无监督域自适应观察检测(UDAOD)的方法主要集中在自然场景中的特定物体,例如雾gy的城市景观中,自然场景的结构关系是不确定的。Unlike all previous UDAOD scenarios, we first collected a F etal C ardiac S tructure dataset from two hos- pital centers, called FCS , and proposed a multi-matching UDA approach ( M 3 -UDA ), including H istogram M atching (HM), S ub-structure M atching (SM), and G lobal-structure M atching (GM), to better transfer the在医疗场景中进行UDA检测的解剖结构的拓扑知识。HM减轻由像素转换引起的源和目标之间的域间隙。sm融合了子结构的不同角度信息,以遵循局部拓扑知识,以弥合内部子结构的主要间隙。GM旨在使整个器官的全球拓扑知识与目标域相结合。对我们收集的FCS和Cardiacuda进行了广泛的实验,实验结果表明,M 3 -UDA的表现胜过现有的UDAOD研究。数据集和源代码可在https://github.com/xmed-lab/m3-uda

Unimode:统一的单眼3D对象检测
实现统一的单眼3D对象检测,包括室内和室外场景,在机器人导航等应用中非常重要。然而,涉及各种数据方案来训练模型引起了挑战,因为它们的特性显着不同,例如,二 - 几何特性和异质域分离。为了应对这些挑战,我们根据鸟类的视图(BEV)检测范式建立了一个检测器,在该检测范式中,当采用多个数据方案以训练检测器时,明确的特征投影有利于对几何学学习模棱两可。然后,我们将经典的BEV检测体系结构分为两个阶段,并提出了不均匀的BEV网格设计,以处理由上述Challenges引起的收敛不稳定。此外,我们开发了稀疏的BEV功能策略,以降低计算成本和处理异质域的统一操作方法。将这些技术结合起来,得出了一个统一的检测器Unimode,它超过了富有挑战性的Omni3D数据集(一个大规模的数据集(一个室内和室外场景))的先前最先进的AP 3D,揭示了Bev bev tor tor tor tor tor tor tor unified 3D对象的第一个成功概括。

使用Li-Fi技术的车辆碰撞检测和预防系统
摘要 - 该项目解决了高速公路上驾驶员隐身性的关键问题,这通常会导致碰撞,尤其是当较小的车辆接近大型车辆(例如公交车或卡车)时。高速公路上的驾驶员隐身通常会导致事故,尤其是当较小的车辆接近较大车辆(如公共汽车或卡车)时。该项目使用图像处理和基于LIFI技术的实时车辆检测和通信系统。在重车上,有一个相机和一个Li-Fi发射器,而接近的车辆具有Li-Fi接收器。如果较小的车辆太近,则系统会发出仪表板警告的警告。该系统致力于减少与盲点和较晚反应有关的事故。具有基于Python的图像处理,在每种类型的天气和照明条件下都会发生准确的检测。NodeMCU微控制器控制图像处理单元和LI-FI发射器的数据流。实时数据通过LI-FI传输到传入的车辆,允许驾驶员更快地响应。该系统的延迟非常小于100毫秒,因此减少了后端碰撞,尤其是在可见度较差的情况下。这种具有成本效益和可扩展的解决方案适用于商用和乘用车,并突出了Li-Fi技术在改善汽车安全性方面的潜力,尤其是在基础设施有限的地区。
通过对齐已知类表示
开放式对象检测(OSOD)已成为当代研究方向,以解决对未知对象的检测。最近,很少有作品通过使用Con-Contrastive聚类来分开未知类,在OSOD任务中实现了可观的性能。相比之下,我们提出了一种新的基于语义聚类的方法,以促进语义空间中有意义的群集的对齐,并引入一个类去相关模块以实现群间间的分离。我们的方法进一步不适合对象焦点模块预测对象分数,从而增强了未知对象的检测。此外,我们采用了i)一种评估技术,该技术对低置信度输出进行了惩罚,以减轻对未知对象的错误分类的风险,ii)一种称为HMP的新指标,该指标使用hMP使用Har-nonic Mean结合了已知和未知的精度。我们的广泛实验表明,所提出的模型可以在OSOD任务上对MS-Coco&Pascal VOC数据集有显着改进。
大脑中线移位检测和通过级联的深层网络管道对非对比度计算机断层扫描
大脑中线移位(MLS)是一种定性和定量的放射学特征,它可以衡量脑中线结构的横向移位,以响应由血肿,肿瘤,脓肿或任何其他占据脑膜内病变引起的质量效应。可以使用其他参数来确定神经外科干预的紧迫性,并预测占据病变的患者的临床结果。然而,由于跨病例的临床相关大脑结构的差异很大,因此精确检测和量化MLS可能具有挑战性。在这项研究中,我们通过使用分类和分割网络架构来研究了由病例级MLS检测以及脑部标记位置的初始定位以及对脑部标记位置的最初定位和完善的级联网络管道。我们使用3D U-NET进行初始定位,然后使用2D U-NET来估计更精确的分辨率的确切地标点。在改进步骤中,我们从多个切片中融合了预测,以计算每个地标的最终位置。,我们用大脑的解剖标记产生的高斯热图目标训练了这两个UNET。案例级别的地面真相标签和地标注释是由多个训练有素的注释者产生的,并由放射学技术人员和放射科医生进行了审查。我们提出的管道实现了使用2,545个头部非对比度计算的测试数据集在AUC中的情况级MLS检测性能
开放式对象检测的生成区域训练
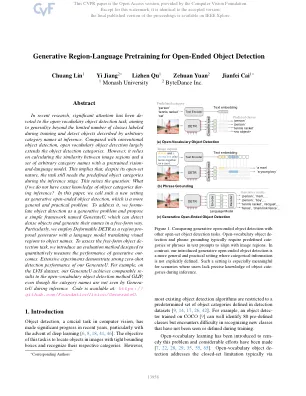
在最近的研究中,已对开放式摄制对象检测任务进行了大量关注,旨在概括训练期间标记的类别的有限级别,并检测推理时任意类别名称所描述的对象。与常规对象检测相比,打开的词汇对象检测在很大程度上扩展了对象检测类别。但是,它依赖于计算图像区域与一组具有验证视觉和语言模型的任意类别名称之间的相似性。这意味着,尽管具有开放式的性质,但该任务仍然需要在推理阶段的预定义对象类别。这提出了一个问题:如果我们在推理中对对象类别没有确切的了解,该怎么办?在本文中,我们称之为新的设置为生成性开放式对象检测,这是一个更普遍和实际的问题。为了解决它,我们将对象检测形式为生成问题,并提出了一个名为generateu的简单框架,该框架可以检测密集的对象并以自由形式的方式生成其名称。尤其是,我们采用可变形的DETR作为区域促成生成器,其语言模型将视觉区域转换为对象名称。为了评估自由形式的对象划分任务,我们介绍了一种评估方法,旨在定量测量生成量的性能。广泛的实验表明我们的生成量强烈的零射击性能。代码可在以下网址获得:https://github.com/foundationvision/generateu。例如,在LVIS数据集上,我们的GenerateU在推理过程中属于类别名称,即类别名称无法看到类别名称,即使类别名称看不见类别名称,我们的GenerateU也可以与开放式唱机对象检测方法GLIP相当。