
XiaoMi-AI文件搜索系统
World File Search SystemEnhancing
通过光动力疗法和纳米颗粒增强癌症免疫疗法:使肿瘤微环境更热使免疫治疗效果更好
癌症免疫疗法在治疗各种恶性肿瘤方面取得了巨大的进步。成功免疫疗法的最大障碍是癌细胞的免疫抑制肿瘤微环境(TME)和低免疫原性。要成功进行免疫疗法,必须将“冷” TME转换为“热”免疫刺激状态,以激活残留的宿主免疫反应。为此,应损坏TME中的免疫抑制平衡,应诱导免疫原性癌细胞死亡以适当刺激杀死肿瘤的免疫细胞。光动力疗法(PDT)是诱导癌细胞免疫原性死亡(ICD)并破坏免疫限制性肿瘤组织的有效方法。PDT会触发链反应,该链反应将使TME“热”并具有ICD诱导的肿瘤抗原呈现给免疫细胞。原则上,PDT和免疫疗法的战略组合将协同作用,以增强许多棘手的肿瘤的治疗结果。采用纳米载体的新技术是开发出来的,以提供光敏剂和免疫治疗剂对TME有效。新一代纳米医学已开发用于PDT免疫疗法,这将加速临床应用。

通过目标,阈值和社会生态目标来增强海洋保护区的气候变化计划和适应性管理
海洋保护区(MPA)正在全球部署,以保护地球的生物多样性在快速变化的海洋中。自适应MPA管理和监测中的气候变化考虑因素正在成为一种更普遍的方法,尽管MPA规划中越来越多地解决气候变化,但仍然存在实施差距。本研究将气候鲁棒性指数(CRI)应用于MPA监测计划,以评估场地和区域层面计划中如何概述气候变化。以前开发了用于评估MPA管理计划的,CRI分数计划基于其气候变化适应原理的纳入程度,包括适应性管理的核心要素。我们通过将美国MPA的指数分数与选定的MPA特征相关联,并通过检查特定的物理,生态和社会气候变化的影响,并在监测计划的监测范围内考虑,并研究了特定的物理,生态和社会气候变化的影响,从而为监测计划提供了补充。我们在MPA监视计划中发现可起作的目标和阈值的差距很大,这与先前评估MPA管理计划的研究一致,这表明在许多情况下,自适应管理周期是不完整的。我们将完成自适应管理周期的重要性视为一种核心气候适应策略,并探索社会生态目标和地方伙伴关系的作用,这是在不断变化的世界中继续改善MPA结果的途径。

利用人工智能 (AI) 加强翻译研究
这项理论研究探讨了翻译研究与人工智能(AI)之间的共生关系,强调了这两个领域之间合作的重要性。该研究探讨了将人工智能融入翻译应用程序的潜力,以提高翻译效率、克服语言障碍并扩大信息获取渠道。从这个角度来看,该研究探讨了一些重要的伦理问题,例如人类专业知识在翻译研究中人工智能整合中的作用、翻译的准确性和文化适宜性以及人工智能对劳动力的影响。该研究强调了将人工智能相关主题纳入翻译研究(或口译和翻译)课程的重要性,提倡促进学者和人工智能开发人员之间的合作研究项目,并认为人工智能比其本身更复杂。 IQ(智商)和 EQ(它提请人们注意缩小个人能力(情商水平/商数)之间的差距。翻译研究与人工智能 (AI) 之间的合作可以提供技术上准确且文化敏感的翻译,从而实现满足个人和企业需求的高质量翻译。这种协作可以提高人工智能在翻译活动中的质量和有效性,从而产生更可靠、更合适的翻译。因此,本研究强调了翻译研究与人工智能合作的重要性,并提请关注提高翻译服务质量和鼓励文化敏感性翻译传播等问题。

通过熵和引导多模式融合在不利天气条件下增强对象检测
摘要。通过互补感应方式整合各种表示形式对于自主驾驶中的强大场景解释至关重要。近年来,融合视觉和范围数据的深度学习体系结构具有先进的2D和3D对象检测。但是,这些方式在不利的天气或照明条件下通常会降解,从而导致性能下降。虽然已经开发了域适应性甲基元素来弥合源域和目标域之间的缝隙,但由于源和目标域之间的固有差异,它们通常会缺乏。此差异可以在数据的不同分布和不同特征空间的不同分布中表现出来。本文介绍了一个全面的域自适应对象检测框架。通过深度转移学习开发,该框架旨在从标记的透明天气数据中稳健地概括到无标记的不良天气条件,从而增强了基于深度学习的对象检测模型的性能。创新的斑块熵融合模块(PEFM)是我们方法的核心,该方法动态整合了sens-sor数据,强调关键信息并最大程度地减少了背景干扰。这进一步补充了一种新型的加权决策模块(WDM),该模块(WDM)根据其在特定环境条件下的功效来调整不同传感器的贡献,从而优化了检测准确性。此外,我们在转移学习过程中集成了域对齐损失,以确保有效的域适应性通过将特征图差异定于清晰和不利天气数据集之间的差异。我们评估了不同数据集的模型,包括Exdark(单峰),CityScapes(单峰)和密集(Mul-timodal),在我们评估的时间点,它在所有数据集中排在所有数据集中。
增强翻译中风康复:运动网络优化的特定任务动作观察疗法
年龄(年)71.7±10.8性别(女性 /男性)%8(40%) /12(60%)MAS-ul 1.25(0-6)FMA-UL 51(29-66)脂肪5(1-5)MBI 94(1-5)MBI 94(46-100)平均±标准偏差; n(%);中值(最小值最小)。修改后的Ashworth Scale-upper肢体(MAS-ul); FUGL-MEYER评估 - Upper肢体(FMA-ul);法式手臂测试(FAT);和修改的Barthel指数(MBI)。

进化:增强无监督的持续学习与多位专家
近年来在未加强的持续学习方法中取得了重大进展。尽管它们在受控设置中取得了成功,但它们在现实世界中的实用性仍然不确定。在本文中,我们首先从经验上介绍了现有的自我保护的持续学习方法。我们表明,即使有了重播缓冲液,现有的methods也无法保留与时间相关输入的视频的关键知识。我们的见解是,无监督的持续学习的主要挑战源于无法预测的意见,缺乏监督和先验知识。从Hybrid AI中汲取灵感,我们介绍了E Volve,这是一个创新的框架,它是云中的多个预审预周化模型,作为专家,以加强对Lo-cal Clister的现有自我监督的学习方法。e Volve通过新颖的专家聚合损失来利用专家指导,并从云中返回并返回。它还根据专家的信心和量身定制的先验知识将权重动态分配给专家,从而为新流数据提供自适应监督。我们在几个具有时间相关的实地世界数据流中广泛验证了E volve。结果令人信服地表明,E Volve超过了最佳的无监督持续学习方法,在跨Var-IOS数据流的Top-1线性评估准确性中,volve持续了6.1-53.7%,从而确认了多样化的专家指南的功效。代码库位于https://github.com/ orienfish/evolve。
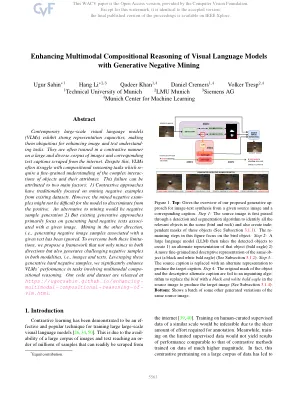
增强具有生成负面挖掘的视觉语言模型的多模式组成推理
当代的大规模视觉语言模型(VLM)具有强大的表示能力,使它们无处不在,可以增强图像和文本理解任务。他们经常以对比的方式受到大量图像和相应的文本字幕的对比方式进行训练。尽管如此,VLMS经常在构图推理任务上挣扎,这些任务对对象及其属性的复杂相互作用进行了精细的了解。此失败可以归因于两个主要因素:1)对比的方法传统上专注于从现有数据集中开采负面示例。但是,该模型可能不难区分阳性检查。替代采矿的替代方法是负样本2),但现有的生成方法主要集中于生成与给定图像相关的硬性负面文本。在另一个方向上进行挖掘,即生成与给定文本相关的负面图像样本已被忽略。为了克服这两种限制,我们提出了一个框架,不仅在两个方向上矿山,而且在这两种方式(即图像和文本)中产生了有挑战性的负面样本。利用这些生成硬性负样本,我们在涉及多模式综合推理的任务中显着提高了VLMS的性能。我们的代码和数据集在https://ugorsahin.github.io/enhancing-- vlm.html上发布。
增强文本对图像合成的DF-GAN
摘要。文本对图像合成是机器学习中最具挑战性和最受欢迎的任务之一,许多模型旨在提高该领域的性能。深融合生成的对抗网络(DF-GAN)是图像生成的直接但有效的模型,但它具有三个关键局限性。首先,它仅支持句子级文本描述,从而限制了其从文字级输入中提取细颗粒特征的能力。第二,可以优化残差层和块的结构以及关键参数,以提高性能。第三,现有的评估指标,例如FréchetInception距离(FID),倾向于不适当地强调无关紧要的功能,例如背景,当重点放在生成特定对象上时,这是有问题的。为了解决这些问题,我们引入了一个新的文本编码器,该编码器增强了具有处理单词级描述能力的模型,从而导致更精确和文本一致的图像生成。此外,我们优化了关键参数,并重新设计了卷积和残留网络结构,从而产生了更高质量的图像并减少了运行时间。最后,我们提出了一种量身定制的新评估理论,以评估生成图像中特定对象的质量。这些改进使增强的DF-GAN在有效地产生高质量的文本分配图像方面更有效。

游戏化与人工智能的协同作用:提高教育环境中学生的参与度和学习成果
在当今数字时代,将技术融入教育对于满足学习者多样化的需求变得越来越重要。随着教育机构努力提高学生的参与度和学习成果,游戏化和人工智能 (AI) 等创新策略已成为强大的工具。游戏化将类似游戏的元素融入非游戏环境,旨在提高学习积极性并创造沉浸式学习体验[1]。通过利用积分、徽章和排行榜等游戏机制,教育工作者可以营造一种既有竞争性又有协作性的环境,鼓励学生在学习过程中发挥积极作用。另一方面,人工智能通过分析学生数据并调整内容以满足个人需求来提供个性化的学习体验,从而促进更有针对性的教育方法[2]。

增强人工智能对科学和医学的积极影响
这些积极影响往往是通过开放的技术和科学方法实现的。开源人工智能模型允许科学家和初创公司在他人工作的基础上进行开发。1415 同样,开放数据集也允许集体创新。例如,DARPA Triage Challenge 是一项旨在提高急救人员和医务人员在战场和地震等情况下的能力的计划。16 挑战赛的人工智能系统有助于预测哪些伤害最为严重以及如何应对。为了做到这一点,DARPA 团队与马里兰大学和匹兹堡大学的医疗专业人员合作,建立了去识别的临床创伤患者数据集用于训练。17 与此同时,国家人工智能研究资源 (NAIRR) 正在为免疫学数据集、癌症数据集和其他大型数据集做出贡献,以更好地研究疾病。18