
XiaoMi-AI文件搜索系统
World File Search SystemGenerative

训练小波域损失的训练生成图像超分辨率模型可以更好地控制伪影
抽象的超分辨率(SR)是一个不当的反问题,其中具有给定低分辨率图像的可行解决方案集的大小非常大。已经提出了许多算法,以在可行的解决方案中找到一种“好”解决方案,这些解决方案在忠诚度和感知质量之间取得了平衡。不幸的是,所有已知方法都会生成伪影和幻觉,同时试图重建高频(HF)图像细节。一个有趣的问题是:模型可以学会将真实图像细节与文物区分开吗?尽管有些重点侧重于细节和影响的分化,但这是一个非常具有挑战性的问题,并且尚待找到满意的解决方案。本文表明,与RGB域或傅立叶空间损耗相比,使用小波域损失功能训练基于GAN的SR模型可以更好地学习真正的HF细节与伪像的表征。尽管以前在文献中已经使用了小波域损失,但在SR任务的背景下没有使用它们。更具体地说,我们仅在HF小波子带上而不是在RGB图像上训练鉴别器,并且发电机受到小波子带的忠诚度损失的训练,以使其对结构的规模和方向敏感。广泛的实验结果表明,我们的模型根据多种措施和视觉评估实现了更好的感知延续权权衡。
表演探索生成预训练的变压器-2歌词生成
摘要。近年来,自然语言处理领域(NLP)发生了一场革命,文字一代在这一转变中起着关键作用。这种转变不仅限于技术领域,而且还无缝渗透了创意领域,一个很好的例子是歌曲歌词的一代。真正有效的生成模型,例如生成训练的预训练变压器(GPT)-2,需要进行微调作为关键步骤。本文利用了广泛参考的Kaggle数据集的鲁棒性,标题为“歌曲歌词”,仔细探讨了调节三个关键参数的影响:学习率,批处理大小和序列长度。数据集提出了一个引人入胜的叙述,该叙述将学习率视为最有影响力的决定因素,直接影响了产生的歌词的质量和连贯性。在增加批处理大小和扩展序列长度有望增强模型性能的同时,很明显,还有一个饱和点,超出该点的效果受到限制。通过此探索,本文旨在揭开模型校准的复杂世界,并强调战略参数选择在追求抒情卓越方面的重要性。
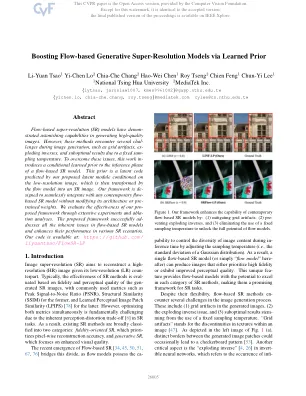
通过学习的先验
基于流量的超分辨率(SR)模型在生成高质量图像方面具有令人惊讶的功能。然而,这些方法在图像产生过程中遇到了几个challenges,例如网格伪像,进行倒置和由于固定的Sam固定温度而导致的次优结果。为了克服这些问题,这项工作涉及基于流量SR模型的推断阶段之前学到的条件。此先验是我们所提出的潜在模块预测的潜在代码,该模块在低分辨率图像上进行了条件,然后将流量模型转换为SR图像。我们的框架被签署为与任何基于当代流量的SR模型无缝集成,而无需修改其体系结构或经过预先训练的权重。我们通过广泛的实验和ABLATION分析来评估我们提出的框架的有效性。所提出的框架成功地为所有固有的问题结合了基于流的SR模型,并在各种SR场景中提高了其性能。我们的代码可在以下网址提供:https://github.com/ liyuantsao/flowsr-lp
图像denoising和光子的生成积累
我们对射击噪声损坏的图像和删除噪声的镜头提出了新的视角。通过将图像形成视为光子在检测器网格上的顺序积累,我们表明,经过训练的网络可以预测下一个光子可能到达的位置,实际上可以解决最小均方形误差(MMSE)denoising任务。这种新观点使我们能够做出三个贡献:i。我们提出了一种新的策略,用于自我监督的denoisis,ii。我们提出了一种通过迭代采样并将少量光子添加到图像中的溶液后部采样的新方法。iii。我们通过从空画布启动此过程来得出一个完整的生成模型。我们称这种方法的生成积累(GAP)。我们在4个新的荧光显微镜数据集上进行定量和定性评估我们的方法,该数据将可供社区提供。我们发现它的表现优于其基准或在PAR上执行。

基于图的蛋白质设计的生成模型
工程蛋白质有可能解决生物医学、能源和材料科学中的许多问题,但在实践中创造出成功的设计却很困难。这一挑战的一个重要方面是蛋白质序列和三维结构之间的复杂耦合,而找到一种可行设计的任务通常被称为逆蛋白质折叠问题。在这项工作中,我们引入了一种基于图形表示的给定三维结构的蛋白质序列条件生成模型。我们的方法通过关注那些在序列中是长距离但在三维空间中是局部的蛋白质,有效地捕捉蛋白质中复杂的依赖关系。这种基于图的方法在速度和可靠性方面都比传统和其他基于神经网络的方法有所提高,并借助深度生成模型向快速和有针对性的生物分子设计迈出了一步。
生成AI支持的上下文个性化...
培养学生对学习的兴趣被认为具有许多积极的下游效果。大型语言模型已经开辟了新的范围,以生成满足自己利益的内容,但目前尚不清楚这种自定义的方式在多大程度上可以对学习产生积极的效率。为了探索这个新颖的维度,我们进行了一项受试者间研究(n = 272),其具有生成的AI词汇学习应用程序的不同变化,使用户可以个性化他们的学习示例。参与者被随机分配给对照(句子来自先前存在的文本)或实验条件(根据用户的文本输入而生成的sen tence或短篇小说)。虽然我们没有观察到结构之间的学习绩效的不同,但分析表明,生成的AI驱动的环境个性化的个性化阳性的学习动机。我们不知道这些结果与以前的fndings有何关系,并强调了它们对使用生成AI进行个性化学习的新兴费用的意义。
生成AI大师班 - 模型风险管理-H2O.AI
大型语言模型的最新进展也在模型可解释性方面带来了新的挑战。生成模型产生新颖的内容,通常与单个正确的答案不符,因此仅确定结果的准确性比监督机器学习更为复杂。此外,可以根据语气,毒性,准确性,公平性,隐私保存以及其他可能在监督学习中具有模拟的指标来量化文本输出。我将比较监督学习的模型可解释性与可用于理解大语言模型的方法。

引用Mitzenmacher,迈克尔。 2001年。幂定律和对数正态分布的生成模型的简要历史。哈佛计算机科学集团T
使用条款本文从哈佛大学的DASH存储库下载,并根据适用于其他已发布材料(LAA)的条款和条件提供,如https://harvardwiki.atlassian.net/wiki/wiki/wiki/wiki/wiki/wiki/wiki/wiki/wiki/wiki/ngy/ngy/ngy5ngy5ndnde4zjgzndnde4zjgzntc5ndndndgizzmgizzmgizzmgizzmgizzmgizzmgizzmgizzmgizzmgizzmgizzmgizzmgizzmgizzmgizzmgizzmgiamsfyytytewy

通过准确率和召回率评估生成模型
生成模型的最新进展引起了人们对统计差异作为模型比较手段的研究兴趣。常用的评估方法,例如 Fréchet 初始距离 (FID),与样本的感知质量有很好的相关性,并且对模式下降很敏感。然而,这些指标无法区分不同的失败案例,因为它们只产生一维分数。我们提出了一种新的分布精度和召回率定义,将差异分解为两个独立的维度。所提出的概念直观,保留了理想的属性,并自然而然地产生了一种可用于评估生成模型的有效算法。我们将这个概念与总变异以及最近的评估指标(如初始分数和 FID)联系起来。为了证明所提出方法的实用性,我们对生成对抗网络和变分自动编码器的几种变体进行了实证研究。在大量实验中,我们表明所提出的指标能够将生成样本的质量与目标分布的覆盖范围区分开来。

未来的趋势和前景:生成AI与供应链中新兴技术的交集
总而言之,生成AI与新兴技术的整合为供应链管理的未来带来了令人兴奋的前景。通过利用生成AI,机器人技术,物联网,边缘计算和其他新兴技术之间的协同作用,组织可以在日益复杂且动态的商业环境中解锁创新,效率和弹性的新机会。但是,意识到这些技术的全部潜力需要战略投资,协作以及供应链管理的前瞻性方法。