
XiaoMi-AI文件搜索系统
World File Search SystemHIN
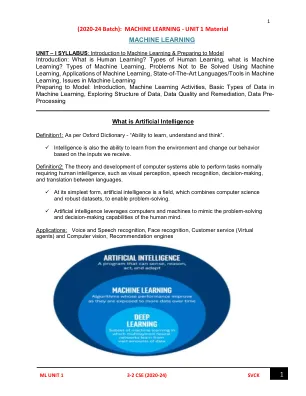
(2020-24批次):机器学习 - 单元1材料
回归是预测连续价值的过程。我们可以使用回归方法来预测使用其他一些变量的连续值,例如CAR模型的CO2发射。例如,让我们假设我们可以访问包含与来自不同汽车的CO2排放相关的数据的数据集。数据集包含诸如汽车发动机尺寸,气缸数,燃油消耗量和来自各种汽车型号的CO2排放之类的属性。现在,我们有兴趣估计其生产后新车模型的近似CO2发射。使用机器学习回归模型这是可能的。在回归中,有两种类型的变量:一个因变量和一个或多个自变量。因变量是我们研究和尝试预测的“状态”,“目标”或“最终目标”,而自变量(也称为解释变量)是这些“状态”的“原因”。自变量通常通过x显示,并且因变量用y表示。回归模型将y或因变量与x的函数相关联,即自变量。回归的关键点是因变量值应该是连续的,而不是离散值。但是,可以在分类或连续测量量表上测量自变量或变量。回归的类型:基本上,回归模型有两种类型:简单回归和多重回归。简单回归是当使用一个自变量来估计因变量时。它可以在非线性上是线性的。例如,使用“汽车的发动机尺寸”预测CO2排放。回归的线性基于自变量和因变量之间关系的性质。存在多个自变量时,该过程称为多个线性回归。例如,使用变量“汽车的发动机尺寸”和“汽车中存在的气缸数”来预测CO2排放。再次取决于因变量和自变量之间的关系,多个线性回归可以是线性或非线性回归。

建立机器人战争专家NAVADMIN 036/24 | 评级建立 - 事实说明书 | 评级转换 - 事实说明书
制服政策和计划更新 - 2024 年 2 月 NAVADMIN 031/24 | 情况说明书 本 NAVADMIN 宣布了海军制服政策的更新。这些更新是根据水手的反馈、指挥部赞助的请求和海军领导层的指示得出的。政策更新包括授权将手放在制服口袋和体能训练服的紧身裤中,以及恢复女性可选的晚礼服头饰和女性可选的组合罩(桶形)。正在进行的举措包括继续为怀孕水手提供免费制服的产妇试点计划、尺寸现代化计划和制服调查。阅读 NAVADMIN 031/24 以获取完整的更新列表。战士的坚韧,锻炼你的思想、身体和精神

第 38 届热疗医学学会年会 打破思维局限
热医学学会第 38 届年会将提供一个平台,展示医学、工程、物理学、材料科学、生物学和免疫学背景下我们对热医学不断扩展的理解的最新数据、概念和突破。主题演讲和全体会议发言人将重点介绍热医学的临床应用、肿瘤免疫学、物理学、生物学、成像和热状态之间的广泛联系。国际思想领袖将主持分组会议,讨论以下问题:
引言和类型的机器学习
为人工智能中学习的基本学习类型提供全面的理解,并在监督和无监督的学习之间划定。本章旨在向读者介绍这些学习范式的核心概念和方法,包括分类概述,并解释不同数据集的重要性,例如培训,测试和验证在AI模型的开发中。此外,本章将解决模型培训中的共同挑战,尤其是过度拟合和不足,并讨论减轻这些问题的策略。目标是为读者提供有效应用这些概念在AI的各种应用中的知识。

人工智能与机器学习
评估 ML 算法的性能 UNIT - I:简介:AI 问题、代理和环境、代理结构、问题解决代理基本搜索策略:问题空间、无信息搜索(广度优先、深度优先搜索、深度优先与迭代深化)、启发式搜索(爬山法、通用最佳优先、A*)、约束满足(回溯、局部搜索) UNIT - II:高级搜索:构建搜索树、随机搜索、AO* 搜索实现、极小极大搜索、Alpha-Beta 剪枝基本知识表示和推理:命题逻辑、一阶逻辑、前向链接和后向链接、概率推理简介、贝叶斯定理 UNIT - III:机器学习:简介。机器学习系统,学习形式:监督学习和无监督学习,强化 – 学习理论 – 学习可行性 – 数据准备 – 训练与测试和拆分。第四单元:监督学习:回归:线性回归、多元线性回归、多项式回归、逻辑回归、非线性回归、模型评估方法。分类:支持向量机 (SVM)、朴素贝叶斯分类

杰西卡·罗森沃塞尔主席在 2024 年 3 月 18 日于华盛顿特区举行的卫星行业协会第 25 届年度领导力晚宴上的致辞
25 年前,当你们刚刚起步时,并不是所有科技界人士都在关注太空。事实上,我们中的许多人都在低头研究计算机代码,修复遗留程序,以便能够避免迫在眉睫的千年虫问题。还记得吗?但 25 年前,你们看到了不断发展的太空经济的一些东西,并决定是时候组织起来了。这一年,卡纳维拉尔角 41 号发射台,许多军用卫星的发射场,摇摇欲坠。但新的商用火箭升空,当宇航员在哈勃太空望远镜上安装陀螺仪时,太空维修取得了飞跃。25 年前,我们还创造了一个重大的第一次,宇航员艾琳·柯林斯成为第一位领导地球轨道飞行器的女性。25 年前,我接受了第一份联邦通信委员会办公桌上的工作,这虽然没有那么重要。但现在,25 年过去了,我是该机构历史上第一位被确认领导的女性。

教授关键的人工智能素养
2010 年代,人工智能研究重新回到公众讨论中,当时“深度学习”领域的许多创新成为可能——这主要是因为人类生成的数据在互联网和联网设备上以前所未有的规模可用。大约在同一时间,这些技术开始为语音助手、推荐系统和自动驾驶辅助等广泛应用提供支持。当技术人员谈到“深度学习”(DL)时,它是一种“机器学习”(ML),所讨论的学习表示计算机模型能够“优化”有用的预测,同时通过更新一组复杂的统计计算中的权重来“训练”数据。由于 DL 涉及的非常大的模型中有多个计算层,因此学习是深度的。

关于在地球科学中使用监督机器学习使用的定量分析
地球科学中标记的培训数据的可用性反映在监督分析中使用的训练数据数量中。除了上述10年的分析外,我们还从2018 - 2019年的AGU论文中手动提取了其他相关信息,包括应用的ML算法,标记的培训数据的数量和数据类型(模型输出,卫星,原位,原位,重新分析等)。在我们调查的论文中,大多数ML算法是使用数百个标记样品培训的。但是,对于使用模型输出或大型,已建立的数据集的某些应用程序,培训数据的数量范围更大。缺乏训练数据在生物学科学和陆地水圈(水文)研究中尤其急切。

人工智能与机器学习 B.TECH 学费结构
学费 40000 40000 45000 65000 40000 45000 65000 40000 45000 65000 40000 45000 65000 40000 45000 技能型增值培训费 5000 5000 5000 5000 5000 5000 5000 5000 5000 5000 毕业典礼费 2000 学期费 70000 45000 50000 70000 45000 50000 70000 45000 50000 70000 45000 52000 年费