
XiaoMi-AI文件搜索系统
World File Search SystemIntera

第 1 章 交互系统 - 开普敦大学
背景 ................................................................................................................................ 1 目标 ................................................................................................................................ 2 交互系统 .............................................................................................................................. 2 过去 .............................................................................................................................. 2 现在 .............................................................................................................................. 2 未来 .............................................................................................................................. 3 实用性和可用性 ............................................................................................................. 4 实用性 ............................................................................................................................. 4 可用性 ............................................................................................................................. 4 为什么 HCI 很重要? ............................................................................................................. 5 生产力 ............................................................................................................................. 5 生活质量 ............................................................................................................................. 5 安全关键系统

分布式认知:迈向人机交互研究的新基础
我们正在快速经历一个历史时刻:人们在一台计算机前工作,由一台小型 CRT 控制,专注于仅涉及本地信息的任务。联网计算机变得无处不在,在我们的生活中以及科学、商业和社会互动的基础设施中发挥着越来越重要的作用。为了在新千年推动人机交互的发展,我们需要更好地理解新兴的交互动态,其中焦点任务不再局限于桌面,而是延伸到一个复杂的网络信息世界和计算机介导的交互。我们认为分布式认知理论在理解人与技术之间的交互方面发挥着特殊的作用,因为它的重点一直是整个环境:我们在其中真正做什么以及我们如何协调其中的活动。分布式认知为如何思考设计和支持人机交互提供了彻底的重新定位。作为一种理论,它专门用于理解人与技术之间的交互。在本文中,我们提出分布式认知作为人机交互的新基础,勾勒出一个综合的研究框架,并使用我们早期工作中的选集来提出该框架如何为数字工作材料的设计提供新的机会。
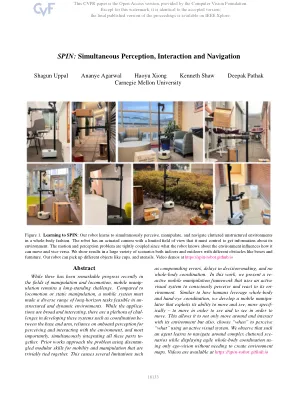
旋转:同时感知交互和导航
最近在操纵和运动领域取得了显着进展,但移动操作仍然是一个长期以来的挑战。与运动或静态操纵相比,移动系统必须在非结构化和动态环境中可行的多种长距离任务。尽管应用程序广泛且有趣,但在开发这些系统(例如基础和手臂之间的协调)时,有很多挑战,依靠在船上感知到感知和与环境互动,最重要的是,同时整合了所有这些部分。先前的作品使用模块化技能来解决问题,以使其动机和操纵被微不足道地捆绑在一起。这引起了多个限制
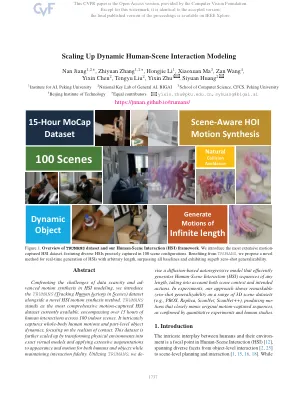
扩展动态的人类场景相互作用建模
已经取得了显着的迈进,该领域显然是由于缺乏高质量数据集而导致的。早期数据集(如Pigraphs [39]和Prox [16])启动了探索,但受到可扩展性和数据质量的约束。MOCAP数据集[14,30]使用Vicon等复杂的设备优先考虑高质量的人类运动限制。但是,他们通常缺乏捕获多样化和沉浸式的HSI。通过RGBD视频录制的可扩展数据集提供了更广泛的实用程序,但受到人类姿势和对象跟踪质量较低的阻碍。合成数据集的出现[1,3,4,55]提供了成本效率和适应性,但无法封装完整的现实HSI频谱,尤其是在捕获动态3D触点和对象跟踪时。为了应对这些挑战,这项工作首先引入了trumans(t rack hum a um a u u u u u u u u u u u u u u a ctio n s in s cenes)数据集。Trumans成为最广泛的运动捕获HSI数据集,涵盖了15个小时以上15个小时的室内场景中的各种相互作用。它捕获了全身的人类动作和部分级别的对象动力学,重点是接触的现实主义。通过将物理环境复制到准确的虚拟模型中,可以进一步增强此数据集。外观和运动的广泛增强都应用于人类和物体,以确保相互作用的高度有限。接下来,我们设计了一个计算模型,通过将场景和动作作为条件同时采取行动来应对上述挑战。我们对杜鲁士数据集和运动合成方法进行了全面的交叉评估。特别是,我们的模型采用自回归的条件扩散,场景和动作嵌入作为征用输入,能够产生任意长度的运动。为了整合场景上下文,我们通过在本地化的基础上查询全局场景的占用来开发有效的场景感知者,这在导航杂乱的场景时表现出了3D感知的碰撞避免的强大效率。为了将框架的动作标签合并为条件,我们将时间特征集成到动作片段中,使模型在粘附在给定的动作标签时随时接受指令。场景和动作条件的这种双重整合增强了我们方法的可控性,为在3D场景中合成合理的长期运动提供了细微的界面。将trumans与现有人物进行比较,我们证明了杜鲁士人明显提高了最先进的方法的性能。此外,我们的方法在定性和定量上进行了评估,超过了现有的运动综合方法,其质量和零击性能力在看不见的3D场景上,非常接近原始运动捕获数据的质量。除了运动合成之外,杜鲁士人已经针对人类的姿势和接触估计任务进行了基准测试,证明了其多功能性并将其确立为一系列未来的研究努力的宝贵资产。

植物 - 感染真菌相互作用
1植物医疗系,安登国立大学,安东斯36729,大韩民国; smvahsan@gmail.com 2 Applied Biosciences,Kyungpook国立大学,Daegu 41566,大韩民国; inmamumrassel@gmail.com(m.i.-u.-h.); ashim@knu.ac.kr(a.k.d.)3植物与土壤科学系,美国德克萨斯州科技大学基因组学研究所,德克萨斯理工大学,德克萨斯州拉伯克,美国德克萨斯州79409; mrahman@bsmrau.edu.bd 4 4602,杜姆基杜姆基Patuakhali科学技术大学昆虫学系8602; mahiimam@pstu.ac.bd 5 5 Kumho Life Science Laboratory,Chonnam国立大学,Gwangju 61186,大韩民国; ncpaulcnu@gmail.com 6大加工大学大麻生物技术学院,朝鲜共和国安东斯36729 *通信:hwchoi@anu@anu.ac.kr3植物与土壤科学系,美国德克萨斯州科技大学基因组学研究所,德克萨斯理工大学,德克萨斯州拉伯克,美国德克萨斯州79409; mrahman@bsmrau.edu.bd 4 4602,杜姆基杜姆基Patuakhali科学技术大学昆虫学系8602; mahiimam@pstu.ac.bd 5 5 Kumho Life Science Laboratory,Chonnam国立大学,Gwangju 61186,大韩民国; ncpaulcnu@gmail.com 6大加工大学大麻生物技术学院,朝鲜共和国安东斯36729 *通信:hwchoi@anu@anu.ac.kr
您说话时开车:在自动驾驶汽车中启用与大语言模型的人类互动
自动驾驶汽车的未来在于以人为中心的设计和先进的AI Capabilies。未来的自动驾驶汽车不仅会跨乘客,而且还将互动并适应他们的欲望,从而使旅程变得舒适,有效且令人愉悦。在本文中,我们提出了一个新颖的框架,该框架利用大型语言模型(LLMS)来增强自动驾驶汽车的决策过程。通过整合LLMS的自然语言能力和上下文理解,专业工具使用,协同推理,并与自动驾驶汽车的各种模块进行作用,该框架旨在将LLMS的先进语言和推理能力无缝整合到自动驾驶中。拟议的框架具有革新自动驾驶汽车运行方式,提供个性化援助,持续学习和透明决策的潜力,最终为更安全,更有效的自动驾驶技术做出了贡献。

AI和Human-AI互动医学和医疗保健
“ AI的准确而复杂的图片(与其流行的描述竞争)在开始时,由于难以钉住人工智能的精确定义而受到阻碍。……奇怪的是,缺乏精确的,普遍接受的人工智能定义可能帮助该领域以不断加剧的速度发展,开花和前进。AI的从业人员,研究人员和开发人员的指导下是一种粗略的方向感,并且必须“继续下去”。尽管如此,定义仍然很重要,而尼尔斯·尼尔森(Nils J. Nilsson)提供了一个有用的定义:“人工智能是致力于使机器变得聪明的活动,而智能是使实体能够在其环境中适当和远见的质量。” [1]” [2]

LGA -PLN -001_CRUISE AV(BOLT) - 执法互动计划-05.2024
Cruise AV的标志是其安全的硬件传感器套件,在外部可见。传感器套件不会在外部共享信息,不会通过云数据处理来跟踪或以任何身份保留第三方。这种传感器阵列使Cruise AV能够收集有关其环境的信息并告知系统的驾驶决策。在AV的后备箱内是组成系统“大脑”的计算机,并迅速综合了硬件套件收集的信息,以通过感知(了解环境),预测(评估给定环境的可能的安全路径或轨迹)和控制驾驶(驾驶驾驶员)(评估可能的安全路径或轨迹)。有关巡航自主系统如何工作的更多信息,并在此处的2022 Cruise安全报告中提供了一个安全的驾驶员。
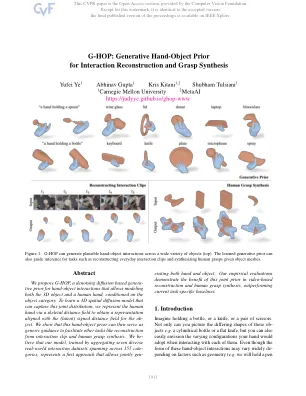
g-hop:相互作用重建的生成性手动对象和掌握合成
和一个锅的不同)或意图(例如通过刀与使用它进行切割),我们人类可以毫不费力地描绘出与日常生活中日常物体的这种互动。在这项工作中,我们的目标是构建一个可以同样生成合理的手动配置的计算系统。具体来说,我们学习了一个基于扩散的常规模型,该模型捕获了3D相互作用期间手和对象的关节分布。给定一个类别的描述,例如“握着板的手”,我们的生成模型可以合成人手的相对配置和表达(见图1个顶部)。我们解决的一个关键问题是,该模型是什么好的HOI表示。通常通过空间(签名)距离场来描述对象形状,但人的手通常是通过由发音变量控制的参数网格建模的。我们提出了一个均匀的HOI表示,而不是在生成模型中对这些不同的代表进行建模,并表明这允许学习一个共同生成手和对象的3D扩散模型。除了能够合成各种合理的手和物体形状的综合外,我们的扩散模型还可以在跨任务的辅助推理之前作为通用,而这种表示是所需的输出。例如,重建或预测相互作用的问题对于旨在向人类学习的机器人或试图帮助他们的虚拟助手来说是核心重要性。重建的视频重新投影错误)或约束(例如我们考虑了这些行沿着这些行的两个经过深入研究的任务:i)从日常交互剪辑中重建3D手对象形状,ii)鉴于任意对象网格,合成了合理的人类grasps。为了利用学到的生成模型作为推论的先验,我们注意到我们的扩散模型允许在任何手动对象配置给定的(近似)log-likelihood梯度计算(近似)log-likelihoodhoodhood。我们将其纳入优化框架中,该框架结合了先前的基于可能性的指南与特定于任务的目标(例如已知对象网格的合成)推理。虽然理解手动相互作用是一个非常流行的研究领域,但现实世界中的数据集限制了3D中这种相互作用的限制仍然很少。因此,我们汇总了7种不同的现实世界交互数据集,从而导致157个对象类别的相互作用长期收集,并在这些范围内训练共享模型。据我们所知,我们的工作代表了第一个可以共同生成手和对象的生成模型,并且我们表明它允许综合跨类别的各种手动相互作用。此外,我们还经验评估了基于视频的重建和人类掌握合成的任务的先前指导的推断,并发现我们所学的先验可以帮助完成这两个任务,甚至可以改善特定于特定于任务的状态方法。

类比设计中人与人工智能的交互协同创造力
简介 十一年前,马希尔 (Maher) 问道:“谁在创造?” (Maher 2012),并提出了几个创造性应用的分析空间,包括构思和互动两个维度。马希尔的问题引出了乔丹诺斯 (Jordanous) 的 PPP 视角框架,其中创造行为可以由人类或人工智能 (Jordanous 2016) 执行,以及坎托萨洛 (Kantosalo) 和塔卡拉 (Takala) 的 5C 框架,其中创造行为由人类和人工智能共同组成的集体执行 (Kantosalo and Takala 2020)。1然而,对于人与人工智能互动中创造力的位置,人们的共识较少。混合主动性创造性界面方法提出了一组基本的细粒度活动,这些活动可以由人类或人工智能以某种结构化对话的形式执行(Deterding 等人,2017 年;Spoto 和 Oleynik,2017 年),随后扩展到生成应用(Muller、Weisz 和 Geyer,2020 年),针对特定算法方法进行了改进(Grabe、Duque 和 Zhu,2022 年),并针对其他算法方法进行了批评(Zheng,2023 年)。虽然这些方法生成了重叠的分析动作词汇,但它们并没有解决创造力在何处发生(以及由谁或什么通过这些动作发生)的问题。在这篇短文中,我们提供了对该问题的一个答案的几个例子。我们重新利用 Kantosalo 和 Takala (2020) 的 5C 中的集体概念,提出一种类型的创造力可能会在以下互动空间中不对称地出现 (Rezwana and Maher 2022)