
XiaoMi-AI文件搜索系统
World File Search SystemInterac
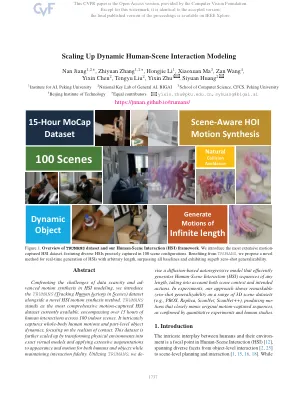
扩展动态的人类场景相互作用建模
已经取得了显着的迈进,该领域显然是由于缺乏高质量数据集而导致的。早期数据集(如Pigraphs [39]和Prox [16])启动了探索,但受到可扩展性和数据质量的约束。MOCAP数据集[14,30]使用Vicon等复杂的设备优先考虑高质量的人类运动限制。但是,他们通常缺乏捕获多样化和沉浸式的HSI。通过RGBD视频录制的可扩展数据集提供了更广泛的实用程序,但受到人类姿势和对象跟踪质量较低的阻碍。合成数据集的出现[1,3,4,55]提供了成本效率和适应性,但无法封装完整的现实HSI频谱,尤其是在捕获动态3D触点和对象跟踪时。为了应对这些挑战,这项工作首先引入了trumans(t rack hum a um a u u u u u u u u u u u u u u a ctio n s in s cenes)数据集。Trumans成为最广泛的运动捕获HSI数据集,涵盖了15个小时以上15个小时的室内场景中的各种相互作用。它捕获了全身的人类动作和部分级别的对象动力学,重点是接触的现实主义。通过将物理环境复制到准确的虚拟模型中,可以进一步增强此数据集。外观和运动的广泛增强都应用于人类和物体,以确保相互作用的高度有限。接下来,我们设计了一个计算模型,通过将场景和动作作为条件同时采取行动来应对上述挑战。我们对杜鲁士数据集和运动合成方法进行了全面的交叉评估。特别是,我们的模型采用自回归的条件扩散,场景和动作嵌入作为征用输入,能够产生任意长度的运动。为了整合场景上下文,我们通过在本地化的基础上查询全局场景的占用来开发有效的场景感知者,这在导航杂乱的场景时表现出了3D感知的碰撞避免的强大效率。为了将框架的动作标签合并为条件,我们将时间特征集成到动作片段中,使模型在粘附在给定的动作标签时随时接受指令。场景和动作条件的这种双重整合增强了我们方法的可控性,为在3D场景中合成合理的长期运动提供了细微的界面。将trumans与现有人物进行比较,我们证明了杜鲁士人明显提高了最先进的方法的性能。此外,我们的方法在定性和定量上进行了评估,超过了现有的运动综合方法,其质量和零击性能力在看不见的3D场景上,非常接近原始运动捕获数据的质量。除了运动合成之外,杜鲁士人已经针对人类的姿势和接触估计任务进行了基准测试,证明了其多功能性并将其确立为一系列未来的研究努力的宝贵资产。

通过交互式3D代创建想要的东西
最近进步[20,29,30]中的2D图像结构,以方法为例,例如在广泛的文本图像配对数据集中受过训练的扩散模型(例如,Laion-series [31]),在与文本提示符的一致性图像中取得了显着的前进。尽管取得了成功,但实现对图像产生的精确控制以满足复杂的用户期望仍然是严重的挑战。ControlNET [38]通过在特定条件数据集上进行微调修改Foun-odation-2D扩散模型来解决此问题,从而提供由用户特异性输入引导的微妙控制机制。另一方面,尽管有希望的进展[27,35],但与2D图像生成中遇到的那些相比,3D对象的生成更为复杂。al-尽管从透视感中观察到了进步,包括直接3D数据集[10,25]上的3D扩散模型,以及将2D扩散率提升到3D复位(例如NERF [21])通过SDS损失的技术优化[27],没有完全对生成Ob-Ob-ob-ob-ob-jects的控制。对初始文本提示或2D参考图像的依赖严重限制了发电的可控性,并且通常会导致质量较低。文本提示缺乏准确传达复杂3D设计的特异性;尽管2D参考图像可以告知3D重建,但它们并没有捕获3D结构的完整深度,可能导致各种意外的人类。此外,基于2D图像的个性化缺乏直接3D操纵可以提供的灵活性。这些障碍表明需要采取不同的策略。实现可控制的3D发电的直接想法是将控制网络调整为3D生成。但是,该策略遇到了重大障碍:(i)3D的控制信号本质上更为复杂,这使得与2D范式相比,有条件的3D数据集对构成的3D数据集进行了挑战; (ii)3D域中没有强大的基础模型,例如2D [20]的稳定扩散,阻碍了此时开发微调技术的可能性。结果,我们倾向于

利用简单的交互进行复杂的学习
细胞自动机 (CA) 是数学的一个分支,它探索控制自主单元(称为细胞)行为的简单规则如何导致复杂的突发模式。计算领域的先驱约翰·冯·诺依曼在 CA 的发展中发挥了重要作用。尽管冯·诺依曼以现代计算机的基础架构(“冯·诺依曼架构”)而闻名,但他晚年对 CA 着迷不已。他死后出版的著作《计算机与大脑》深入探讨了他对简单、分散的规则如何产生类似于生物过程的智能行为的思考。

肿瘤微环境相互作用引导图形学习,从全切片病理图像进行人类癌症生存分析
深度学习技术的最新进展为协助病理学家从全切片病理图像(WSI)中预测患者的生存期带来了可能性。然而,大多数流行的方法仅适用于WSI中特定或随机选择的肿瘤区域中的采样斑块,这对于捕捉肿瘤与其周围微环境成分之间复杂相互作用的能力非常有限。事实上,肿瘤在异质性肿瘤微环境(TME)中得到支持和培育,详细分析TME及其与肿瘤的相关性对于深入分析癌症发展的机制具有重要意义。在本文中,我们考虑了肿瘤与其两个主要TME成分(即淋巴细胞和基质纤维化)之间的空间相互作用,并提出了一种用于人类癌症预后预测的肿瘤微环境相互作用引导图学习(TMEGL)算法。具体来说,我们首先选择不同类型的块作为节点来为每个 WSI 构建图。然后,提出了一种新颖的 TME 邻域组织引导图嵌入算法来学习可以保留其拓扑结构信息的节点表示。最后,应用门控图注意网络来捕获肿瘤与不同 TME 组件之间与生存相关的交集以进行临床结果预测。我们在来自癌症基因组图谱 (TCGA) 的三个癌症队列上测试了 TMEGL,实验结果表明 TMEGL 不仅优于现有的基于 WSI 的生存分析模型,而且对生存预测具有良好的可解释能力。

有问题的交互式媒体使用(PIMU)
青少年医学专家 Amy Sass 博士建议父母在评估孩子的媒体准备程度时问自己两个问题。首先,您是否愿意让孩子接触特定的电影、歌曲、游戏或网站,而无需持续监控或监督他们?如果不愿意,那么您的孩子还没有准备好。其次,您是否愿意回答孩子关于媒体接触可能引发的性、暴力、虐待、自毁行为或物质主义的问题?如果不愿意,那么您还没有准备好。如果您对这两个问题的回答都是“是”,那么您的孩子就到了“合适的年龄”,可以调节与相关内容的关系。

使用生成式人工智能检查用户界面对信任和交互的影响
本论文研究了不同的用户界面 (UI) 设计如何影响用户对生成式人工智能 (AI) 工具的信任。我们进行了一项实验,采用绿野仙踪方法测试了三种具有不同 ChatGPT UI 变体的工具的信任级别。来自不同学科的九名志愿大学生参加了实验。我们使用问卷来评估参与者在与每种工具交互后以及与所有工具交互后的信任感知。结果表明,参与者之间的信任水平受到生成式 AI 的 UI 设计的影响,尤其是头像设计和文本字体。尽管共享相同的文本源,但大多数参与者认为 ChatGPT 与其他工具相比最值得信赖。结果还强调了对话界面在与生成式 AI 系统建立信任方面的重要性,参与者表示更喜欢促进自然和引人入胜的交互的界面。该研究强调了 UI 对信任的重大影响,旨在鼓励对生成式 AI 更加谨慎的信任。

颠覆人机互动中的性别规范
本文介绍了一种跨性别包容的人工智能立场,即“行动人工智能”(eAI)。人工智能设计是一种体现人类文化和价值观的人类社会文化实践。不具代表性的人工智能设计可能会导致社会边缘化。第 1 节借鉴激进的行动主义,概述了具体文化实践。第 2 节探讨了跨性别如何作为一种社会文化实践与技术科学交织在一起。第 3 节重点介绍了在人工智能中机器人与人类互动的具体情况下颠覆性别规范。最后,第 4 节确定了四个道德载体:可解释性、公平性、透明度和可审计性,以便在开发性别包容的人工智能时采取跨性别包容的立场,并颠覆机器人设计中现有的性别规范。

知识表示和人类机器人互动领域知识的互动学习
本文介绍了在人机协作背景下代表,推理和交互式学习领域知识的综合体系结构。答案集Prolog是一种非单调逻辑推理范式,用于用不完整的comsense域知识来表示和理由,为任何给定目标计算计划并诊断出意外的观察。基于ASP的推理还用于指导以前未知的动作的互动学习以及编码负担能力,动作前提和效果的公理。此学习将主动探索,反应性动作执行和人类(口头)描述的输入观察以及学习的动作和公理用于后续推理。在模拟机器人上评估了架构,该机器人协助人类在室内域中。

基于药代动力学的草药 - 药物互动
摘要简介/目标。草药一直是整个人类历史上至关重要的可再生医学来源,因为大部分全球人口仍然取决于它们的健康益处。草药补充剂的日益普及引起了人们对与其他药物原位的总体安全性和潜在互动的明显关注。目的是刺激对草药 - 药物相互作用的未来研究,以及了解这种相互作用的后果的相互作用机制。方法。该审查是通过使用Google Scholar,Science Direct,Mendeley,Scopus和PubMed的数据库进行系统搜索进行的。用英语编写的出版物被使用。据报道,许多草药产品与已知的东正教药物相互作用。抑制诱导机制触发链反应,通常导致药物生物利用度,毒性或不良副作用降低。据报道,一些草药植物构成结合了CYP2C9,CYP2C19,CYP2E1和CYP3A1,以及许多其他暂时或不可逆地结合了CYP3A1。结论。这项研究是通过重申常规和定期向医生和患者提供固有危险(例如降低疗效和与Herb-Drug相互作用(HDI)相关的毒性增加)的不完善性结束的结论。草药使用者应定期建议适当使用草药补充剂,以避免在共同给药期间或联合疗法中发生不良药物相互作用的风险。在HDI中可以观察到协同作用和拮抗作用,因此需要进一步的临床前和临床经验研究来强调HDI的机制和程度。关键字:草药 - 药物相互作用,酶,药代动力学互动,传统医学,细胞色素P450通讯作者:Mary O. Ologe电子邮件:FunMiologe@yahoo.com
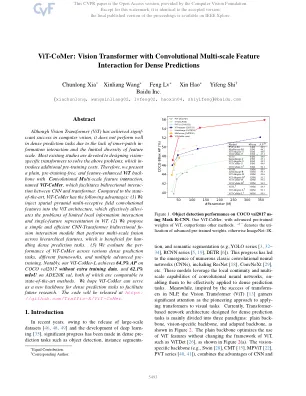
VIT-COMER:具有卷积多尺度特征相互作用的视觉变压器,用于密集预测
尽管Vision Transformer(VIT)在计算机视觉方面取得了显着的成功,但由于缺乏内部绘制互动和特征量表的多样性有限,它在密集的预测任务中表现不佳。大多数现有的研究致力于设计视觉特定的变压器来解决上述问题,从而涉及额外的培训前成本。因此,我们提出了一种普通的,无培训的且具有特征增强的vit背骨,并具有指定性的特征性动作,称为Vit-Comer,可促进CNN和Transformer之间的双向相互作用。与现状相比,VIT-COMER具有以下优点:(1)我们将空间金字塔多触发性场卷积特征注入VIT体系结构,从而有效地减轻了VIT中局部信息相互作用和单场表述的有限问题。(2)我们提出了一个简单有效的CNN转换器双向交互模块,该模块在跨层次特征上执行多尺度融合,这对Han-dling密集的预测任务有益。(3)我们评估了在各种密集的预测任务,不同框架和多个高级预训练中VIT-COMER的能力。值得注意的是,我们的VIT-COMER-L在没有额外训练数据的情况下可可Val2017上的AP达到64.3%,而ADE20K Val上的MIOU为62.1%,这两种方法都与最先进的方法相当。我们希望VIT-COMER可以作为密集预测任务的新骨干,以促进未来的研究。该代码将在https://github.com/traffic-x/vit-comer上发布。