
XiaoMi-AI文件搜索系统
World File Search SystemLan
增强具有生成负面挖掘的视觉语言模型的多模式组成推理
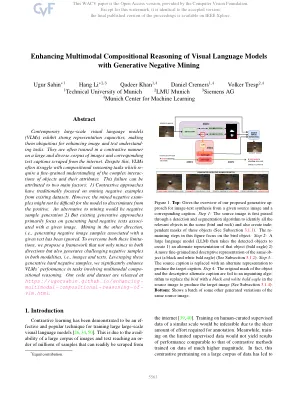
当代的大规模视觉语言模型(VLM)具有强大的表示能力,使它们无处不在,可以增强图像和文本理解任务。他们经常以对比的方式受到大量图像和相应的文本字幕的对比方式进行训练。尽管如此,VLMS经常在构图推理任务上挣扎,这些任务对对象及其属性的复杂相互作用进行了精细的了解。此失败可以归因于两个主要因素:1)对比的方法传统上专注于从现有数据集中开采负面示例。但是,该模型可能不难区分阳性检查。替代采矿的替代方法是负样本2),但现有的生成方法主要集中于生成与给定图像相关的硬性负面文本。在另一个方向上进行挖掘,即生成与给定文本相关的负面图像样本已被忽略。为了克服这两种限制,我们提出了一个框架,不仅在两个方向上矿山,而且在这两种方式(即图像和文本)中产生了有挑战性的负面样本。利用这些生成硬性负样本,我们在涉及多模式综合推理的任务中显着提高了VLMS的性能。我们的代码和数据集在https://ugorsahin.github.io/enhancing-- vlm.html上发布。


大型语言模型策略适应到处驾驶
将驾驶行为适应新的环境,库斯和法律是自主驾驶中的一个长期问题,排除了澳大利亚车辆(AVS)的广泛部署。在本文中,我们提出了LLADA,这是一种简单而强大的工具,它使人类驾驶员和自动驾驶汽车都可以通过调整其任务和动作计划来在新的地方进行访问规则,从而在任何地方开车。llada通过利用大型语言模型(LLMS)在解释本地驾驶员手册中的流量规则方面的令人印象深刻的零弹性可推广性来实现这一目标。通过广泛的用户研究,我们表明LLADA的说明可用于消除野外野外未受的情况。我们还展示了LLADA在现实世界数据集中适应AV运动计划策略的能力; Llada优于我们所有指标的基线计划。请查看我们的网站以获取更多详细信息:Llada。

Tammy Lan CV
2017年业务周刊出版物 - “抵抗原则。如何使我们更加压力和毒化”理查德·弗里贝(361页,德语至普通话)国家地理频道亚洲2015 - 2016年 - 研究,撰写,翻译,翻译和事实核对生产纪录片的脚本 div>>

语言对生物多样性很重要 - 肯特学术存储库
Robert D. Fish(R.Fish@imperial.ac.uk)隶属于杜勒尔保护与生态研究所,位于肯特大学,英国坎特伯雷,英国坎特伯雷和英国伦敦帝国学院的环境政策中心,在英国伦敦,英国,英国伦敦。 Gail E. Austen,Jacob W. Bentley,Jessica C. Fisher,Phoebe R. Bentley和Zoe G. Davies(Z.G.Davies@kent.ac.uk)隶属于迪尔雷尔保护与生态研究所,位于肯特大学,位于肯特大学,位于肯特大学的英国坎特伯里大学,在英国,英国,英国国王。 马丁·达利默(Martin Dallimer)隶属于可持续发展研究所,地球与环境学院,利兹大学,英国利兹大学,英国,英国和环境政策中心,伦敦帝国学院,英国伦敦伦敦帝国学院。 Katherine N. Irvine隶属于英国苏格兰阿伯丁市詹姆斯·赫顿学院的社会,经济和地理科学系。 Maximilian Nawrath隶属于肯特大学的杜雷尔保护与生态研究所,英国坎特伯雷,英国坎特伯雷,挪威奥斯陆的挪威水研究所。Robert D. Fish(R.Fish@imperial.ac.uk)隶属于杜勒尔保护与生态研究所,位于肯特大学,英国坎特伯雷,英国坎特伯雷和英国伦敦帝国学院的环境政策中心,在英国伦敦,英国,英国伦敦。Gail E. Austen,Jacob W. Bentley,Jessica C. Fisher,Phoebe R. Bentley和Zoe G. Davies(Z.G.Davies@kent.ac.uk)隶属于迪尔雷尔保护与生态研究所,位于肯特大学,位于肯特大学,位于肯特大学的英国坎特伯里大学,在英国,英国,英国国王。马丁·达利默(Martin Dallimer)隶属于可持续发展研究所,地球与环境学院,利兹大学,英国利兹大学,英国,英国和环境政策中心,伦敦帝国学院,英国伦敦伦敦帝国学院。Katherine N. Irvine隶属于英国苏格兰阿伯丁市詹姆斯·赫顿学院的社会,经济和地理科学系。Maximilian Nawrath隶属于肯特大学的杜雷尔保护与生态研究所,英国坎特伯雷,英国坎特伯雷,挪威奥斯陆的挪威水研究所。
视觉模型的有效测试时间适应
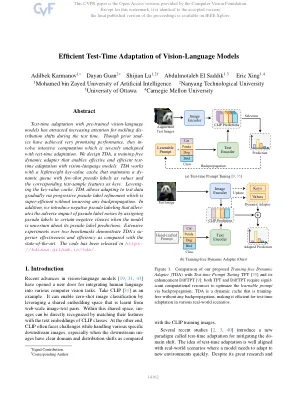
通过预训练的视觉模型进行测试时间适应,引起了越来越多的关注,以应对测试时间的分离转移。尽管事先实现了非常有前途的性能,但它们会进行密集的计算,这与测试时间适应非常不规则。我们设计了TDA,这是一种无训练的动态适配器,可通过视觉模型进行有效,有效的测试时间适应。tda可与轻巧的键值缓存一起使用,该缓存维持具有很少射击伪标签的dy-namic队列作为值,而相应的测试样本特征则是键。杠杆键值缓存,TDA允许通过渐进式伪标签的细化逐渐调整数据,而逐步测试数据,而不会产生任何反向传播。此外,我们引入了负伪标记,即当模型不确定其伪标签预测时,通过将伪标签分配给某些负类时,可以减轻伪标签噪声的不利影响。在两个基准上进行的广泛实验表明,与最先进的艺术品相比,TDA的实体有效性和效率。该代码已在https://kdiaaa.github.io/tda/中发布。
基于语料库的语言教学方法
摘要 本文综合了教师的观点、学习者产出和学习者印象的分析、材料开发的想法以及总结性研究者的观察结果,这些观察源于在美国两个大学和成人留学环境中实施为期一学期(约 8 周的教学)的基于语料库和数据驱动的英语作为第二语言 (ESL) 教学。案例研究 1 调查了学习者和教师对语料库教学在培养专门为中国访问学者群体设计的学术写作技能方面的有效性的态度。案例研究 2 采用混合方法、探索性调查,研究使用支架式学生工作表指导不同熟练程度的学习者在一所位于美国的非营利性私人机构为期一学期的留学项目中使用语料库和语料库工具的情况。该工作表旨在定期将基于语料库的课程和数据纳入课堂教学或家庭作业活动。结果表明,教师们对将语料库工具纳入自己的语言课堂教学中可能带来的巨大而有希望的好处充满热情。通过具体明确的学习目标和使用指导,语料库工具可以成为课程期间和课程结束后适合学生的宝贵资源。
大脑的三种语言:量子,重组和关联
科学进步在相应的语言发展中反映了。显微镜,望远镜,断层扫描和其他传感设备打开的远景导致了新实体和过程的命名。量子理论导致了经典原子图的统计,并且在纠结的过程和非二元逻辑方面说话。量子理论还导致了与观察者定义和观察者的定义有关的深刻问题。这是检查心灵之谜的一条途径。其他路径源于古老的哲学传统和过去世纪的心理理论。在科学话语中描述思维的语言并没有与物理科学的发展保持同步。主流讨论已从早期的二元模型的共同信念模型转变为一种基于平行计算机式大脑过程的复杂性的思维的出现。有时以分离和相互联系的方式表达的确定性和自主权的两个旧范式以各种形式出现。其中两个是有利的,取决于研究领域和现行时尚。尽管量子理论为物理科学提供了70年的基础,但直到最近才考虑了整体,类似大脑的量子样操作。这种新鲜的外观是由各种人工智能(AI)项目以及新的分析和实验发现所带来的挫折引起的。机械科学的兴起看到了概念 -人们认识到,诸如“驱动器”之类的刺激反应结构通常不足以提供解释。并且有人援引“ e o o o o o t”类别来解释自治行为。卡尔·普里布拉姆(Karl Pribram)的大脑经典语言(1971)描述了用于描述大脑行为的标准语言和逻辑类别中的许多悖论。自写了这本书以来,已经尝试并发现许多新方法要解决这些悖论。用来描述大脑运作的语言是按照年龄的主要科学范式建模的。
精确:基于事件的行动识别和更多
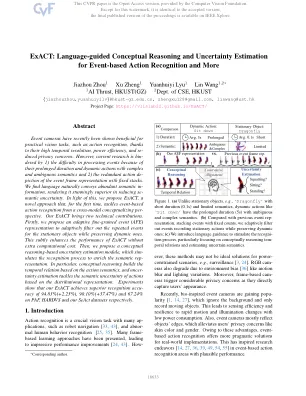
事件摄像机最近显示出对实用视觉任务的有益,例如行动识别,这要归功于其高度分辨率,功率效率和引起的隐私问题。然而,当前的研究是由1)处理事件的困难,因为它们的持续时间长时间和动态动作具有复杂而模棱两可的语义; 2)事件框架表示带有固定堆栈的冗余作用。我们发现语言自然传达了丰富的语义信息,从而使其在降低疾病的不确定性方面非常出色。鉴于此,我们提出了一种新颖的方法,这是第一次解决基于事件的动作识别的跨模式概念化的识别。我们的确切确切带来了两项技术贡献。首先,我们提出了一个自适应细粒事件(AFE)表示,以自适应地过滤固定对象的重复事件,同时保留动态的对象。这巧妙地增强了精确的性能,而无需额外的计算成本。然后,我们提出了一个基于概念推理的不确定性估计模块,该模块模拟了识别过程以丰富语义代表。尤其是,概念推理基于动作语义建立时间关系,而不必要的估计可以解决基于分布表示的动作的语义不确定性。实验表明,在PAF,HADDV和我们的SEACT数据集上,我们的确切确切识别获得了94.83%(+2.23%),90.10%(+2.23%),90.10%(+37.47%)和67.24%。
培训计算最佳的大语言模型
Layton,D。“ Chatgpt - 我们如何到达今天的位置 - GPT开发的时间表。” https://medium.com/@dlaytonj2/chatgpt-how-we-we-got-to-wher-we-we-are-today-a-timeline-timeline-fppt-development-f7a35dcc660e(2023)。Lubbad,M。“ GPT-4参数:无限制指南NLP的游戏规则改变者。”https://mlubbad.medium.com/the-ultimate-guide-to-gpt-4-parameters-verything-nything-to-to-to-to-to-to-about-about-about-about-about-about-nlps-changer-changer-109b87678555a(2023)。Shree,P。“开放AI GPT模型的旅程。”https://medium.com/walmartglobaltech/the-journey-open-open-ai-gpt-models-32d95b7b7fb2(2020)。