
XiaoMi-AI文件搜索系统
World File Search SystemLang
培训计算最佳的大语言模型
Layton,D。“ Chatgpt - 我们如何到达今天的位置 - GPT开发的时间表。” https://medium.com/@dlaytonj2/chatgpt-how-we-we-got-to-wher-we-we-are-today-a-timeline-timeline-fppt-development-f7a35dcc660e(2023)。Lubbad,M。“ GPT-4参数:无限制指南NLP的游戏规则改变者。”https://mlubbad.medium.com/the-ultimate-guide-to-gpt-4-parameters-verything-nything-to-to-to-to-to-to-about-about-about-about-about-about-nlps-changer-changer-109b87678555a(2023)。Shree,P。“开放AI GPT模型的旅程。”https://medium.com/walmartglobaltech/the-journey-open-open-ai-gpt-models-32d95b7b7fb2(2020)。
视觉导航的体积环境表示
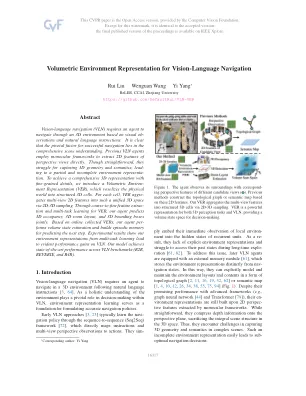
Vision语言导航(VLN)要求代理在基于视觉观察和自然语言说明的3D环境中导航。很明显,成功导航的关键因素在于全面的场景理解。以前的VLN代理使用单眼框架直接提取透视视图的2D特征。虽然很简单,但他们为捕获3D几何和语义而努力,导致部分不完整的环境代表。为了实现具有细粒细节的全面3D表示,我们引入了体积环境(VER),将物理世界脱氧于结构化的3D细胞中。对于每个单元格,通过2D-3D采样将多视图2D特征归纳到如此统一的3D空间中。通过对VER的粗略到纤维特征进行推断和多任务学习,我们的代理人可以共同预测3D占用率,3D房间布局和3D边界框。基于在线收集的vers,我们的代理构成了体积状态估计,并构建情节内存以预测下一步。实验结果表明,我们从多任务学习的环境表示导致了VLN的可观绩效提高。我们的模型在VLN基准(R2R,Reverie和R4R)之间实现了最新的性能。

大型语言模型策略适应到处驾驶
将驾驶行为适应新的环境,库斯和法律是自主驾驶中的一个长期问题,排除了澳大利亚车辆(AVS)的广泛部署。在本文中,我们提出了LLADA,这是一种简单而强大的工具,它使人类驾驶员和自动驾驶汽车都可以通过调整其任务和动作计划来在新的地方进行访问规则,从而在任何地方开车。llada通过利用大型语言模型(LLMS)在解释本地驾驶员手册中的流量规则方面的令人印象深刻的零弹性可推广性来实现这一目标。通过广泛的用户研究,我们表明LLADA的说明可用于消除野外野外未受的情况。我们还展示了LLADA在现实世界数据集中适应AV运动计划策略的能力; Llada优于我们所有指标的基线计划。请查看我们的网站以获取更多详细信息:Llada。
通过群集掩模的有效视力语言预训练
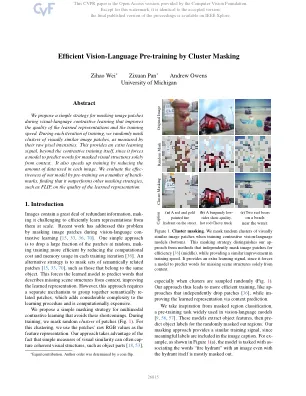
图像包含大量冗余信息,使其具有挑战性地在大规模上从它们中有效地了解它们。最近的工作通过在视觉语言构想学习期间掩盖图像贴片来解决这个问题[15,33,36,70]。一种简单的方法是随机放下大部分斑块,通过降低每个训练迭代中的计算成本和记忆使用量,从而更有效地培训训练[36]。替代策略是掩盖语义相关的贴片[15,33,70],例如属于同一对象的贴片。这迫使学习的模型预测从上下文中描述缺少场景结构的单词,从而改善了学识渊博的表示。但是,这种方法需要一种单独的机制来将语义重新贴定的补丁分组在一起,这为学习过程增加了相当大的复杂性,并且计算上很昂贵。我们提出了一种简单的掩盖策略,用于避免这些缺点的多模式对比学习。在训练期间,我们掩盖了斑块的随机簇(图1)。对于此聚类,我们将Patches的原始RGB值用作特征表示。我们的方法利用了一个事实,即视觉相似性的简单度量通常可以限制相干的视觉结构,例如对象部分[18,53],
开放式对象检测的生成区域训练
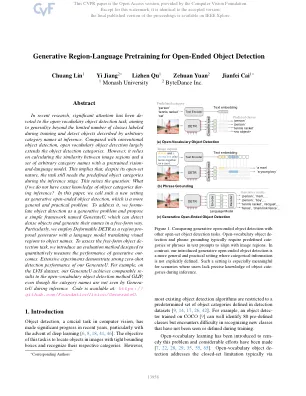
在最近的研究中,已对开放式摄制对象检测任务进行了大量关注,旨在概括训练期间标记的类别的有限级别,并检测推理时任意类别名称所描述的对象。与常规对象检测相比,打开的词汇对象检测在很大程度上扩展了对象检测类别。但是,它依赖于计算图像区域与一组具有验证视觉和语言模型的任意类别名称之间的相似性。这意味着,尽管具有开放式的性质,但该任务仍然需要在推理阶段的预定义对象类别。这提出了一个问题:如果我们在推理中对对象类别没有确切的了解,该怎么办?在本文中,我们称之为新的设置为生成性开放式对象检测,这是一个更普遍和实际的问题。为了解决它,我们将对象检测形式为生成问题,并提出了一个名为generateu的简单框架,该框架可以检测密集的对象并以自由形式的方式生成其名称。尤其是,我们采用可变形的DETR作为区域促成生成器,其语言模型将视觉区域转换为对象名称。为了评估自由形式的对象划分任务,我们介绍了一种评估方法,旨在定量测量生成量的性能。广泛的实验表明我们的生成量强烈的零射击性能。代码可在以下网址获得:https://github.com/foundationvision/generateu。例如,在LVIS数据集上,我们的GenerateU在推理过程中属于类别名称,即类别名称无法看到类别名称,即使类别名称看不见类别名称,我们的GenerateU也可以与开放式唱机对象检测方法GLIP相当。

语言对生物多样性很重要 - 肯特学术存储库
Robert D. Fish(R.Fish@imperial.ac.uk)隶属于杜勒尔保护与生态研究所,位于肯特大学,英国坎特伯雷,英国坎特伯雷和英国伦敦帝国学院的环境政策中心,在英国伦敦,英国,英国伦敦。 Gail E. Austen,Jacob W. Bentley,Jessica C. Fisher,Phoebe R. Bentley和Zoe G. Davies(Z.G.Davies@kent.ac.uk)隶属于迪尔雷尔保护与生态研究所,位于肯特大学,位于肯特大学,位于肯特大学的英国坎特伯里大学,在英国,英国,英国国王。 马丁·达利默(Martin Dallimer)隶属于可持续发展研究所,地球与环境学院,利兹大学,英国利兹大学,英国,英国和环境政策中心,伦敦帝国学院,英国伦敦伦敦帝国学院。 Katherine N. Irvine隶属于英国苏格兰阿伯丁市詹姆斯·赫顿学院的社会,经济和地理科学系。 Maximilian Nawrath隶属于肯特大学的杜雷尔保护与生态研究所,英国坎特伯雷,英国坎特伯雷,挪威奥斯陆的挪威水研究所。Robert D. Fish(R.Fish@imperial.ac.uk)隶属于杜勒尔保护与生态研究所,位于肯特大学,英国坎特伯雷,英国坎特伯雷和英国伦敦帝国学院的环境政策中心,在英国伦敦,英国,英国伦敦。Gail E. Austen,Jacob W. Bentley,Jessica C. Fisher,Phoebe R. Bentley和Zoe G. Davies(Z.G.Davies@kent.ac.uk)隶属于迪尔雷尔保护与生态研究所,位于肯特大学,位于肯特大学,位于肯特大学的英国坎特伯里大学,在英国,英国,英国国王。马丁·达利默(Martin Dallimer)隶属于可持续发展研究所,地球与环境学院,利兹大学,英国利兹大学,英国,英国和环境政策中心,伦敦帝国学院,英国伦敦伦敦帝国学院。Katherine N. Irvine隶属于英国苏格兰阿伯丁市詹姆斯·赫顿学院的社会,经济和地理科学系。Maximilian Nawrath隶属于肯特大学的杜雷尔保护与生态研究所,英国坎特伯雷,英国坎特伯雷,挪威奥斯陆的挪威水研究所。
用移动操作的交互式对象搜索语言的动态场景图
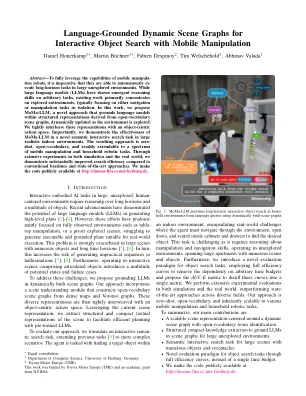
摘要 - 为了充分利用移动操纵机器人的功能,必须在大型未探索的环境中自主执行的长途任务。虽然大型语言模型(LLMS)已显示出关于任意任务的紧急推理技能,但现有的工作主要集中在探索的环境上,通常集中于孤立的导航或操纵任务。在这项工作中,我们提出了MOMA-LLM,这是一种新颖的方法,该方法将语言模型基于从开放式摄影场景图中得出的结构化表示形式,随着环境的探索而动态更新。我们将这些表示与以对象为中心的动作空间紧密地交织在一起。重要的是,我们证明了MOMA-LLM在大型现实室内环境中新型语义交互式搜索任务中的有效性。最终的方法是零拍摄,开放式摄影库,并且可以易于扩展到一系列移动操作和家用机器人任务。通过模拟和现实世界中的广泛实验,与传统的基线和最新方法相比,我们证明了搜索效率的显着提高。我们在http://moma-llm.cs.uni-freiburg.de上公开提供代码。
rila:零的反思性和想象力的语言代理...
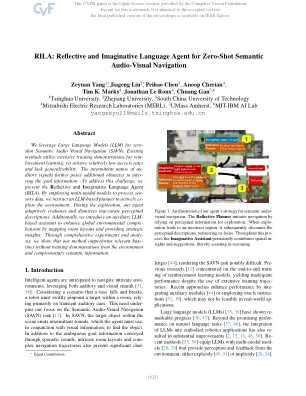
我们利用大型语言模型(LLM)进行零射击语义视听导航(SAVN)。现有的方法利用广泛的培训演示来巩固执行学习,但达到了相对较低的成功率和缺乏可普遍性。Auditary信号的间歇性质进一步构成了其他障碍,以减少目标信息。为了应对这一挑战,我们提出了Reflyception and I Maginative L Anguage A Gent(Rila)。通过采用多模式来处理SENSORY数据,我们指示基于LLM的规划师积极地展示环境。在探索过程中,我们的代理人对不准确的感知描述进行了适应性评估和驳回。此外,我们引入了辅助LLM的助手,以通过映射房间的布局并提供战略见解来增强全球环境综合。通过全面的实验和分析,我们表明我们的方法在没有环境和互补语义信息的培训演示的情况下优于相关的基线。
您说话时开车:在自动驾驶汽车中启用与大语言模型的人类互动
自动驾驶汽车的未来在于以人为中心的设计和先进的AI Capabilies。未来的自动驾驶汽车不仅会跨乘客,而且还将互动并适应他们的欲望,从而使旅程变得舒适,有效且令人愉悦。在本文中,我们提出了一个新颖的框架,该框架利用大型语言模型(LLMS)来增强自动驾驶汽车的决策过程。通过整合LLMS的自然语言能力和上下文理解,专业工具使用,协同推理,并与自动驾驶汽车的各种模块进行作用,该框架旨在将LLMS的先进语言和推理能力无缝整合到自动驾驶中。拟议的框架具有革新自动驾驶汽车运行方式,提供个性化援助,持续学习和透明决策的潜力,最终为更安全,更有效的自动驾驶技术做出了贡献。