
XiaoMi-AI文件搜索系统
World File Search SystemMultim

一种多模式的方法利用脑电图研究VR环境对心理工作负载的影响
抽象虚拟现实(VR)是一项允许用户体验模拟真实或虚构场景的多感觉和交互式环境的技术。仍然辩论了不同的VR沉浸式技术神学对心理工作量(MWL)的影响,即执行任务所需的资源数量;但是,从未利用脑电图在这种情况下的潜在作用。本文旨在调查在VR环境中对MWL进行认知任务的影响,这是通过使用多模式的方法进行的,其特征在于以不同程度的沉浸式来进行,这些方法通过生理EEG测量对MWL进行了良好评估的主观评估。提出了基于N-BACK测试的认知任务,以比较使用头部安装显示器(HMD)或桌面计算机展示Stim uli的特定裤子的性能和MWL。任务具有四个不同的复杂度(N¼1或2具有视觉或视觉和听觉刺激)。二十七名健康参与者都参加了这项研究,并在两种情况下都执行了任务。EEG数据和NASA任务负荷指数(NASA-TLX)分别用于评估客观和主观MWL的变化。 错误率(ER)和反应时间(RTS)也针对每个条件和任务水平进行了COL。 任务水平在两种情况下都对MWL产生了重大影响,增加了次级措施和降低性能。 EEG MWL指数显示出显着增加,特别是与休息相比。 不同程度的沉浸式均未显示个人的表现和MWL的显着差异,如主观评分所估计。EEG数据和NASA任务负荷指数(NASA-TLX)分别用于评估客观和主观MWL的变化。错误率(ER)和反应时间(RTS)也针对每个条件和任务水平进行了COL。任务水平在两种情况下都对MWL产生了重大影响,增加了次级措施和降低性能。EEG MWL指数显示出显着增加,特别是与休息相比。 不同程度的沉浸式均未显示个人的表现和MWL的显着差异,如主观评分所估计。EEG MWL指数显示出显着增加,特别是与休息相比。不同程度的沉浸式均未显示个人的表现和MWL的显着差异,如主观评分所估计。但是,在大多数情况下,HMD降低了EEG衍生的MWL,表明较低的认知负载。总而言之,HMD可能会减少某些任务的认知负担。如脑电图MWL指数所示,MWL的降低水平可能对基于VR的应用程序的设计和未来评估有影响。
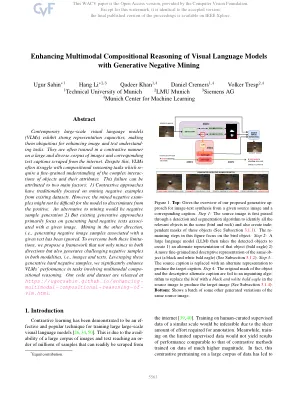
增强具有生成负面挖掘的视觉语言模型的多模式组成推理
当代的大规模视觉语言模型(VLM)具有强大的表示能力,使它们无处不在,可以增强图像和文本理解任务。他们经常以对比的方式受到大量图像和相应的文本字幕的对比方式进行训练。尽管如此,VLMS经常在构图推理任务上挣扎,这些任务对对象及其属性的复杂相互作用进行了精细的了解。此失败可以归因于两个主要因素:1)对比的方法传统上专注于从现有数据集中开采负面示例。但是,该模型可能不难区分阳性检查。替代采矿的替代方法是负样本2),但现有的生成方法主要集中于生成与给定图像相关的硬性负面文本。在另一个方向上进行挖掘,即生成与给定文本相关的负面图像样本已被忽略。为了克服这两种限制,我们提出了一个框架,不仅在两个方向上矿山,而且在这两种方式(即图像和文本)中产生了有挑战性的负面样本。利用这些生成硬性负样本,我们在涉及多模式综合推理的任务中显着提高了VLMS的性能。我们的代码和数据集在https://ugorsahin.github.io/enhancing-- vlm.html上发布。
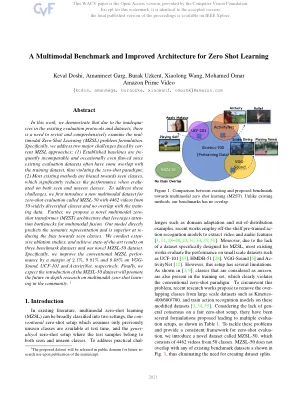
零射击学习的多模式基准和改进的体系结构
在这项工作中,我们证明,由于现有评估协议和数据集中的不足,因此有必要重新审视并全面研究Mul-timodal零射击学习(MZSL)问题问题。具体来说,我们解决了MZSL方法面临的两个主要挑战。 (1)既定基线的情况通常是无与伦比的,而且有时甚至是有缺陷的,因为现有的评估数据集通常与培训数据集有一些重叠,因此违反了零照片范式; (2)大多数现有的方法都偏向可见的类,这在对可见和看不见的类别进行评估时会大大降低性能。为了应对这些挑战,我们首先引入了一个新的多模式数据集,用于零照片评估,称为MZSL-50,其中有4462个视频来自50个广泛多元化的类别,并且与培训数据没有重叠。此外,我们提出了一种新型的多模式零射击变压器(MZST)体系结构,该体系结构利用了吸引瓶颈进行多模式融合。我们的模型可以直接预测语义表示,并且在将偏见降低到可见的类别方面表现出色。我们进行了广泛的消融研究,并在三个基准数据集和我们的新型MZSL-50数据集上实现最先进的结果。具体来说,我们提高了传统的MZSL绩效2。1%,9。81%和8。 vgg-sound,UCF-101和ActivityNet的68%。 最后,我们希望引入MZSL-50数据集将促进对社区中多模式零射击的深入研究。 181%和8。vgg-sound,UCF-101和ActivityNet的68%。最后,我们希望引入MZSL-50数据集将促进对社区中多模式零射击的深入研究。1
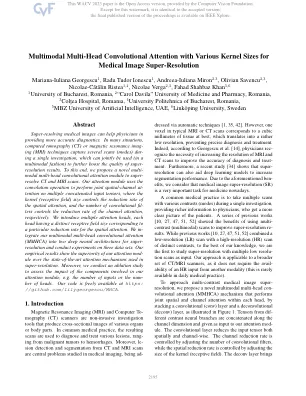
用于医学图像超分辨率的多模态多头卷积注意
超分辨率医学图像可帮助医生提供更准确的诊断。在许多情况下,计算机断层扫描 (CT) 或磁共振成像 (MRI) 技术在一次检查期间会捕获多个扫描 (模式),这些扫描 (模式) 可以联合使用 (以多模态方式) 来进一步提高超分辨率结果的质量。为此,我们提出了一种新颖的多模态多头卷积注意模块来超分辨率 CT 和 MRI 扫描。我们的注意模块使用卷积运算对多个连接的输入张量执行联合空间通道注意,其中核 (感受野) 大小控制空间注意的减少率,卷积滤波器的数量控制通道注意的减少率。我们引入了多个注意头,每个头具有不同的感受野大小,对应于空间注意的特定减少率。我们将多模态多头卷积注意力 (MMHCA) 集成到两个深度神经架构中以实现超分辨率,并对三个数据集进行了实验。我们的实证结果表明,我们的注意力模块优于超分辨率中使用的最先进的注意力机制。此外,我们进行了一项消融研究,以评估注意力模块中涉及的组件的影响,例如输入的数量或头部的数量。我们的代码可在 https://github.com/lilygeorgescu/MHCA 免费获取。
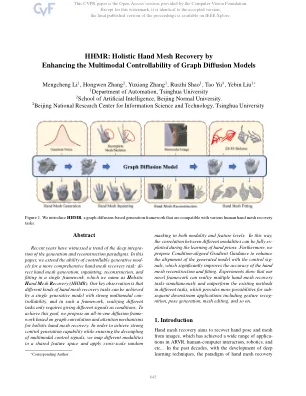
HHMR:通过增强图扩散模型的多模式可控性
近年来见证了一代和重建范式深入融合的趋势。在本文中,我们扩展了可控制的生成模块的能力,以实现更全面的手网恢复任务:在单个框架中,手工网格的生成,内部网状,重建,重建和拟合,我们将其命名为H olistic H和MESH R Ecovery(HHMR)。我们的主要观察结果是,具有强大多模式可偿还性的单个生成模型可以实现不同类型的手网恢复任务,并且在这样的框架中,实现不同的任务只需要给出不同的信号作为条件。为了实现这一目标,我们提出了基于图形卷积和整体手工网状恢复的注意力卷积和注意力机制的多合一扩散框架。为了实现强大的控制能力,同时确保多模式控制信号的解耦,我们将不同的模态映射到共享特征空间并应用跨尺度随机
通过非侵入式脑机接口和生成式人工智能辅助多模式软件记录梦境
摘要:本研究提出了一种新的梦境记录方法,该方法结合了非侵入式脑机接口 (BMI)、思维输入软件和生成式 AI 辅助多模态软件。该方法旨在将 REM 睡眠期间的意识过程升华到半意识状态,并产生用于思维输入的信号。我们概述了一个两阶段的过程:首先,使用生成式 AI 开发多模态软件来补充文本流并生成多媒体内容;其次,采用基于摩尔斯电码的打字方式来简化信号要求并提高打字速度。我们通过建议一种涉及植入 BMI 的用户的控制系统来优化非侵入式信号,从而应对非侵入式 EEG 的挑战。文献综述重点介绍了 BMI 打字、意识过程升华以及生成式 AI 在基于文本提示的思维输入方面的潜力方面的最新进展。
一种多模式的方法利用脑电图研究VR环境对心理工作负载的影响
抽象虚拟现实(VR)是一项允许用户体验模拟真实或虚构场景的多感觉和交互式环境的技术。仍然辩论了不同的VR沉浸式技术神学对心理工作量(MWL)的影响,即执行任务所需的资源数量;但是,从未利用脑电图在这种情况下的潜在作用。本文旨在调查在VR环境中对MWL进行认知任务的影响,这是通过使用多模式的方法进行的,其特征在于以不同程度的沉浸式来进行,这些方法通过生理EEG测量对MWL进行了良好评估的主观评估。提出了基于N-BACK测试的认知任务,以比较使用头部安装显示器(HMD)或桌面计算机展示Stim uli的特定裤子的性能和MWL。任务具有四个不同的复杂度(N¼1或2具有视觉或视觉和听觉刺激)。二十七名健康参与者都参加了这项研究,并在两种情况下都执行了任务。EEG数据和NASA任务负荷指数(NASA-TLX)分别用于评估客观和主观MWL的变化。 错误率(ER)和反应时间(RTS)也针对每个条件和任务水平进行了COL。 任务水平在两种情况下都对MWL产生了重大影响,增加了次级措施和降低性能。 EEG MWL指数显示出显着增加,特别是与休息相比。 不同程度的沉浸式均未显示个人的表现和MWL的显着差异,如主观评分所估计。EEG数据和NASA任务负荷指数(NASA-TLX)分别用于评估客观和主观MWL的变化。错误率(ER)和反应时间(RTS)也针对每个条件和任务水平进行了COL。任务水平在两种情况下都对MWL产生了重大影响,增加了次级措施和降低性能。EEG MWL指数显示出显着增加,特别是与休息相比。 不同程度的沉浸式均未显示个人的表现和MWL的显着差异,如主观评分所估计。EEG MWL指数显示出显着增加,特别是与休息相比。不同程度的沉浸式均未显示个人的表现和MWL的显着差异,如主观评分所估计。但是,在大多数情况下,HMD降低了EEG衍生的MWL,表明较低的认知负载。总而言之,HMD可能会减少某些任务的认知负荷。如脑电图MWL指数所示,MWL的降低水平可能对基于VR的应用程序的设计和未来评估有影响。

多模式推理的问题意识视力变压器
视觉语言(VL)模型已获得了显着的重点,从而在多模式推理方面取得了显着进步。这些体系结构通常包括视觉编码器,大型语言模型(LLM)和一个将视觉特征与LLM的代表空间保持一致的投影模块。尽管他们成功了,但仍然存在一个关键的限制:愿景编码过程仍然与用户查询相关,通常是以与图像相关的问题的形式。因此,所得的视觉特征可能无法最佳地调整图像的特定元素。为了解决这个问题,我们介绍了QA-Vit,这是一种问题的多模式原因,这是一种问题,将问题意识直接嵌入到视觉编码器中。此集成导致动态视觉特征,重点是提出问题的相关图像方面。QA-VIT是模型 - 静态的,并且可以有效地将其置于任何VL体系结构中。广泛的经验证明了将我们的方法应用于各种多模式体系结构的有效性,从而导致跨不同任务的一致改进,并展示了其以增强视觉和场景文本理解的能力。

多模态人工智能中的偏见:公平自动招聘的试验台
决策算法在社会中的存在感如今正在迅速增加,同时人们也开始担心其透明度以及这些算法可能成为新的歧视来源。事实上,许多相关的自动化系统已被证明会根据敏感信息做出决策或歧视某些社会群体(例如,某些用于人员识别的生物特征识别系统)。为了研究当前基于异构信息源的多模态算法如何受到数据中的敏感元素和内部偏见的影响,我们提出了一个虚构的自动招聘测试平台:FairCVtest。我们使用一组有意识地以性别和种族偏见进行评分的多模态合成档案来训练自动招聘算法。FairCVtest 展示了此类招聘工具背后的人工智能(AI)从非结构化数据中提取敏感信息并以不良(不公平)的方式将其与数据偏见结合起来的能力。最后,我们列出了最近开发能够从深度学习架构的决策过程中删除敏感信息的技术的列表。我们使用其中一种算法(SensitiveNets)来实验歧视感知学习,以消除我们多模态 AI 框架中的敏感信息。我们的方法和结果展示了如何生成更公平的基于 AI 的工具,特别是更公平的自动招聘系统。
ma-lmm:长期视频理解的内存大型多模型
随着大型语言模型(LLM)的成功,将视觉模型融入了LLM,以建立视觉语言基础模型最近引起了人们的兴趣。但是,现有的基于LLM的大型多模式模型(例如,视频播放,视频聊天)只能摄入有限数量的框架以进行简短的视频理解。在这项研究中,我们主要专注于设计一个有效有效的模型,以进行长期视频理解。我们建议以在线方式处理视频并将过去的视频信息存储在存储库中,而不是像大多数现有作品一样尝试同时进行更多框架。这使我们的模型可以参考历史视频内容以进行长期分析,而不会超过LLM的上下文长度约束或GPU内存限制。我们的内存库可以以现成的方式被缝制到当前的多模式LLMS中。我们在各种视频理解任务上进行了广泛的实验,例如长期介绍,视频问题答案和视频字幕,我们的模型可以在多个数据集中实现最新的性能。