
XiaoMi-AI文件搜索系统
World File Search SystemNeural

利用人工神经网络预测定向金属沉积中的高度
定向金属沉积 (DMD) 是一种很有前途的金属增材制造技术,其中零件是通过使用沿预定义轨迹移动的激光束融合注入的金属粉末颗粒来制造的。刀具路径通常包括曲线或边缘部分,机器轴需要相应地减速和加速。因此,局部施加的激光能量和粉末密度在沉积过程中会发生变化,导致局部过度沉积和过热。这些偏差还受到刀具路径几何形状和工艺持续时间的影响:先前的沉积可能会在时间和空间上影响相近的刀具路径段,导致局部热量积聚,并形成与使用相同参数沉积的其他段中产生的轮廓和微观结构不同的轮廓和微观结构,这是由于几何形状和温度相关的集水轮廓所致。为了防止这些现象,需要轻量级和可扩展的模型来预测可变刀具路径的工艺行为。在本文中,我们提出了一种基于人工智能的方法来处理 Inconel 718 的工艺复杂性和多种刀具路径变化。考虑到先前定义的刀具路径,使用人工神经网络 (ANN) 来预测沉积高度。通过打印包含多个曲率和几何形状的随机刀具路径,生成了训练数据。基于训练后的模型,可以成功预测整个刀具路径的显著局部几何偏差,并且可以通过相应地调整工艺参数来预测。

图像、GMTI 和信息融合的神经方法 - DTIC
根据 JDL 数据融合组过程模型,在 0、1、2 和 2+/3 级进行数据和信息融合。为了支持多传感器 IMINT 和 GMTI 融合和 3D 可视化,我们构建了阿拉巴马州莫比尔码头和周边地区的 3D 站点模型,该模型允许使用我们现有的图像挖掘工具进行搜索,并提供 COP 环境,可以在其中模拟和可视化场景。我们开发了用于模拟交通和编写单个车辆移动脚本的软件,以支持场景创建。我们探索了几个新概念来支持 2+/3 级的更高级别的信息融合。一种方法源于对动态脉冲信息网络及其同步形式的神经处理的洞察。这些网络可以以关系和学习到的关联的形式绑定数据和语义知识。我们证明了使用这些网络在移动数据集中学习动态城市场景中移动车辆之间的简单关联的可行性。第二种方法涉及从图像和/或文本数据中提取知识结构。我们开发了两种从数据集中的概念共现中发现分类法的机制。我们证明了这些方法对融合图像和文本语料库的有效性。最后一种方法利用神经启发机制从移动的跟踪实体中学习正常行为模型。这些模型随后被使用
通过图卷积和可逆神经网络对潜在空间中的点云进行去噪
点云经常包含噪声和异常值,为下游应用带来障碍。在本文中,我们介绍了一种新颖的点云去噪方法。通过利用潜在空间,我们明确地发现噪声成分,从而可以提取干净的潜在代码。这反过来又有助于通过逆变换恢复干净点。我们网络中的一个关键组件是一个新的多层图卷积网络,用于捕获从局部到全局各个尺度的丰富几何结构特征。然后将这些特征集成到可逆神经网络中,该网络双射映射潜在空间,以指导噪声解缠结过程。此外,我们使用可逆单调算子来模拟变换过程,有效地增强了集成几何特征的表示。这种增强使我们的网络能够通过将噪声因素和潜在代码中的内在干净点投影到单独的通道上来精确区分它们。定性和定量评估均表明,我们的方法在各种噪声水平下都优于最先进的方法。源代码可在 https://github.com/yanbiao1/PD-LTS 获得。
证明生产的神经网络验证
a b s t r a c t - d ee p n e u r a l a l a l a l a l a t w o rk s(d nn s) EE t h e ir c o rr e c t n e ss。C o n s e qu e n t l y , t h e v e ri f i c a t i o n c o m - m un i t y h a s d e v i s e d m u l t i p l e t e c hn i qu e s a nd t oo l s f o r v e ri f y i ng D NN s .w h e n d nn v e ri f i e r s d i s d i s c o v e r a n i n i n i n i n i n p t t h t h t t t ri gg e r s a n e rr o r s a n e rr o r,t h a t h a t i s e s e s e s s y s y t o c o c o c o c o n f ir m; bu t w h e n t h e y r e p o r t t h a t n o e rr o r e x i sts , t h e r e i s n o w a y t o e n s u r e t h a t t h e v e ri f i c a t i o n t oo l i ts e l f i s n o t f l a w e d .A s m u l t i p l e e rr o r s h a v e a lr e a d y b ee n o b s e r v e d i n D NN v e ri f i c a t i o n t oo l s , t h i s c a ll s t h e a pp li c a b ili t y o f D NN v e ri f i c a t i o n i n t o qu e st i o n .I n t h i s w o rk, w e p r e s e n t a n o v e l m e c h a n i s m f o r e nh a n c i ng Si m p l e x - b a s e d D NN v e ri f i e r s wi t h p r oo f p r od u c t i o n c a p a b ili t i e s : t h e g e n e r a t i o n o f a n e a s y -t o -c h e c k wi t n e ss o f un s a t i s f i s f i a a b ili t y,w h i c h a tt e sts tt e sts t o t o t h e a a b s e a a b s e n c e n c e o f e rr s r s r s。o u r p r o f p r o o d o d o d o n i s b a s e s e n e n e n e n e n e n e f f f i c i c i c i c i e n t a d a p t a p t a t a t a t a t a t i o n o n o n o n o f t i o n o f t e w e ll -k n o w n f a rk a rk a rk a rk a rk a rk a s s'l e l e mma -li n e a r f un c t i o n s and nd nu m e ri c a l p r e c i s i o n e rr o r s。a s a p r oo f c o n c e p t e nn v e gh e d e c e d e c e c e c e c e. div>o u r e a t y s e g A. t y s a c a c a t y s e q -c ir e o n l y m i n i m o v e r h e a d a d。 div>
条件感知的神经网络,用于受控图像生成
我们介绍C ONTITION- WARE神经N ETWORK(CAN),这是一种将控制添加到图像生成模式中的新方法。与先前的条件控制方法并行,可以通过动态降低神经网络的重量来控制图像生成过程。这是通过引入条件感知的重量产生模式来实现的,该模块会根据输入条件为卷积/线性层生成条件重量。我们测试可以在Coco上的ImageNet和文本对图像生成上生成类别图像的生成。可以始终如一地为包括DIT和UVIT在内的扩散变压器模型提供显着改进。特别是,Ca n与有效的T(CAT)结合在Imagenet 512×512上达到2.78 FID,超过DIT-XL/2,同时每个采样步骤需要少52×MAC。
使用人工神经网络对视觉障碍进行建模
我们提出了一种方法来弥合人类视觉计算模型与视觉障碍 (VI) 临床实践之间的差距。简而言之,我们建议将神经科学和机器学习的进步结合起来,研究 VI 对关键功能能力的影响并改进治疗策略。我们回顾了相关文献,目的是促进充分利用人工神经网络 (ANN) 模型来满足视障人士和视觉康复领域操作人员的需求。我们首先总结了现有的视觉问题类型、关键的功能性视觉相关任务以及当前用于评估两者的方法。其次,我们探索最适合模拟视觉问题的 ANN,并在行为(包括性能和注意力测量)和神经层面预测它们对功能性视觉相关任务的影响。我们提供指导方针,为未来针对受 VI 影响的个体开发和部署 ANN 的临床应用研究提供指导。
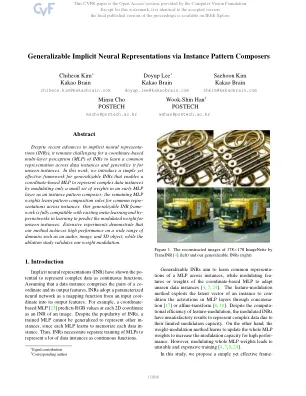
通过实例模式编写器实现可泛化的隐式神经表征
尽管隐式神经表征 (INR) 近期取得了进展,但对于基于坐标的 INR 多层感知器 (MLP) 来说,学习跨数据实例的通用表征并将其推广至未见实例仍然具有挑战性。在这项工作中,我们为可推广的 INR 引入了一个简单而有效的框架,该框架使基于坐标的 MLP 能够通过仅调节早期 MLP 层中的一小组权重作为实例模式组合器来表示复杂数据实例;其余 MLP 权重学习跨实例通用表示的模式组合规则。我们的可推广 INR 框架与现有的元学习和超网络完全兼容,可用于学习预测未见实例的调节权重。大量实验表明,我们的方法在音频、图像和 3D 对象等广泛领域都实现了高性能,而消融研究验证了我们的权重调节。

DNA:用于模板的可变形神经关节网络...
在本文中,我们提出了一种新型的可变形神经关节网络 (DNA-Net),这是一种基于无模板学习的方法,用于从单个 RGB-D 序列进行动态 3D 人体重建。我们提出的 DNA-Net 包括一个神经关节预测网络 (NAP-Net),它能够通过学习预测一组关节骨骼来跟随输入序列中人体的运动,从而表示人体的非刚性运动。此外,DNA-Net 还包括有符号距离场网络 (SDF-Net) 和外观网络 (Color-Net),它们利用强大的神经隐式函数来建模 3D 几何和外观。最后,为了避免像以前的相关工作那样依赖外部光流估计器来获得变形线索,我们提出了一种新的训练损失,即基于易到难几何的损失,这是一种简单的策略,它继承了倒角距离的优点来实现良好的变形引导,同时仍然避免了其对局部不匹配敏感性的限制。DNA-Net 以自监督的方式直接在输入序列上进行端到端训练,以获得输入对象的 3D 重建。DeepDeform 数据集视频上的定量结果表明,DNA-Net 的表现优于相关的最先进方法,并且有足够的差距,定性结果还证明我们的方法可以高保真度和细节重建人体形状。

用于电子神经网络的数模混合突触芯片
级联的 CMOS 突触芯片包含一个 32x32 (1024) 个可编程突触的交叉阵列,已被制造为用于完全并行实现神经网络的“构建块”。突触基于混合数模设计,该设计利用片上 7 位数据锁存器来存储量化权重,并利用两象限乘法 DAC 来计算加权输出。突触具有 6 位分辨率,传输特性具有出色的单调性和一致性。已制造了一个包含四个突触芯片的 64 神经元硬件,用于研究反馈网络在优化问题解决中的性能。在本研究中,已在硬件中实现了 7x7 一对一分配网络和 Hop field-Tank 8 城市旅行商问题网络。已证明该网络能够实时获得最佳或接近最佳的解决方案。