
XiaoMi-AI文件搜索系统
World File Search SystemSorting

对羊群进行排序:从孤立的第三磨牙和下颌骨的定量鉴定,通过几何形态图
Marine Jeanjean,Ashleigh Haruda,Lenny Salvagno,Renate Schafberg,Silvia Valenzuela-Lamas等。对羊群进行排序:通过几何形态计量学从孤立的第三磨牙和下颌骨对绵羊和山羊的定量鉴定。考古科学杂志,2022,141,pp.105580。10.1016/j.jas.2022.105580。HAL-04873072
片上尖峰分类,有效的中位数... 基于闩锁的快速下垂响应的设计 llmcarbon
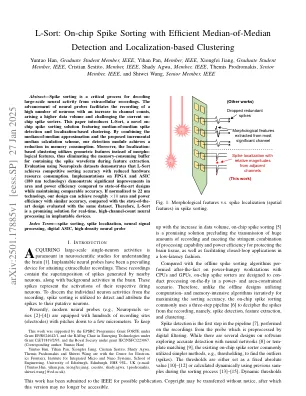
摘要 - Spike Corting是从细胞外记录中解码大规模神经活动的关键过程。神经探针的进步有助于记录大量神经元,并增加了通道计数的增加,从而导致较高的数据量并挑战了当前的On-Chip Spike Sorters。本文介绍了L-Sort,这是一种新颖的芯片尖峰分类解决方案,其中中位数尖峰检测和基于本地化的聚类。通过组合中位数近似值和提出的增量中值计算方案,我们的检测模块可实现记忆消耗的减少。此外,基于定位的聚类利用几何特征而不是形态特征,从而消除了在特征提取过程中包含尖峰波形的内存耗费缓冲区。使用Neuropixels数据集进行评估表明,L-SORT可以通过减少硬件资源消耗来实现竞争性排序精度。对FPGA和ASIC(180 nm技术)的实现,与最先进的设计相比,面积和功率效率显着提高,同时保持了可比的精度。,如果与使用相同数据集评估的最新设计相比,我们的设计将大约×10面积和功率效率达到相似的精度。因此,L-SORT是可植入设备中实时高通道计数神经处理的有前途的解决方案。

2024 11 26会议分类people.indd
5:50 pm – 7:00 PM Alondra Nelson,高级研究所,新泽西州普林斯顿州的社会技术转变DNA的社会技术。 从人类基因组项目到AI,从晚上7:30在Heiliggeist会议晚宴5:50 pm – 7:00 PM Alondra Nelson,高级研究所,新泽西州普林斯顿州的社会技术转变DNA的社会技术。从人类基因组项目到AI,从晚上7:30在Heiliggeist会议晚宴

基于图像处理的Apple排序系统
摘要 - 这项研究阐明了农业行业的发展,并强调了生产领域的进步。作为关键质量参数的果实大小和形状的显着识别强调了研究的重要性。应对这一挑战,该研究介绍了旨在简化农业环境中苹果的专业图像处理技术,特别强调了准确的苹果宽度估计。设计了专用的机器,其中包含一个围栏,该机箱装有一个具有成本效益的摄像头,以及用于对Malus fomeflya bockh borkh and Apples进行分类的链条输送机。通过实施图像预处理,细分和测量技术来成功实现这些目标,以促进分类。所提出的方法将苹果分为三个不同的类别,在第1类中获得了94%的令人印象深刻的精度,在第2类中达到92%,在第3类中达到86%。这代表了苹果分类和尺寸估计的有效且经济的解决方案,有望大大提高分类过程并突破农业部门的自动化界限。关键字 - 农业,开源计算机视觉(OPENCV),苹果,排序,宽度估计

在部分信息下进行分类的紧密界限
排序是理论计算机科学中的基本算法问题之一。它具有自然概括,由弗雷德曼(Fredman)于1976年引入,称为部分信息。The input consists of: - a ground set X of size n , - a partial oracle O P (where partial oracle queries for any ( x i , x j ) output whether x i ≺ P x j , for some fixed partial order P ), - a linear oracle O L (where linear oracle queries for any ( x i , x j ) output whether x i < L x j , where the linear order L extends P ) The goal is to recover the linear order使用最少数量的线性甲骨文查询在X上l。在此问题中,我们通过三个指标来测量算法复杂性:o l的线性甲骨文查询数量,部分甲骨文查询的数量和所花费的时间(识别哪个对(x i,x J)部分或线性oracle查询所需的算法指令的数量(识别哪个对(x I,x)执行)。令E(P)表示p的线性扩展数。 任何算法都需要最差的库log 2 e(p)线性甲骨文查询才能恢复x上的线性顺序。 在1984年,Kahn和Saks提出了第一个使用θ(log e(p))线性甲骨文查询(使用O(n 2)部分Oracle查询和指数时间)的算法。 从那时起,一般的问题和受限变体都经过一致研究。 一般问题的最新问题是Cardinal,Fiorini,Joret,Jungers和Munro,他们在Stoc'10设法将线性和部分甲骨文查询分为预处理和查询阶段。 他们可以使用O(n 2)部分Oracle查询和O(n 2。)进行预处理P 5)时间。令E(P)表示p的线性扩展数。任何算法都需要最差的库log 2 e(p)线性甲骨文查询才能恢复x上的线性顺序。在1984年,Kahn和Saks提出了第一个使用θ(log e(p))线性甲骨文查询(使用O(n 2)部分Oracle查询和指数时间)的算法。从那时起,一般的问题和受限变体都经过一致研究。一般问题的最新问题是Cardinal,Fiorini,Joret,Jungers和Munro,他们在Stoc'10设法将线性和部分甲骨文查询分为预处理和查询阶段。他们可以使用O(n 2)部分Oracle查询和O(n 2。5)时间。然后,给定o l,它们在θ(log e(p))线性甲骨文查询和o(n + log e(p))时间的x(log e(p))上的线性顺序 - 这在线性甲骨文查询的数量中是最佳的,但在所花费的时间中却没有。我们提出了第一种使用偏隔序数量甲骨文查询的第一个算法。对于任何常数C≥1,我们的算法可以使用O(n 1+ 1

基于颜色和形状的物体排序的机器人臂
对象分类机器人臂正在彻底改变我们的流程,使它们更有效,并为未来的自动化奠定了基础。它正在开辟我们处理和分类材料的新时代,尤其是随着技术的不断发展。但是,它确实有挑战。机器人臂必须适应不同类型的对象和现实世界环境,这可能很棘手。研究人员一直在努力提高其功能,以确保其顺利集成到各种环境中。随着技术的进步,该机器人部门的潜在应用正在扩大。它可用于详细的装配线,甚至用于个性化的物流。这项技术的持续发展强调了其在转型行业中的重要性。我们正在走向智能机器人系统将播放

Pigeonhole排序的平行化用于有效的数据排序
摘要 - 对并行排序算法的需求是由对大规模数据集有效处理的越来越多的需求所驱动的。Pigeonhole分选是在线性时间内携带排序的分类算法之一。本研究的重点是通过采用并行编程技术专门消息传递界面(MPI)和计算统一设备体系结构(CUDA)来提高提高孔分选方法的功效来提高算法的性能。主要目的是开发和评估鸽子孔分选的并行解决方案,以优化数据密集型应用中的排序效率。开始对Pigeonhole排序算法的顺序设计进行全面分析,该工作将使用CUDA进行图形处理单元(GPU)加速器和MPI创建并行实现,以进行分布式内存并行性。这项工作有助于将Pigonhole分类算法适应平行背景的宝贵见解。这些发现强调了平行化在减少总体计算时间方面的潜在优势。索引术语 - 伪造台面,并行编程,消息传递接口,计算统一设备体系结构,图形处理单元,加速

l-sort:用于实时多渠道尖峰与本地化的高效硬件
摘要 - Spike分选对于从神经信号中提取神经元信息并了解脑功能至关重要。随着高密度微电极阵列(HDMEAS)的出现,多通道尖峰分类的挑战和机遇已经加剧。实时尖峰排序特别对于闭环大脑计算机界面(BCI)介绍至关重要,要求有效的硬件实现。本文介绍了L-Sort,这是一种用于实时多通道尖峰排序的硬件设计。利用尖峰定位技术,L-SORT可实现有效的尖峰检测和聚类,而无需在检测过程中存储原始信号。通过合并中值阈值和几何特征,L-SORT在准确性和硬件效率方面展示了有希望的结果。我们使用使用高密度神经探针(Neuropixel)记录的公开数据集评估了设计的检测和聚类精度。我们在FPGA上实施了设计,并将结果与最先进的状态进行了比较。结果表明,与其他基于FPGA的Spike分类硬件相比,我们的设计消耗了更少的硬件资源。索引术语 - Spike Anting,Spike Netization,Hardware

自闭症支持系统
I.简介用户可以调整条形图的大小,可视化速度以及通过此Web应用程序以条形图显示数据的技术。显示和解决了应用程序的建筑设计,技术框架,实际使用和教育优势。[1]论文的主要目的是制定一个程序,该程序将充当理解大多数知名排序算法的运行的工具。努力提供最佳的用户体验。演示程序旨在易于使用并且对用户友好。您可以在数据上测试每个分类算法,以从学习中获得最大的价值。人们认识到,视觉援助是学习的重要组成部分,在我从事算法设计时遇到了分类问题。在研究论文时,发现新的方法是对算法进行分类的新方法,这是令人着迷的。[2]本文的读者有望拥有一些编程经验,以了解基本数据结构,例如数组,列表,树和理解递归过程。此外,了解一些简单算法及其实现可能会有所帮助。为了更好地理解主题,涉及线性代数和微积分的知识。论文的文本描述了计算机程序中最著名的排序算法的原理。它可以用作学生学习算法的来源。[3]此外,该计划在课堂期间很容易被讲师和导师用作演示。此外,还有程序员文档和提供的软件指南。

分类公众?使用质量定性方法来询问算法在数字
摘要关注社交媒体在政治中的作用(促进两极分化和传播虚假信息)时,许多激进主义者和公民黑客为审议和代表公众舆论而开发了替代性的数字民主平台。但是,我们如何研究这些平台的作用,尤其是它们在围绕它们的问题和公众开发中的算法?本文采用简单的质量数据可视化来研究特定的数字民主平台Vtaiwan(Pol.is的实施 - 一种用于对公共问题产生意见和共识的工具)的方式 - 格式化政治参与。我们研究了Vtaiwan平台上的用户,主持人和算法如何随着时间的推移在Vtaiwan平台上形成和改革一个特定问题(Uber合法化)。算法将意见分类为专业和反欧伯的二进制,但我们发现评论本身及其顺序表明了更多细微的立场和对话的潜力。我们认为,Vtaiwan可能会受到其关注简单的定量数据点(与文本本身相反)的关注(正面或负票),并强迫参与者将参与者分为或淘汰舆论组。本研究通过提供一种有效的方法来分析算法在民主政治中的作用,从而为批判算法研究和数字民主研究做出了贡献。