
XiaoMi-AI文件搜索系统
World File Search SystemTask

镜子u-net:将多模式裂变与多任务学习嫁给医学成像中的语义分割
正电子发射断层扫描(PET)和计算的刻录术(CT)通常共同用于检测肿瘤。PET/CT分割模型可以自动化肿瘤的描述,但是,当前的多模式模型不能完全阐明每种模式中的互补信息,因为它们要么串联PET和CT数据,要么在决策水平上融合它们。为了对抗这一点,我们提出了镜像u-net,它通过将多模式表示形式分配到模态特异性的解码器分支和辅助多模态解码器中,以多模态化的方式代替了传统的融合方法。在这些分支上,镜像u-net标志着一个针对每种模式量身定制的任务,以增强单峰特征,同时保留共享表示中的多模式特征。与以前的方法相比使用了其他方法或多任务学习,Mirror U-net将两个范式结合在一个统一的框架中。我们探索各种任务组合,并检查在模型中共享的哪些参数。我们在Autopet PET/CT和多模式MSD Braintumor数据集上评估了Mirror U-NET,证明了其在多模式分段中的有效性并在两个数据集中实现了先进的性能。代码:https://github.com/zrrrrr1997/ autopet_challenge_mirrorunet
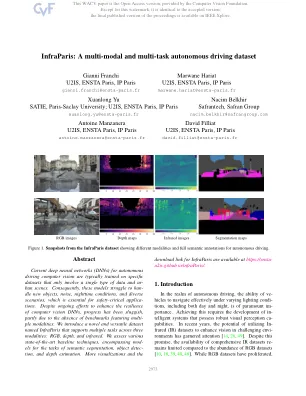
多模式和多任务自动驾驶数据集
当前用于自动驾驶计算机视觉的深层神经网络(DNNS)通常在仅涉及单一类型的数据和urban场景的特定数据集上进行培训。因此,这些模型努力使新物体,噪音,夜间条件和各种情况,这对于安全至关重要的应用至关重要。尽管持续不断努力增强计算机视觉DNN的弹性,但进展一直缓慢,部分原因是缺乏具有多种模式的基准。我们介绍了一个名为Infraparis的新颖和多功能数据集,该数据集支持三种模式的多个任务:RGB,DEPTH和INDRARED。我们评估了各种最先进的基线技术,涵盖了语义分割,对象检测和深度估计的任务。更多可视化和
提前计划:段落完成任务的自我监督文本计划
尽管上下文化的语言模型最近在各种NLP任务上取得了成功,但语言模型本身仍无法捕获长长的多句文档的文本共同(例如,段落)。人类经常就发言之前就何种方式以及如何发言做出结构性决定。通过这种高级决策和以连贯的方式构建文本的指导性实现被称为计划过程。模型可以在哪里学习这样的高级相干?段落本身包含在这项工作中称为自upervision的各种形式的归纳相干信号,例如句子顺序,局部关键字,修辞结构等。以此为动机,这项工作为新的段落完成任务p ar -c om;在图形中预测蒙版的句子。但是,该任务遭受了预测和选择相对于给定上下文的适当局部内容。为了解决这个问题,我们提出了一个自我监督的文本计划,该计划可以预测首先说出的内容(内容预测),然后使用预测的内容指导验证的语言模型(表面实现)。SSPlanner在自动和人类评估中的段落完成任务上的基线生成模型优于基线生成模型。我们还发现,名词和动词类型的关键字的组合是最有效的内容选择。提供了更多内容关键字,总体发电质量也会提高。

教务长人工智能和学习环境工作组报告
1. 持续学习人工智能:鉴于人工智能技术的快速发展,工作组建议优先考虑持续学习机会。这些可以包括入职培训计划、演讲系列和旨在提高大学社区人工智能素养的专业发展计划。2. 将人工智能主题纳入教学大纲:为了帮助学生了解人工智能在学术环境中的作用和局限性,教师应在课程大纲中纳入关于人工智能的有目的的陈述。教学与学习中心可以提供工具和建议来实现这一目标。3. 与学习成果相一致的课程评估:应修改传统的评估方法,以适应生成式人工智能带来的挑战。选项包括口试、课堂写作作业和其他形式的真实评估,这些评估无法被人工智能轻易复制。4. 政策修订:应系统地审查和更新现有政策,明确提及生成式人工智能。这将有助于学生和教职员工了解在哪里以及如何适当使用人工智能。
依赖于踝关节肌肉的任务依赖性募集以及机械需求之间的肌肉驱动驱动于肌肉收缩的代谢成本
引用Lai,Adrian K M,Dick,Taylor J M,Biewener,Andrew A和Wakeling,JamesM。皇家学会界面杂志18,第1期。174(2021):20200765。

追求卓越运营工作组报告
Katharine Stewart (联合主席) 副教务长、教务事务处、执行校长兼教务长 Marie Williams (联合主席) 副校长、人力资源处、财务和行政办公室 Philip Alarcon-Furman 博士威尔逊纺织学院学生 Jeff Baynham 大学发展服务部临时副校长 Mark Beasley 企业风险管理计划主任、毕马威会计师事务所 会计学教授 普尔管理学院 Rich Berlin 校园企业部副校长、财务与行政办公室 Jim Broschart 大学发展部副校长、大学发展部 Adrian Day 财务与规划部助理副教务长、执行副校长兼教务长办公室 Amira Hijazi 工业工程博士生、工程学院 Warren Jasper 纺织工程、化学与科学教授、威尔逊纺织学院 Leda Lunardi 电气与计算机工程教授、工程学院 Doug Morton 财务与行政办公室设施部副校长 Barbara Moses 财务与行政办公室预算与资源管理部副校长 Joyce Munro 农业与生命科学学院商业运营部助理院长 Barry Olson 工商管理部副校长、学术与学生事务部 Caroline Ortiz-Deaton 资源管理主任机构战略与分析办公室分析 Jason Painter 科学学院科学之家主任 David Rainer 财务与行政办公室环境健康与公共安全副校长 Shawn Troxler 总法律顾问办公室副总法律顾问 Nancy Whelchel 机构战略与分析办公室调查研究主任
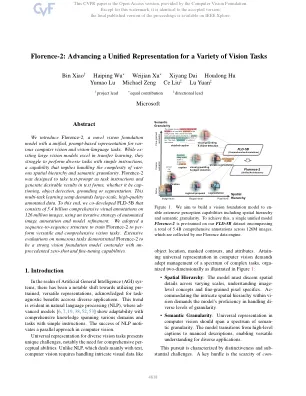
佛罗伦萨-2:推进各种视觉任务的统一代表
我们介绍了Florence-2,这是一个新型视觉基础模型,具有统一的,及时的代表,用于量级计算机视觉和视觉语言任务。在转移学习方面表现出色时,他们努力通过简单的说明执行各种任务,这意味着处理各种空间层次结构和语义粒度的复杂性。Florence-2旨在将文本推出作为任务说明,并以文本形式产生理想的结果,无论是限制,对象检测,接地还是分割。这种多任务学习设置需要大规模的高质量注释数据。为此,我们使用自动化图像注释和改进的迭代策略,共同开发了1.26亿张图像的FLD-5B。我们采用了一个序列结构,以训练佛罗伦萨-2,以执行多功能和全面的视觉任务。对众多任务的广泛评估表明,佛罗伦萨-2是具有未曾预性零击和微调功能的强大愿景基础模型竞争者。

HAEM:获得更高质量的分类任务...
在有限的预算下,获得固定的分类任务集的高质量结果是众包中的一个关键问题。应探索引入人工智能模型来补充该过程。然而,现有的方法很少直接解决这个问题;现有的方法是在如何使用嘈杂的众包数据训练人工智能模型的背景下提出的。本文提出了一种更直接的方法来解决在有限的预算下引入人工智能来提高人类工作者在固定数量任务中的结果的问题;我们将人工智能模型视为同事,并汇总人类和人工智能工作者的结果。提出的“人机协同 EM”(HAEM)算法扩展了 Dawid-Skene 模型,将 AI 模型视为同事,并明确计算它们的混淆矩阵以得出更高质量的聚合结果。我们进行了大量的实验,并将 HAEM 与两种方法(MBEM 和 Dawid-Skene 模型)进行了比较。我们发现,在大多数情况下,基于 AI 的 HAEM 比 Dawid-Skene 模型表现出更好的性能,并且当 AI 模型性能不佳时,它表现出比 MBEM 更好的性能。

人工智能任务组 - 最终报告
● 包容性指导、监督和教师支持:RIT AI 中心将由一个内部咨询委员会指导,该委员会的成员来自整个大学,包括至少一名来自每个学院的院长代表以及来自研究副校长办公室、教务长办公室、RIT 研究生院和多元化与包容性部门的代表。外部咨询委员会可能由政府国家实验室的领导、人工智能研究的工业研究实验室以及人工智能领域的学术或政府领导组成。由于缺乏教师支持,可能会造成利用率不足的威胁,这表明需要从一开始就制定策略来吸引教师。教师将参与中心的规划和持续发展,可能通过调查、研讨会和在咨询委员会中的代表来实施。
