
XiaoMi-AI文件搜索系统
World File Search SystemVision
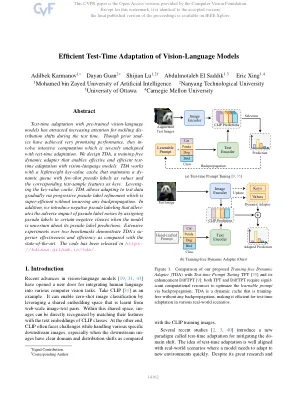
视觉模型的有效测试时间适应
通过预训练的视觉模型进行测试时间适应,引起了越来越多的关注,以应对测试时间的分离转移。尽管事先实现了非常有前途的性能,但它们会进行密集的计算,这与测试时间适应非常不规则。我们设计了TDA,这是一种无训练的动态适配器,可通过视觉模型进行有效,有效的测试时间适应。tda可与轻巧的键值缓存一起使用,该缓存维持具有很少射击伪标签的dy-namic队列作为值,而相应的测试样本特征则是键。杠杆键值缓存,TDA允许通过渐进式伪标签的细化逐渐调整数据,而逐步测试数据,而不会产生任何反向传播。此外,我们引入了负伪标记,即当模型不确定其伪标签预测时,通过将伪标签分配给某些负类时,可以减轻伪标签噪声的不利影响。在两个基准上进行的广泛实验表明,与最先进的艺术品相比,TDA的实体有效性和效率。该代码已在https://kdiaaa.github.io/tda/中发布。
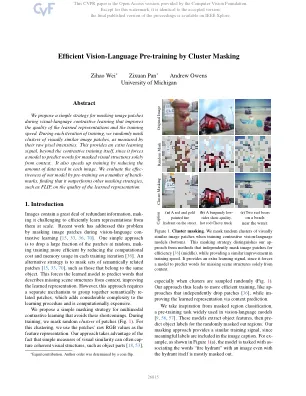
通过群集掩模的有效视力语言预训练
图像包含大量冗余信息,使其具有挑战性地在大规模上从它们中有效地了解它们。最近的工作通过在视觉语言构想学习期间掩盖图像贴片来解决这个问题[15,33,36,70]。一种简单的方法是随机放下大部分斑块,通过降低每个训练迭代中的计算成本和记忆使用量,从而更有效地培训训练[36]。替代策略是掩盖语义相关的贴片[15,33,70],例如属于同一对象的贴片。这迫使学习的模型预测从上下文中描述缺少场景结构的单词,从而改善了学识渊博的表示。但是,这种方法需要一种单独的机制来将语义重新贴定的补丁分组在一起,这为学习过程增加了相当大的复杂性,并且计算上很昂贵。我们提出了一种简单的掩盖策略,用于避免这些缺点的多模式对比学习。在训练期间,我们掩盖了斑块的随机簇(图1)。对于此聚类,我们将Patches的原始RGB值用作特征表示。我们的方法利用了一个事实,即视觉相似性的简单度量通常可以限制相干的视觉结构,例如对象部分[18,53],
使用Pytorch的计算机视觉的初学者指南
要使用Pytorch中的数据增强,您将需要定义一组可以应用于培训数据的转换功能。您还需要确保将转换功能始终应用于输入图像和相应的注释。然后,您可以使用Torchvision.datasets.ObjectDetectionDataSet类使用批次的方式,将这些转换应用于培训数据。
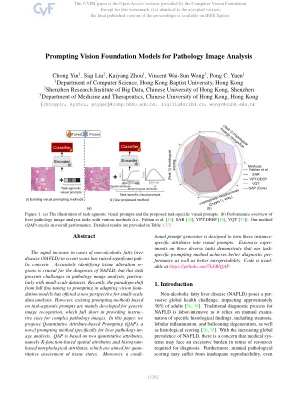
提示病理图像分析的视觉基础模型
近年来非酒精性脂肪肝疾病(NAFLD)病例的迅速增加引起了人们的重大关注。准确地识别组织的改变对NAFLD的诊断至关重要,但是该任务在病理图像分析中带来了挑战,特别是与小规模的数据集有关。最近,从完整的微调转变为改编视觉模型的提示的范式转变为小规模数据分析提供了新的视角。然而,基于任务不足提示的现有提示方法主要是为了通用图像识别而开发的,该方法在为复杂病理学图像提供指导的指示方面缺乏。在本文中,我们提出了基于定量属性的提示(QAP),这是一种专门用于肝脏病理学分析的新提示方法。QAP基于两个定量属性,即基于K功能的空间属性和基于直方图的形态学属性,旨在对组织状态进行标准评估。此外,condi-


使用...
I.引言介绍水果分级系统项目为理解其目的和范围奠定了基础。在这个项目中,我们旨在根据各种参数(例如大小,颜色,重量和质量)开发一种综合系统来对水果进行分级。该系统将旨在满足需要有效,准确的方法来评估出售或分配水果质量的水果生产商,分销商和零售商的需求。为了实现这一目标,我们选择利用前端和后端技术的组合。对于前端,我们将使用HTML,CSS和JavaScript来创建一个用户友好的接口,允许用户无缝与系统进行交互。前端将负责显示信息,收集用户输入并提供对分级过程的反馈。在后端,我们将使用Python烧瓶作为网络框架来处理服务器端逻辑和与前端的通信。烧瓶为构建Web应用程序提供了一个轻巧,灵活的框架,使其成为我们项目的理想选择。此外,我们将利用MySQL作为数据库管理系统来存储和管理与水果,评分标准和用户信息有关的数据。MySQL为数据存储和检索提供了可靠的功能,从而确保了我们系统的可扩展性和可靠性。总体而言,水果分级系统项目旨在通过利用现代网络技术和数据库管理系统来简化分级水果的过程。通过提供用户友好的接口和鲁棒的后端功能,我们寻求
计算机视觉预测收获的影响...
摘要 - 全球计算机视觉的加速发展对水果收获的估计产生了重大影响,从而提高了效率并大大减少了食物浪费。此外,这项技术在农业部门面临着显着的抵抗力和缺乏知识。本综述的目的是分析人工视力方法在预测高茎果的收获时。因此,应用了非实验性描述性设计,属于无荟萃分析的系统综述。基于定义的标准(包含和排除),从电子数据库Scopus,Scielo和Redalyc中选择了26篇开放访问文章,这些文章涉及使用VA来预测高茎水果的收获。的发现表明,大多数研究使用近红外(NIR)光谱和RGB图像处理来估计收获,分别达到95%(柑橘类水果)和75%(苹果)的平均准确性。此外,使用RGB和YOLOV3图像传感器的无人机的使用使得获得大于90%的精确度成为可能,从而实现了收获前4到6个月之间的预测。得出结论是,使用最常用的VA方法是RGB图像传感器,光谱法(NIR),无人驾驶飞机(UAV)和Yolov3,它们在预测高茎果实的成熟方面的准确性大于75%。该方法的选择将主要取决于您是要分析果实的内部还是外部部分,因此,重要的是要识别高茎果实在其生长阶段的色素沉着的变化。

欧洲机器人的统一愿景
该策略阐明了欧洲机器人界的集体愿景。它借鉴了来自欧洲境内的多种信息来源,来自欧洲主题小组,研讨会和市场研究,从跟踪全球机器人技术的进步以及与其他协会和组织的合作。它提出了一系列建议,内容涉及公共和私人组织应如何努力确保欧洲的机器人技术在中长期内具有经济和社会影响。这些关于使欧洲产品和服务能够创造附加值的中心,同时维持欧洲强大的机器人研究和创新基础。它列出了支持吸收的案例,长期关注研究并满足从机器人的角度来支持欧洲强大的创新基础设施的基本需求。它探讨了机器人创新的途径和创新增长的方向。
视觉导航的体积环境表示
Vision语言导航(VLN)要求代理在基于视觉观察和自然语言说明的3D环境中导航。很明显,成功导航的关键因素在于全面的场景理解。以前的VLN代理使用单眼框架直接提取透视视图的2D特征。虽然很简单,但他们为捕获3D几何和语义而努力,导致部分不完整的环境代表。为了实现具有细粒细节的全面3D表示,我们引入了体积环境(VER),将物理世界脱氧于结构化的3D细胞中。对于每个单元格,通过2D-3D采样将多视图2D特征归纳到如此统一的3D空间中。通过对VER的粗略到纤维特征进行推断和多任务学习,我们的代理人可以共同预测3D占用率,3D房间布局和3D边界框。基于在线收集的vers,我们的代理构成了体积状态估计,并构建情节内存以预测下一步。实验结果表明,我们从多任务学习的环境表示导致了VLN的可观绩效提高。我们的模型在VLN基准(R2R,Reverie和R4R)之间实现了最新的性能。