XiaoMi-AI文件搜索系统
World File Search SystemVision

与计算机视觉的深度学习
深度学习和神经网络:多层感知器:多层感知器体系结构,什么是隐藏的层?每一层中有多少层和多少个节点?激活函数:线性传输函数,重型阶跃功能(二进制分类器),sigmoid/logistic函数,软马克斯函数,双曲线切线函数(TANH),整流的线性单元,泄漏的relu。前馈过程:前馈计算,特征学习。错误函数:错误函数是什么?,为什么我们需要一个错误函数?错误总是正面的,均为正方形错误。跨凝性,关于错误和权重优化算法的最终说明:什么是优化?,批处理梯度下降,随机梯度下降,微型批次梯度下降,梯度下降点击。反向传播:什么是反向传播?,反向传播外卖。

美国环保署 2022-2032 愿景的 TMDL 优先战略
2025 年 1 月 24 日 简介 《联邦清洁水法》第 303(d)(1)(A) 条规定,各州必须为需要开发总最大日负荷 (TMDL) 的水道制定优先级排序。该优先级排序必须包括损害的原因,并考虑污染的严重程度和水体的用途。本文件包含宾夕法尼亚州对美国环境保护署 (USEPA) TMDL 计划 2022-2032 愿景的优先级排序理由。根据 40 CFR 130.7(b)(4),这一原理将有助于指导在宾夕法尼亚州选择特定水体进行 TMDL 开发,以两年为周期,从 2024 年 10 月 1 日开始,用于美国环保署 2022-2032 愿景的剩余部分。除了 TMDL,此优先级排序还设想在适当的情况下使用其他类型的修复计划,包括下文所述的提前修复计划 (ARP) 和保护计划。虽然这种优先级策略有助于以有组织和周到的方式规划未来工作,但它并不意味着严格限制此时间范围内的项目,因为可能会出现不可预见的需求和机会。高效 TMDL 开发的一个关键实际考虑是开发特定污染物/用途组合的方法所需的大量资源投入。例如,用于开发因淤积而导致的水生生物使用障碍的 TMDL 的方法可能与用于解决因病原体导致的娱乐使用障碍的数据和方法大不相同。为了最大限度地提高项目资源的有效利用,明智的做法是一次关注一种特定的污染物/用途组合,并在将重点转向其他污染物/用途组合之前制定许多类似的 TMDL。因此,宾夕法尼亚州环境保护局 (DEP) 正在根据本美国环境保护署愿景周期的目标污染物/用途组合简短列表组织此拟议优先级排名。指定用途和令人关注的污染物对宾夕法尼亚州 2022 年综合水质报告最终版和 2024 年综合水质报告草案的审查显示,水生生物用途的损害最为常见,其次是娱乐用途的损害。相比之下,鱼类消费和供水用途的损害则不那么常见。在水生生物用途类别中,淤积损害最为常见,其次是金属、pH 值和营养物损害。病原体/大肠杆菌 (E. coli) 是娱乐用途类别中唯一列出的污染物原因。下面进一步讨论在未来几年内对 TMDL/ARP 开发中每种污染物进行优先排序的理由。

使用...
I.引言介绍水果分级系统项目为理解其目的和范围奠定了基础。在这个项目中,我们旨在根据各种参数(例如大小,颜色,重量和质量)开发一种综合系统来对水果进行分级。该系统将旨在满足需要有效,准确的方法来评估出售或分配水果质量的水果生产商,分销商和零售商的需求。为了实现这一目标,我们选择利用前端和后端技术的组合。对于前端,我们将使用HTML,CSS和JavaScript来创建一个用户友好的接口,允许用户无缝与系统进行交互。前端将负责显示信息,收集用户输入并提供对分级过程的反馈。在后端,我们将使用Python烧瓶作为网络框架来处理服务器端逻辑和与前端的通信。烧瓶为构建Web应用程序提供了一个轻巧,灵活的框架,使其成为我们项目的理想选择。此外,我们将利用MySQL作为数据库管理系统来存储和管理与水果,评分标准和用户信息有关的数据。MySQL为数据存储和检索提供了可靠的功能,从而确保了我们系统的可扩展性和可靠性。总体而言,水果分级系统项目旨在通过利用现代网络技术和数据库管理系统来简化分级水果的过程。通过提供用户友好的接口和鲁棒的后端功能,我们寻求
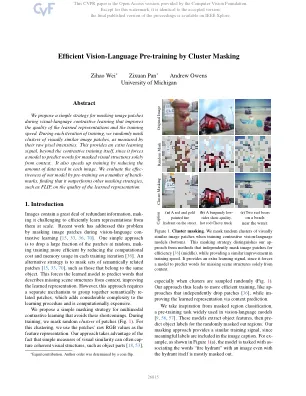
通过群集掩模的有效视力语言预训练
图像包含大量冗余信息,使其具有挑战性地在大规模上从它们中有效地了解它们。最近的工作通过在视觉语言构想学习期间掩盖图像贴片来解决这个问题[15,33,36,70]。一种简单的方法是随机放下大部分斑块,通过降低每个训练迭代中的计算成本和记忆使用量,从而更有效地培训训练[36]。替代策略是掩盖语义相关的贴片[15,33,70],例如属于同一对象的贴片。这迫使学习的模型预测从上下文中描述缺少场景结构的单词,从而改善了学识渊博的表示。但是,这种方法需要一种单独的机制来将语义重新贴定的补丁分组在一起,这为学习过程增加了相当大的复杂性,并且计算上很昂贵。我们提出了一种简单的掩盖策略,用于避免这些缺点的多模式对比学习。在训练期间,我们掩盖了斑块的随机簇(图1)。对于此聚类,我们将Patches的原始RGB值用作特征表示。我们的方法利用了一个事实,即视觉相似性的简单度量通常可以限制相干的视觉结构,例如对象部分[18,53],

视觉变压器具有分层注意力
摘要:本文解决了香草视觉变压器中与多头自我注意(MHSA)相关的高计算/空间复杂性。为此,我们提出了层次MHSA(H-MHSA),这是一种新颖的方法,以层次的方式计算自我注意力。具体来说,我们首先将输入图像分为通常完成的补丁,每个补丁都被视为令牌。然后,提议的H-MHSA学习本地贴片中的令牌关系,作为局部关系建模。然后,将小斑块合并为较大的贴片,H-MHSA对少量合并令牌的全局依赖性建模。终于,将本地和全球专注的特征汇总为具有强大表示能力的功能。由于我们仅在每个步骤中计算有限数量的令牌的注意力,因此计算负载大大减少。因此,H-MHSA可以在不牺牲细粒度信息的情况下有效地模拟令牌之间的环境关系。与H-MHSA模块合并,我们建立了一个基于层次的变压器网络的家族,即HAT-NET。为了证明帽子网络在场景中的优越性,我们就基本视觉任务进行了广泛的实验,包括图像分类,语义分割,对象titection和实例分段。因此,HAT-NET为视觉变压器提供了新的视角。代码和预估计的模型可在https://github.com/yun-liu/hat-net上找到。
计算机视觉预测收获的影响...
摘要 - 全球计算机视觉的加速发展对水果收获的估计产生了重大影响,从而提高了效率并大大减少了食物浪费。此外,这项技术在农业部门面临着显着的抵抗力和缺乏知识。本综述的目的是分析人工视力方法在预测高茎果的收获时。因此,应用了非实验性描述性设计,属于无荟萃分析的系统综述。基于定义的标准(包含和排除),从电子数据库Scopus,Scielo和Redalyc中选择了26篇开放访问文章,这些文章涉及使用VA来预测高茎水果的收获。的发现表明,大多数研究使用近红外(NIR)光谱和RGB图像处理来估计收获,分别达到95%(柑橘类水果)和75%(苹果)的平均准确性。此外,使用RGB和YOLOV3图像传感器的无人机的使用使得获得大于90%的精确度成为可能,从而实现了收获前4到6个月之间的预测。得出结论是,使用最常用的VA方法是RGB图像传感器,光谱法(NIR),无人驾驶飞机(UAV)和Yolov3,它们在预测高茎果实的成熟方面的准确性大于75%。该方法的选择将主要取决于您是要分析果实的内部还是外部部分,因此,重要的是要识别高茎果实在其生长阶段的色素沉着的变化。

对欧洲人工智能领导力的愿景
政府可以通过作为AI解决方案的早期采用者来推动创新,但是复杂的采购规则通常排除了初创企业。2025年欧盟计划对采购规则的修订,为简化流程提供了关键的机会。提高直接授予的阈值,简化申请流程以及减少报告要求将有助于公共机构利用创业公司的创新潜力。朝这个方向迈出的第一步是法国最近决定提高国防和安全部门初创企业以获得公共合同而无需通过公共招标程序从100,000到300,000欧元的门槛。这应该包括AI驱动分析等项目,以优化公共交通或自动化行政工作流程以提高效率。

可持续发展愿景计划 - 奥斯汀
2. CAPITAL METRO 的承诺 A. 一般性承诺。Capital Metro 致力于通过减少对环境的影响并帮助改善其运营所在社区的环境,以可持续的方式运营其交通系统。我们将采用可持续发展和环境最佳实践,并遵守所有环境法律法规,同时通过 Project Connect 扩大交通机会。我们认识到交通运输向大气排放了大量温室气体,作为公共交通提供商,Capital Metro 将采取措施通过设计、技术选择以及为客户提供影响较小的交通选择来减少气候变化的风险。