
XiaoMi-AI文件搜索系统
World File Search SystemVision

s2-MLP:视觉的空间移位MLP体系结构
最近,Visual Transformer(VIT)及其以下作品放弃了卷积,并利用了自我发项操作,比CNN获得了可比甚至更高的精度。最近,MLP-Mixer放弃了卷积和自我发项操作,提出了仅包含MLP层的体系结构。为了实现交叉补丁通信,除了通道混合MLP外,它还设计了其他令牌MLP。在诸如JFT-300M之类的极限数据集上进行训练时,它会取得令人鼓舞的结果。,但是当在ImagEnet-1k等中等规模的数据集上训练时,它的表现不如其CNN和VIT对应。MLP混合使用的性能下降激励我们重新考虑令牌混合MLP。我们发现,MLP混合中的令牌混合操作是深度卷积的变体,具有全局接收场和空间特异性配置。在本文中,我们提出了一种新颖的纯MLP体系结构,即空间移位MLP(S 2 -MLP)。不同于MLP混合器,我们的S 2 -MLP仅包含通道混合MLP。我们设计了一个空间换档操作,以实现通过补丁之间的通信。它具有局部接收场,是空间的 - 不可知论。同时,它无参数且有效地计算。在Imagenet-1K数据集训练时,提出的S 2 -MLP比MLP混合剂具有更高的识别精度。同时,S 2 -MLP在ImageNet-1k数据集上具有出色的性能,具有更简单的架构,较少的失败和参数。
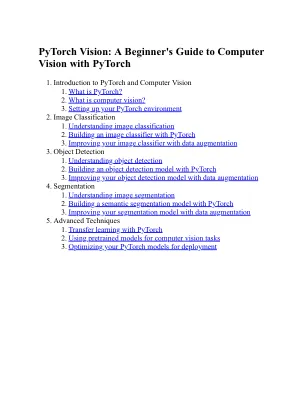
使用Pytorch的计算机视觉的初学者指南
要使用Pytorch中的数据增强,您将需要定义一组可以应用于培训数据的转换功能。您还需要确保将转换功能始终应用于输入图像和相应的注释。然后,您可以使用Torchvision.datasets.ObjectDetectionDataSet类使用批次的方式,将这些转换应用于培训数据。

视觉、学习和机器人:2020 年代的植物人工智能
随着全球人口的增长和对粮食的需求不断增加,农业生产面临着巨大的压力。与此同时,气候变化和资源限制加剧了这些挑战,进一步凸显了对可持续农业实践的需求。为了解决这些复杂的问题,植物科学领域正在经历一场技术革命。人工智能 (AI)、计算机视觉和机器人技术的快速发展正在重新定义植物的研究方式和农业实践的管理方式。从高通量表型到精准农业和实时监测,这些技术正在显著提高效率和准确性,为更具弹性和可持续性的农业系统奠定基础。本研究主题汇集了开创性的研究,以展示人工智能如何推动植物科学的发展并为现代农业提供创新解决方案。
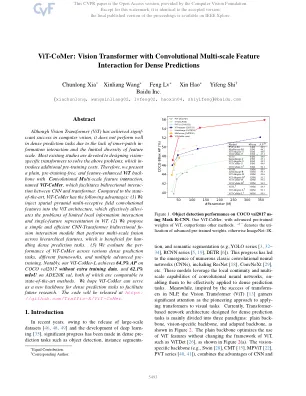
VIT-COMER:具有卷积多尺度特征相互作用的视觉变压器,用于密集预测
尽管Vision Transformer(VIT)在计算机视觉方面取得了显着的成功,但由于缺乏内部绘制互动和特征量表的多样性有限,它在密集的预测任务中表现不佳。大多数现有的研究致力于设计视觉特定的变压器来解决上述问题,从而涉及额外的培训前成本。因此,我们提出了一种普通的,无培训的且具有特征增强的vit背骨,并具有指定性的特征性动作,称为Vit-Comer,可促进CNN和Transformer之间的双向相互作用。与现状相比,VIT-COMER具有以下优点:(1)我们将空间金字塔多触发性场卷积特征注入VIT体系结构,从而有效地减轻了VIT中局部信息相互作用和单场表述的有限问题。(2)我们提出了一个简单有效的CNN转换器双向交互模块,该模块在跨层次特征上执行多尺度融合,这对Han-dling密集的预测任务有益。(3)我们评估了在各种密集的预测任务,不同框架和多个高级预训练中VIT-COMER的能力。值得注意的是,我们的VIT-COMER-L在没有额外训练数据的情况下可可Val2017上的AP达到64.3%,而ADE20K Val上的MIOU为62.1%,这两种方法都与最先进的方法相当。我们希望VIT-COMER可以作为密集预测任务的新骨干,以促进未来的研究。该代码将在https://github.com/traffic-x/vit-comer上发布。

建模合作者:通过LLM工具使用
从内容节制到野生动植物保护,需要模型识别细微或主观的视觉概念的应用数量正在增长。传统上,开发用于此类概念的分类器需要在数小时,天甚至数月内衡量的大量手动努力来识别和注释培训所需的数据。即使最近提出的敏捷建模技术可以快速地进行图像分类器的快速启动,但仍需要用户花费30分钟或更多的单调,重复的数据标签,以训练一个罪恶的分类器。利用了Fiske的认知灾难理论,我们提出了一个新框架,通过用自然语言相互作用代替人类标签,从而减少了由自然语言相互作用,从而减少了通过一个数量级来定义的总体努力所需的总体努力:从将2,000张标记的图像定义为只有2,000张图像到只有100张图像到100次自然语言相互作用。我们的框架利用了大型语言模型和视觉语言模型的基础模型的最新进展,以通过对话和自动标记培训数据点来雕刻概念空间。最重要的是,我们的框架消除了对人群来源注释的需求。此外,我们的框架最终生产出在成本敏感的方案中可部署的轻量级分类模型。在15个主观概念和2个公共图像分类数据集中,我们训练的模型的表现优于传统敏捷建模以及最先进的零拍模型,例如Align,clip,cupl,Cupl和大型视觉问题回答诸如Pali-X之类的模型。
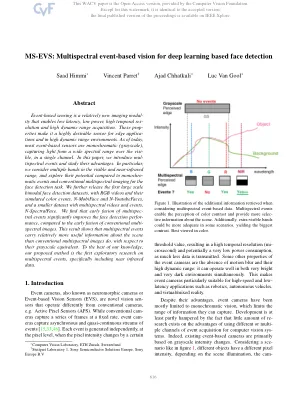
MS-EVS:基于多光谱事件的基于深度学习的面部检测的愿景
基于事件的传感是一种相对较新的成像模态,可实现低潜伏期,低功率,高时间分解和高动态范围采集。这些支持使其成为边缘应用和在高动态范围环境中的高度可取的传感器。截至今天,大多数基于事件的传感器都是单色的(灰度),在单个通道中捕获了Visi-ble上广泛光谱范围的光。在本文中,我们介绍了穆斯特朗事件并研究了它们的优势。尤其是我们在可见范围内和近红外范围内考虑多个频段,并探索与单色事件和用于面部检测任务的传统多光谱成像相比的潜力。我们进一步发布了第一个大型双峰面检测数据集,其中包含RGB视频及其模拟色彩事件,N-Mobiface和N-Youtubefaces,以及带有多光谱视频和事件的较小数据集,N-SpectralFace。与常规多频谱图像的早期融合相比,多阶段事件的早期融合可显着改善面部检测性能。此结果表明,相对于灰度等效物,多光谱事件比传统的多光谱图像具有相对有用的有关场景的信息。据我们所知,我们提出的方法是关于多光谱事件的首次探索性研究,特别是包括近红外数据。

愿景与策略让我们的第4课链接esterno与AggionRare更好
- 优势:您的产品/服务的最佳功能是什么?您向别人不能或不这样做的人提供什么?- 弱点:您的产品/服务的某些平均功能是其他更好的功能?- 机会:您的公司可能会蓬勃发展的某些领域,因为目前尚未利用它?- 威胁:哪些外部因素 - 竞争者,消费者需求,经济状况 - 可能会使您的企业成功更加困难?您会注意到,前两个字母集中在您内部控制的事情上,而最后两个则关注组织必须回应的外部环境条件。

与计算机视觉的深度学习
深度学习和神经网络:多层感知器:多层感知器体系结构,什么是隐藏的层?每一层中有多少层和多少个节点?激活函数:线性传输函数,重型阶跃功能(二进制分类器),sigmoid/logistic函数,软马克斯函数,双曲线切线函数(TANH),整流的线性单元,泄漏的relu。前馈过程:前馈计算,特征学习。错误函数:错误函数是什么?,为什么我们需要一个错误函数?错误总是正面的,均为正方形错误。跨凝性,关于错误和权重优化算法的最终说明:什么是优化?,批处理梯度下降,随机梯度下降,微型批次梯度下降,梯度下降点击。反向传播:什么是反向传播?,反向传播外卖。

TechnoVision 2024:航空航天和国防
浏览报告后,您将在“您的体验”容器中发现 Experience² 趋势如何支持数字连续性,这是民用航空的事实标准。然后,您将进入“物联网经济”趋势,探索低地球轨道上的新卫星星座如何提供全新服务,以改善全球行业领导者或全球部署军队的供应链。我邀请您通过访问我们的应用创新交流空间之一来发现可用的相关演示。最后,为什么不了解北约如何展示“数据共享即关怀”趋势,以管理复杂的国际生态系统中的海量和多样性数据,从而改善协作、标准并提取数据价值呢?当然,这些趋势只是本报告中包含的 37 种趋势中的三种!

WCA 2021 愿景与战略
作为制定这一战略计划过程的一部分,董事会审查了组织的使命和精神,比较了我们目前如何实现这些声明,并调整计划以更好地实现这些声明。在整个审查过程中,董事会一致认为使命和精神中最重要的部分是“公平和平等的条件”。这常常被人们遗忘,而人们更青睐“更多的比赛”。在所有 WCA 比赛中保持公平和平等的条件对于 WCA 继续为社区提供服务至关重要。