
XiaoMi-AI文件搜索系统
World File Search Systemformer
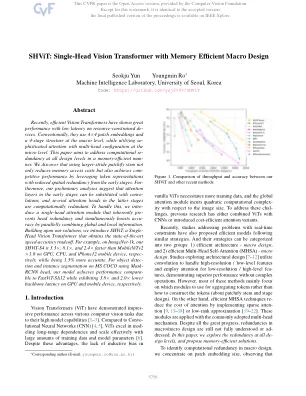
shvit:带有内存有效宏设计的单头视觉变压器
最近,有效的视觉变压器表现出出色的性能,并且在资源受限的范围内延迟较低。通常,他们在宏观水平上使用4×4贴片嵌入式和4阶段结构,同时在微观级别利用多头配置的同时注意力。本文旨在解决记忆效率高的人中所有设计级别的计算重复。我们发现,使用较大的修补茎不仅降低了内存访问成本,而且还通过利用令牌表示,从早期阶段降低了空间冗余,从而实现了态度性能。fur-hoverore,我们的初步分析表明,在早期阶段的注意力层可以用会议代替,并且后期阶段的几个注意力头在计算上是多余的。为了处理这一点,我们介绍了一个单头注意模块,该模块固有地预先预先冗余,并同时通过相结合的全局和本地信息来提高准确性。在解决方案的基础上,我们引入了Shvit,这是一种单头视觉变压器,获得了最先进的速度准确性权衡。例如,在ImagEnet-1k上,我们的SHVIT-S4在GPU,CPU和iPhone12移动设备上比MobileVitV2×1.0快3.3×,8.1×和2.4倍,而同时更准确。用于使用Mask-RCNN头对MS Coco进行的对象检测和实例分割,我们的模型分别在GPU和移动设备上表现出3.8×和2.0×下骨架潜伏期时,可以与FastVit-SA12进行比较。

前任专家委员会的最后报告...
安全理事会 1992 年 10 月 6 日第 780 (1992) 号决议要求我设立一个专家委员会,负责审查和分析所收集的信息,以便向秘书长提供关于前南斯拉夫境内严重违反日内瓦四公约和其他违反国际人道主义法行为的证据的结论。1992 年 10 月 26 日,我任命了一个由五名成员组成的委员会,由弗里茨·卡尔斯霍芬教授担任主席,后者辞职后,由切里夫·巴西奥尼教授担任主席。我关于设立专家委员会的报告于 1992 年 10 月 14 日提交安理会 (S/24657)。委员会于 1992 年 11 月开始活动,并于 1994 年 4 月结束工作。在此期间,委员会举行了 12 届会议,并进行了一系列研究和现场调查,为此目的利用了各国政府和非政府组织提供的援助。委员会还建立了一个数据库,旨在全面记录所有已报告的严重违反日内瓦公约和其他违反国际人道主义法的行为。委员会的两份临时报告描述了其工作状况和初步结论,已在我 1993 年 2 月 9 日(S/25274)和 1993 年 10 月 5 日(S/26545)的信中转交给安全理事会。委员会的最后报告包括对委员会自成立以来的工作、任务、结构和工作方法的调查、对前南斯拉夫背景下特别重要的某些法律问题的看法、对“交战派别”军事结构及其所采用的战略和战术的一般性研究,以及对波斯尼亚和黑塞哥维那各地犯下的所谓“种族清洗”、种族灭绝和其他大规模违反基本人道规定的罪行、强奸和性侵犯以及破坏文化财产等罪行的实质性调查结果。

表演者:一种新型的PPG至ECG重建变压器,用于心血管疾病检测的数字生物标志物
心电图(ECG)是一种捕获心脏活动的电测量,是诊断心血管疾病(CVD)的金标准。但是,由于ECG需要使用用户参与,因此不可避免地进行心脏监测。相比之下,光电学(PPG)提供了易于收集的数据,但其精度有限限制了其临床用法。为了确定这两个信号的优势,最近的研究不适合将PPG信号重新构成到ECG的各种深度学习技术;但是,缺乏文本信息以及降低噪声生物医学信号的能力最终会限制模型的影响。在这项研究中,我们提出了一种基于变压器的新型体系结构,可从PPG重建ECG,并将PPG和重建的ECG与CVD检测的多种方式相结合。此方法是第一次在生物医学波形重构上进行了变压器序列到序列转换,并结合了PPG和ECG的优势。我们还创建了基于斑块的注意(SPA),这是一种效率方法,用于编码/解码生物医学波形。通过获取各种序列长度并捕获交叉点连接,SPA最大程度地提高了本地特征和全局上下文反复的信号操作。所提出的体系结构在BIDMC数据库上生成了0.29 RMSE的状态性能,以重新构建PPG到ECG,超过了先前的研究。我们还在模拟III数据集上评估了该模型,在CVD检测中达到了95.9%的精度,并在PPG-BP数据集中评估了该模型,在相关的CVD糖尿病检测中达到了75.9%的精度,表明其一般能力。作为一种概念证明,一种名为Pearl(原型)的耳环可穿戴式可穿戴,旨在扩大护理点(POC)医疗保健系统。
3D猫:脑肿瘤的通道注意变压器
摘要 - 脑肿瘤诊断是一项具有挑战性的任务,但对于计划治疗以停止或减慢肿瘤的生长至关重要。在过去的十年中,卷积神经网络(CNN)在医学图像中肿瘤的自动分割中的高性能急剧增加。最近,与CNN相比,视觉变压器(VIT)已成为医学成像的稳健性和效率的核心重点。在本文中,我们提出了一个新颖的3D变压器,称为3D catbrats,用于基于最先进的SWIN变压器的磁共振图像(MRIS),用于使用残留块和通道注意模块的最先进的SWIN变压器进行磁共振图像(MRI)。在Brats 2021数据集上评估了所提出的方法,并实现了在验证阶段超过当前最新方法的平均骰子相似性系数(DSC)的定量度量。索引项 - CNN,变形金刚,VIT,语义段
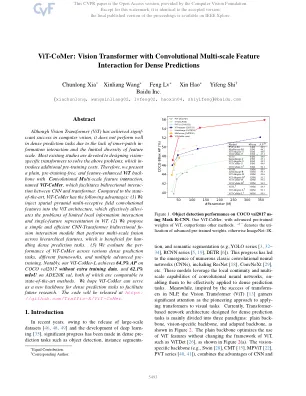
VIT-COMER:具有卷积多尺度特征相互作用的视觉变压器,用于密集预测
尽管Vision Transformer(VIT)在计算机视觉方面取得了显着的成功,但由于缺乏内部绘制互动和特征量表的多样性有限,它在密集的预测任务中表现不佳。大多数现有的研究致力于设计视觉特定的变压器来解决上述问题,从而涉及额外的培训前成本。因此,我们提出了一种普通的,无培训的且具有特征增强的vit背骨,并具有指定性的特征性动作,称为Vit-Comer,可促进CNN和Transformer之间的双向相互作用。与现状相比,VIT-COMER具有以下优点:(1)我们将空间金字塔多触发性场卷积特征注入VIT体系结构,从而有效地减轻了VIT中局部信息相互作用和单场表述的有限问题。(2)我们提出了一个简单有效的CNN转换器双向交互模块,该模块在跨层次特征上执行多尺度融合,这对Han-dling密集的预测任务有益。(3)我们评估了在各种密集的预测任务,不同框架和多个高级预训练中VIT-COMER的能力。值得注意的是,我们的VIT-COMER-L在没有额外训练数据的情况下可可Val2017上的AP达到64.3%,而ADE20K Val上的MIOU为62.1%,这两种方法都与最先进的方法相当。我们希望VIT-COMER可以作为密集预测任务的新骨干,以促进未来的研究。该代码将在https://github.com/traffic-x/vit-comer上发布。


摘要 研究:AI 社会认知评估与建模。评估 LLM 中的心智理论及其在心理学中的应用 NLP:LLM IFT、表征学习(对比和三重态损失)、语义聚类、总结 DL:Transformers、MoE、EncDec、RNNs、DPO、LoRA 工具:Python、Pytorch、Deepspeed、AWS Sagemaker、hydra、SQL 管理:建立 ML 团队、职能、策略和 OKR、招募和指导科学家和实习生以及建立数据和注释伙伴关系。
摘要 研究:AI 社会认知评估与建模。评估 LLM 中的心智理论及其在心理学中的应用 NLP:LLM IFT、表征学习(对比和三重态损失)、语义聚类、总结 DL:Transformers、MoE、EncDec、RNNs、DPO、LoRA 工具:Python、Pytorch、Deepspeed、AWS Sagemaker、hydra、SQL 管理:建立 ML 团队、职能、策略和 OKR、招聘和指导科学家和实习生以及建立数据和注释合作伙伴关系。

小波损耗的训练变压器模型可改善单图像超分辨率
基于变压器的模型已在包括图像超级分辨率(SR)在内的低级视觉任务中取得了显着的结果。但是,在获得全球信息时,基于不重叠的窗口中依赖自我注意的早期aperach遇到了挑战。为了激活全球更多输入像素,已经提出了混合注意模型。此外,通过仅将像素的RGB损失(例如L 1)降至最低而无法捕获基本的高频降低,训练不足。本文提出了两种贡献:i)我们引入了卷积非本地稀疏注意(NLSA)块,以扩展混合变压器体系结构,以增强其接受场。ii)我们采用小波损失来训练变压器模型,以提高定量和主观性能。虽然先前已经探索过小波损耗,但在基于训练变压器的SR模型中显示了它们的力量是新颖的。我们的实验结果表明,所提出的模型在各种基准数据集中提供了状态的PSNR结果以及出色的视觉性能。
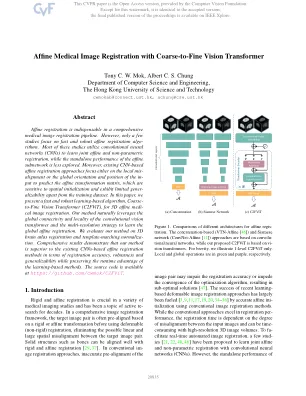
使用粗到精视觉变换器进行仿射医学图像配准
仿射配准在全面的医学图像配准流程中不可或缺。然而,只有少数研究关注快速而鲁棒的仿射配准算法。这些研究中大多数利用卷积神经网络(CNN)来学习联合仿射和非参数配准,而对仿射子网络的独立性能探索较少。此外,现有的基于 CNN 的仿射配准方法要么关注局部错位,要么关注输入的全局方向和位置来预测仿射变换矩阵,这些方法对空间初始化很敏感,并且除了训练数据集之外表现出有限的通用性。在本文中,我们提出了一种快速而鲁棒的基于学习的算法,即粗到精视觉变换器(C2FViT),用于 3D 仿射医学图像配准。我们的方法自然地利用了卷积视觉变换器的全局连通性和局部性以及多分辨率策略来学习全局仿射配准。我们对 3D 脑图谱配准和模板匹配归一化方法进行了评估。综合结果表明,我们的方法在配准精度、稳健性和通用性方面优于现有的基于 CNN 的仿射配准方法,同时保留了基于学习的方法的运行时优势。源代码可在 https://github.com/cwmok/C2FViT 上找到。
Genai / Transformers研讨会概述,内部和见解< / div>
➢j和l是损失 /错误 /成本功能的通常符号,即< / div>模型预测的内容与根据地面真理预测的内容之间的区别。