
XiaoMi-AI文件搜索系统
World File Search Systemgm
像医学居民一样培训:对通用医学图像分割的上下文学习
临床成像工作流的主要重点是疾病诊断和管理,导致医学成像数据集与特定的临床目标密切相关。这种情况导致了开发特定于任务的分割模型的主要实践,而没有从广泛的成像群中获得见解。受到医学放射学居民培训计划的启发,我们提出了向普遍医学图像分割的转变,旨在通过利用临床目标,身体区域和成像方式的多样性和共同点来建立医学图像理解基础模型的范式。div of这个目标,我们开发了爱马仕,一种新颖的上下文 - 学习方法,以应对医学图像segmentation中数据杂基的挑战和注释差异。在五种模式(CT,PET,T1,T2和Cine MRI)和多个身体区域的大量各种数据集(2,438个3D图像)中,我们证明了通用范式比传统范式在单个模型中解决多个任务的传统范式的优点。通过跨任务的协同作用,爱马仕在所有测试数据集中都能达到最先进的性能,并显示出卓越的模型可伸缩性。其他两个数据集中的结果揭示了爱马仕在转移学习,分裂学习和对下游任务的概括方面的出色表现。爱马仕(Hermes)博学的先生展示了一个具有吸引力的特征,以反映任务和方式之间的复杂关系,这与既定的放射学解剖学和成像原则相吻合。代码可用1。


触觉增强的辐射场 - CVF Open Access
我们提出了一个场景表示形式,我们称之为触觉的辐射场(TARF),它将视觉和触摸带入共享的3D空间。此表示形式可用于估计场景中给定3D位置的视觉和触觉信号。我们从一系列照片和稀疏采样触摸探针中捕获了场景的tarf。我们的方法利用了两个见解:(i)基于常见的触摸传感器建立在普通摄像机上,因此可以使用多视图几何形状中的方法对图像进行注册,并且(ii)在视觉和结构上相似的场景区域具有相同的触觉效果。我们使用这些见解将触摸信号注册到捕获的视觉场景中,并训练有条件的扩散模型,该模型带有从神经辐射场呈现的RGB-D图像,生成其相应的触觉信号。为了评估我们的方法,我们收集了一个TARF的数据集。此数据集比预先持有的现实世界数据集包含更多的触摸样本,并且为每个捕获的触摸信号提供了空间对齐的视觉信号。我们揭示了跨模式生成模型的准确性以及在下游任务上捕获的视觉效果数据的实用性。项目页面:https:// dou- yiming.github.io/tarf。
从文本到图像综合的前景 - 背景分割的无监督共同生成
文本对图像(T2I)合成是一项艰巨的任务,该任务是对文本和图像域及其关系进行建模。最近作品实现的图像质量的实质性改进为Nuberon应用程序铺平了道路,例如语言辅助图像编辑,计算机辅助设计,基于文本的图像检索和培训数据增强。在这项工作中,我们提出了一个简单的问题:与逼真的图像一起,我们是否可以以一种不受影响的方式获得任何有用的副产品(例如前景 /背景或多类分割掩码,检测标签,检测标签),这也将使其他计算机视觉任务任务和应用受益?试图回答这个问题,我们探索了从给定文本中的逼真的图像及其相应的前景 /背景分割掩码。为了实现这一目标,我们与GAN一起实验了共进行分割的概念。具体而言,提出了一种名为“共裂”启发的GAN(COS-GAN)的新型GAN结构,该结构同时从不同的噪声矢量中同时生成两个或多个图像,并利用图像特征之间的空间关注机制来生成逼真的分段掩码,以生成生成的Im-Im-Im-Im-Im-Im-Im-Im-Im-Im-Im-Agens。这种架构的优点是两倍:1)生成的分割掩码可用于专注于前景和背景,以改善生成的图像的质量,2)分段蒙版可以用作其他任务的训练目标,例如访问本地化和分割。在CUB,Oxford-102和可可数据集上进行的广泛实验表明,Cos-Gan能够改善视觉质量,并为发电图像提供可靠的前景 /背景掩码。
视觉增强的动态语义原型,用于生成零拍学习
生成的零拍学习(ZSL)学习了一个生成器来合成看不见类的视觉样本,这是推进ZSL的有效方法。然而,现有的发电方法依赖于高斯噪声和预定义的语义原型的条件,这限制了仅在特定的看到类中优化的发电机,而不是对每个视觉实例进行特征,从而导致概括不良(例如,过度适用于可见的类)。为了解决这个问题,我们提出了一种新颖的视觉启动动态语义原型方法(称为VADS),以增强发电机来学习准确的语义 - 视觉映射,以充分利用视觉效果的知识为语义条件。详细说明,VADS由两个模块组成:(1)视觉吸引域知识学习模块(VDKL)了解视觉特征的偏见和全局先验(称为域的视觉知识),这些偏见取代了纯净的高斯噪声,以提供更丰富的先验噪声信息; (2)以视觉为导向的语义更新模块(VOSU)根据样本的视觉表示更新语义原型。最终,我们将它们的输出作为动态语义原型串联,作为发电机的条件。广泛的实验表明,我们的VAD在三个突出的数据集上实现了上升的CZSL和GZSL prounperces,并且在Sun,Cub和Awa2上分别胜过其他最先进的方法,其平均分别增加了6.4%,5.9%,5.9%和4.2%。

多元化和个性化的多评价医学图像细分
注释歧义由于固有的数据不确定性,例如医学扫描中的界限模糊以及不同的观察者专业知识和偏好已成为训练基于深度学习的医学图像模型的主要观点。为了解决这个问题,普遍的做法是从不同专家那里收集多个注释,导致多评价医学图像分割的设置。现有的作品旨在将不同的注释合并到“地面真实”中,而在众多医疗环境中通常无法实现,或者产生不同的结果,或产生与个人专家评估者相对应的个性化结果。在这里,我们提出了一个更雄心勃勃的多评价医学图像细分的目标,即遵守多元化和个性化结果。指定,我们提出了一个名为d-persona的两个阶段框架(第一个d iversification,然后是角色lization)。在第I阶段,我们利用多个给定注释来训练一个可能性的U-NET模型,并具有约束损失,以证明预测多样性。以这种方式,在第I阶段建造了一个共同的空间,其中不同的潜在代码表示多样化的专家意见。然后,在第二阶段,我们设计了多个基于注意力的投影头,以适应来自共享潜在空间的相应专家提示,然后执行个性化的医疗图像细分。我们评估了内部鼻咽癌数据集和公共肺结核数据集(即LIDC-IDRI)的拟议模型。我们的代码将在https://github.com/ycwu1997/d-persona上发布。的实验实验表明,我们的D-Persona可以同时获得多元化和个性化的结果,从而实现了多评位者医疗图像细分的新SOTA性能。
ma-lmm:长期视频理解的内存大型多模型
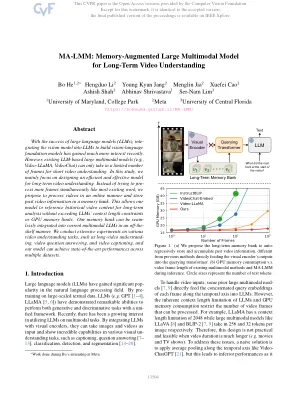
随着大型语言模型(LLM)的成功,将视觉模型融入了LLM,以建立视觉语言基础模型最近引起了人们的兴趣。但是,现有的基于LLM的大型多模式模型(例如,视频播放,视频聊天)只能摄入有限数量的框架以进行简短的视频理解。在这项研究中,我们主要专注于设计一个有效有效的模型,以进行长期视频理解。我们建议以在线方式处理视频并将过去的视频信息存储在存储库中,而不是像大多数现有作品一样尝试同时进行更多框架。这使我们的模型可以参考历史视频内容以进行长期分析,而不会超过LLM的上下文长度约束或GPU内存限制。我们的内存库可以以现成的方式被缝制到当前的多模式LLMS中。我们在各种视频理解任务上进行了广泛的实验,例如长期介绍,视频问题答案和视频字幕,我们的模型可以在多个数据集中实现最新的性能。

个性化的患者偏好预测因素,用于替代医疗保健的判断:技术上FEA
摘要在为无行为能力的患者做出替代判断时,代理人经常努力猜测患者有能力会想要什么。代理人也可能因(唯一)做出这种决定的责任而感到痛苦。为了解决此类问题,已经提出了一种患者偏好预测因子(PPP),该预测因素将使用算法从人群级别的数据中推断出单个患者的治疗偏好,以了解具有相似人口统计学特征的人的已知偏好。然而,批评家们已经表明,即使这种PPP平均比人类替代者更准确,在识别患者偏好方面,拟议的算法仍然无法尊重患者(以前的)自主权,因为它会借鉴“错误的”数据:对于个人而言,这些数据不适合个人的数据,因此他们不适合他们的挑战,并且他们的实际原因是他们的实际原因,或者是实际的,或者是实际上的,或者是实际上的,或者是实际的,或者是实际的,或者是实际的,或者是实际上所依据的,或者是实际的原因。在船上受到这样的批评,我们在这里提出了一种新方法:个性化的患者偏好预测因子(P4)。P4基于机器学习的最新进展,该技术允许包括大型语言模型在内的技术更便宜,更有效地“微调”在特定于人的数据上。与PPP不同,P4将能够从实际上特定于其特定的材料(例如先前的治疗决策)中推断出单个患者的偏好。因此,我们认为,除了在个体水平上比以前提出的PPP更准确,P4的谓词还将更直接地反映每个患者自身的原因和价值观。在本文中,我们回顾了人工智能研究中的最新发现,这些发现表明P4在技术上是可行的,并认为,如果它是开发和适当部署的,则应缓解一些基于自主的主要关注原始PPP的批评者的关注。然后,我们考虑对我们的提案的各种异议,并提供一些暂定的答复。
Synergynet:弥合离散和连续表示之间的差距,以进行精确的医学图像分割
近年来,已经提出了连续的潜在空间(CLS)和DISCRETE潜在空间(DLS)深度学习模型,以改善医学图像分析。但是,这些模型遇到了不同的挑战。cls模型捕获了复杂的细节,但由于其强调低级特征,因此在结构表示和易男性方面通常缺乏解释性。尤其是,DLS模型提供了可解释性,鲁棒性以及由于其结构性潜在空间而捕获粗粒度信息的能力。但是,DLS模型在捕获细粒细节方面的功效有限。为了确定DLS和CLS模型的局限性,我们采用了Synergynet,这是一种新型的瓶颈体系结构,旨在增强现有的编码器 - 核编码器分割框架。Synergynet无缝地将离散和连续的表示形式整合到利用互补信息中,并成功保留了细学的表示的细节。我们对多器官分割和CAR-DIAC数据集进行的实验实验表明,SynergyNet的表现优于包括Transunet:Transunet:DICE评分提高2.16%的其他最新方法,而Hausdorff分别分别提高了11.13%。在评估皮肤病变和脑肿瘤分割数据集时,我们观察到皮肤病变分割的交互分数的1.71%的重新提高,脑肿瘤分割的增长率为8.58%。我们的创新方法为增强医学图像分析关键领域中深度学习模型的整体性能和能力铺平了道路。