
XiaoMi-AI文件搜索系统
World File Search Systemtraining
基于MTPI自动转移学习的深层网络自动训练方法和D
UAV图像采集和深度学习技术已被广泛用于水文监测中,以满足数据量需求不断提高和质量的增加。但是,手动参数培训需要反复试验成本(T&E),现有的自动培训适应简单的数据集和网络结构,这在非结构化环境中是低实用性的,例如干山谷环境(DTV)。因此,这项研究合并了转移学习(MTPI,最大转移电位指数法)和RL(MTSA强化学习,多汤普森采样算法)在数据集自动启动和网络中自动培训,以降低人类的经验和T&E。首先,为了最大程度地提高迭代速度并最大程度地减少数据集消耗,使用改进的MTPI方法得出了最佳的迭代条件(MTPI条件),这表明随后的迭代仅需要2.30%的数据集和6.31%的时间成本。然后,在MTPI条件(MTSA-MTPI)中提高了MTSA至自动提高数据集,结果显示准确性(人为误差)提高了16.0%,标准误差降低了20.9%(T&E成本)。最后,MTPI-MTSA用于四个自动训练的网络(例如FCN,SEG-NET,U-NET和SEG-RES-NET 50),并表明最佳的SEG-RES-NET 50获得了95.2%WPA(准确性)和90.9%的WIOU。本研究为复杂的植被信息收集提供了一种有效的自动培训方法,该方法提供了减少深度学习的手动干预的参考。
引用Lindberg FA,Kagios C,TjernströmN和Roman E(2025)在老鼠赌博任务中训练时间的个体差异与Subs
决策在日常生活中起着至关重要的作用,需要评估与不同选择相关的概率和风险的短期和长期结果。损害的决策可以被定义为做出不明智或冒险选择的趋势,并且在几种精神病疾病中是一个核心问题,包括药物使用和赌博障碍(1-3),注意力定义多活障碍(4)和情感障碍(5,6)(5,6)。对决策过程及其参与精神病疾病的研究有所增加,并且已经开发了对决策不同方面的几项测试。爱荷华州赌博任务(IGT)最初是为了评估腹侧前额叶皮层损害的患者的决策受损(7)。此后,它已成为一种广泛使用的工具,用于评估临床和非临床样本中不确定性和风险下的人类决策(8)。向参与者提供了四个牌牌,这些卡具有不同的胜利或亏损可能性。参与者未知,卡片在其货币收益/损失意外事件上有所不同,两个甲板是有利的,并且在长期的货币利润方面不利(7)。几项操作任务可用于对不同认知过程和潜在神经生物学的临床前研究,包括延迟折现,五个选择的串行反应时间任务(5-CSRTT)和不同版本的啮齿动物赌博任务。重要的是,从翻译价值中,这些任务具有人类类似物(9-11)。此外,培训可能会偏向实验结果。任务的共同点,有时是作为警告,是教动物在进行任何实验操作之前进行任务所需的深入培训。这使他们既耗时又耗资货币昂贵(12)。老鼠赌博任务(RGT)基于IGT,其中包括与赢得蔗糖颗粒或接受惩罚超时的不同概率相关的四个选择(13)。要建立最有利的策略,老鼠需要更喜欢与立即奖励和短暂超时相关的低风险选项,并避免与较大的即时奖励和更长的惩罚超时相关的选项。已经表明,大鼠在RGT中制定了与IGT中人类相似的策略(14、15),并且大多数大鼠在最有利的选择方面学习并保持稳定的选择(13、15-20)。然而,基于此类策略存在很大的个体差异,动物已分为三个不同的策略组:(i)战略群体更喜欢最有利的选择,(ii)更喜欢安全选择的安全群体,该群体更安全的选择,该选择最安全的选择,可以使一个不可或缺的时间和(iii)具有更高的选择组,以及(iii),以及(iii)偏爱的选择,即20岁,而不利地选择了两种选择。大鼠需要进行自由选择的RGT需要多长时间的训练,但是尚不清楚以不同的决策策略的大鼠组之间的任务获取和训练日数是否有所不同。此发现暗示以前已经证明,在RGT中具有不同策略的大鼠在与奖励和决策过程有关的区域中显示出大脑连通性的差异(20)。

机器人任务特定的上肢神经植物培训
摘要目的:用于上限LIMB神经居住的机器人设备可以增加实践强度,通常依靠具有有限能力的基于视频游戏的培训策略来个性化培训和整合功能培训。本研究显示了机器人任务特定培训(TST)方案的开发,并评估所达到的剂量。材料和方法:混合方法研究。上肢的3D机器人装置可在神经康复期间使用治疗师使用。第一阶段允许临床医生为TST定义专门的会话协议。在第二阶段应用方案,并测量了达到的剂量。结果:第一阶段(n = 5):一种特定的协议,使用降级进行评估,然后进行定制的被动运动,然后开发了主动运动实践。第二阶段:该协议已成功应用于所有参与者(n = 10)。干预持续时间:4.5±0.8周,会话频率:1.4±0.2次/周,会话长度:42±9mins,会话密度:39±13%,强度:214±84个运动/会话,难度:DN = 0.77±0.1(归一化的距离),距离= 6.3±= 6.3±23±23±23±23±23±23±useverseversemberseversempesseans(spresseverseverseverseverseans)。sessions的密度和强度在参与者之间是一致的,但是观察到了明显的难度差异。在干预中未观察到指标的变化。结论:机器人系统可以通过调节参与者的需求和能力的实践难度来支持高治疗强度的TST。

将物理世界和虚拟世界结合起来进行运动认知训练干预:关于运动技术分类的指导意见书
有效的运动需要完整的运动和认知功能。越来越多的文献研究了运动认知干预措施,以提高健康或患病老年人的整体生活质量。对于此类干预,新的技术进步不仅在动机方面至关重要,而且对于改善多刺激世界中的用户体验也至关重要,这些世界通常以真实和虚拟环境的混合形式提供。本文为与运动相关的研究提供了一个分类系统,涉及在不同程度的虚拟环境中执行的运动认知干预。分类分为三类:(a)数字设备的类型及其提供的沉浸度;(b)人机交互的存在与否;(c)训练期间的活动参与,定义为活动>任务的1.5代谢当量。由于虚拟现实(VR)通常将不同的技术归类在同一术语下,我们提出了从计算机显示器和投影仪到头戴式VR技术的数字设备分类法。近年来发展迅速的所有沉浸式技术都归类在扩展现实(XR)这一总称下。这些包括增强现实 (AR)、混合现实 (MR) 和虚拟现实,以及所有尚未开发的技术。这项技术不仅在游戏和娱乐方面具有潜力,而且在研究、运动认知训练计划、康复、远程医疗等方面也具有潜力。本立场文件为基于数字设备、人机交互和身体参与的未来运动相关干预措施提供了定义、建议和指南,以便更一致地使用术语并有助于更清楚地理解其含义。

适用于中欧的新模型
摘要:二维(2D)材料中的本地带隙调整对于电子和光电设备而言至关重要,但是在纳米级实现可控制和可重复的应变工程技术仍然是一个挑战。在这里,我们通过扫描探针报告了热机械纳米引导,以在2D过渡金属二核苷剂和石墨烯中创建应变纳米图案,从而在空间分辨率下以调制的带隙启用任意模式,以降低到20 nm。2D材料通过范德华的相互作用与下面的薄聚合物层相互作用,由于加热探针的热和压痕力而变形。特别是,我们证明了钼二硫化(MOS 2)的局部带隙被空间调节高达10%,并且可以约180 MeV的幅度调整为180 MEV,以菌株的线性速率约为-70 meV。该技术提供了一种多功能工具,用于研究具有纳米尺度分辨率的2D材料的局部应变工程。关键字:2D材料,应变纳米图案,钼二硫化,局部带隙,热扫描探针光刻,尖端增强的拉曼光谱■简介
视觉皮层的功能专业化是从训练平行途径中出现的
哺乳动物的视觉系统由平行的分层专业途径组成。不同的途径在使用更适合支持特定下游行为的表示形式方面是专门的。在特定的情况下,最清楚的例子是视觉皮层的腹侧(“ What what”)和背(“ Where”)途径的专业化。这两种途径分别支持与视觉识别和运动有关的行为。至今,深度神经网络主要用作腹侧识别途径的模型。但是,尚不清楚是否可以使用单个深ANN对两种途径进行建模。在这里,我们询问具有单个损失函数的单个模型是否可以捕获腹侧和背途径的特性。我们使用与其他哺乳动物一样的小鼠的数据探讨了这个问题,这些途径似乎支持识别和运动行为。我们表明,当我们使用自我监督的预测损失函数训练深层神经网络体系结构时,我们可以在拟合鼠标视觉皮层的其他模型中胜过其他模型。此外,我们可以对背侧和腹侧通路进行建模。这些结果表明,应用于平行途径体系结构的自我监督的预测学习方法可以解释哺乳动物视觉系统中看到的一些功能专业。
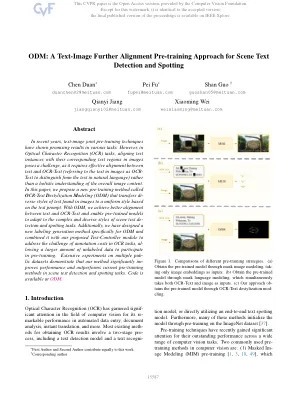
ODM:文本图像进一步的对齐预训练方法,用于场景文本检测和发现
近年来,文本图像联合预训练技术在各种任务中显示出令人鼓舞的结果。然而,在光学特征识别(OCR)任务中,将文本实例与图像中的相应文本区域对齐是一个挑战,因为它需要在文本和OCR文本之间有效地对齐(将图像中的文本称为ocr-文本以与自然语言中的文本区分开来),而不是对整体图像内容的全面理解。在本文中,我们提出了一种新的预训练方法,称为o cr-text d估计化m odeling(ODM),该方法根据文本提示将图像中的文本样式传输到统一样式中。使用ODM,我们在文本和OCR文本之间实现了更好的对齐方式,并启用预训练的模型以适应场景文本的复杂和多样化的样式。此外,我们为ODM设计了一种新的标签生成方法,并将其与我们提出的文本控制器模块相结合,以应对OCR任务中注释成本的挑战,并以大量未标记的数据参与预培训。在多个Pub-LIC数据集上进行的广泛实验表明,我们的方法显着地证明了性能,并且在场景文本检测和发现任务中的当前预训练方法优于当前的预训练方法。代码在ODM上可用。
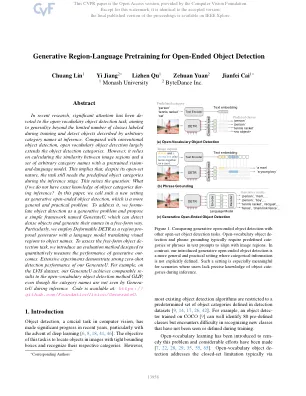
开放式对象检测的生成区域训练
在最近的研究中,已对开放式摄制对象检测任务进行了大量关注,旨在概括训练期间标记的类别的有限级别,并检测推理时任意类别名称所描述的对象。与常规对象检测相比,打开的词汇对象检测在很大程度上扩展了对象检测类别。但是,它依赖于计算图像区域与一组具有验证视觉和语言模型的任意类别名称之间的相似性。这意味着,尽管具有开放式的性质,但该任务仍然需要在推理阶段的预定义对象类别。这提出了一个问题:如果我们在推理中对对象类别没有确切的了解,该怎么办?在本文中,我们称之为新的设置为生成性开放式对象检测,这是一个更普遍和实际的问题。为了解决它,我们将对象检测形式为生成问题,并提出了一个名为generateu的简单框架,该框架可以检测密集的对象并以自由形式的方式生成其名称。尤其是,我们采用可变形的DETR作为区域促成生成器,其语言模型将视觉区域转换为对象名称。为了评估自由形式的对象划分任务,我们介绍了一种评估方法,旨在定量测量生成量的性能。广泛的实验表明我们的生成量强烈的零射击性能。代码可在以下网址获得:https://github.com/foundationvision/generateu。例如,在LVIS数据集上,我们的GenerateU在推理过程中属于类别名称,即类别名称无法看到类别名称,即使类别名称看不见类别名称,我们的GenerateU也可以与开放式唱机对象检测方法GLIP相当。

Sarah Carlblom的背景和培训是儿童发育,父母的依恋,创伤和游戏疗法方式。
●1999 BS业务和通信; minor in French: Calvin College (Grand Rapids, MI) ● 2004 Masters in Professional Counseling: Ottawa University (Phoenix, AZ) ● 2005 Licensed with the Board of Behavioral Health Examiners (LPC-13113) ● 2005 National Board of Certified Counselors ● Work experience: 2003-2009 Christian Family Care Agency (a forerunner and leader in the field of Child Development, Parent Child Attachment, &创伤信息护理)。2009年家庭基督教咨询中心(私人执业)。●与该领域的国际领导人进行了广泛的培训和磋商:布鲁斯·佩里(Bruce Perry)博士(NeureSequent Model),Karyn Purvis博士(儿童发展研究所),Holly Vangoulden(儿童发展)(儿童发展),Anna Gomez(Trauma&Emdr),Bessel van der Kolk(大脑和身体连接)以及许多教育课程以及多样性的工作,以及多样性地进行了综合的工作,并与之相关联。