
XiaoMi-AI文件搜索系统
World File Search System大型
MCD:机器人感知的多种大型多校区数据集
感知在各种机器人应用中起着至关重要的作用。但是,现有的良好的数据集偏向自动驾驶场景,而未标记的SLAM数据集则很快过于拟合,并且通常缺乏环境和域变化。为了扩大这些领域的边界,我们介绍了一个名为MCD(Multi-campus数据集)的全面数据集,其中包含各种感应方式,高准确的地面真相以及在三个欧亚大学的欧亚大学校园内的挑战性环境。MCD包括CCS(经典的圆柱旋转)和NRE(非重复性环球)LIDAR,高质量的IMU(惯性测量单元),相机和UWB(URWB(Ultra-Wideband))传感器。更重要的是,在开创性的努力中,我们引入了29堂课的语义注释,超过59k稀疏的nre lidar扫描
使用交叉注意信号对大型语言模型进行微调模型的一种自我监督的强化学习方法
我们为不依赖于人类反馈的大型语言模型(LLMS)提出了一种新颖的增强学习(RL)框架。相反,我们的方法使用模型本身中的交叉注意信号来获得自我监督的奖励,从而指导对模型策略的迭代微调。通过分析模型在生成过程中如何“参加”输入提示,我们构建了及时的覆盖,重点和连贯性的度量。然后,我们使用这些措施来对候选响应进行排名或评分,提供了奖励信号,鼓励模型产生良好的一致,主题文本。在与标准策略梯度方法的经验比较和合成偏好模型的RL微调中,我们的方法在非RL基线的迅速相关性和一致性方面显示出显着的提高。虽然它尚未与完全监督的RLHF系统的性能相匹配,但它突出了使用最小的人类标记来扩展对齐的重要方向。我们提供了详细的分析,讨论潜在的局限性,并概述了将基于跨注意的信号与较少人类反馈相结合的未来工作。
lami:多模式人类机器人互动的大型语言模型
无缝的人类机器人相互作用(HRI)需要机器人对人类的多模式输入的熟练处理,包括语音,凝视和面部表情,以准确评估人类的影响并相应地提供帮助。同时,机器人必须通过多模态输出渠道清楚地将自己的意图清楚地传达给人类,包括语音,手势和凝视。传统上,在机器人系统中实现此功能通常需要复杂的设计。在意图估计的领域中,以前的研究通常合并意图识别模块,以基于多模式输入[3,17]对人类意图进行分类。一些系统还具有用于检测人类情感状态的专用模块,对于建立社会细微差别的互动至关重要[10,16,18]。但是,这些方法的缺点在于它们耗时且昂贵的培训过程。在输出方面,许多先前的系统集成了情绪状态[8,11]模块,以控制人形输出提示,例如音调,凝视或面部表情,增强了向人类反馈的透明度和生动性。关于运动产生,提出了多种方法,包括预先建立的运动集的混合和图表[19,25],以及使用运动捕获数据[5,9,15]。值得注意的是,这涉及与特定状态相关的每种输出模式的动作手动设计。通过利用文本理解,推理和计划的能力,在短时间内提出了许多机器人应用[7,12,14,20,21,28]。例如,Zhang等人。大型语言模型(LLM)的最新进展,诸如聊天机器人,数据过程和代码生成之类的域中的表现令人印象深刻的功能正在揭示其在机器人技术领域的潜在应用。其中一个通常的例子是“ Saycan”机器人[1],它能够解释人的自然语言命令,分析环境并生成具体的可执行操作序列,以通过使用LLMS来满足人类的要求。但是,机器人和人之间的互动提示仅限于语音命令,即使没有语音输出。最近,一些研究人员还试图将这种技术应用于HRI领域。利用LLM来估计人类有多少信任机器人[30]; Yoshida等人,使用LLMS生成低级控制命令来推动人形机器人运动以进行社会表达[29],而不是用于实践援助。Baermann等人,部署了LLM不仅遵循人类的言语命令,而且还通过人类的自然语言反馈来纠正其错误[2]。然而,通信主要依赖语音相互作用,而较少关注多模式感应和表达能力。ye等。[27]驱动了一个LLM驱动的机器人系统,该系统能够与人类在VR环境中的组装任务中合作。,但是该系统仅限于处理人类语言输入并控制虚拟空间中的单臂。通常,与快速


Hanooman:一种生成的AI和大型语言模型聊天机器人,受到Hanuman勋爵的启发
摘要本文介绍了Hanooman,这是一种生成的AI和大型语言模型聊天机器人,其灵感来自Hindu Geity Lord Hanuman。Hanooman旨在体现力量,敏捷性和奉献精神的素质,利用尖端的语言处理能力,为用户提供信息丰富且引人入胜的对话。我们探索了哈诺曼的概念框架,架构和培训程序,展示了其在各个领域的潜在应用。我们的评估结果表明,在响应准确性和上下文理解方面,Hanooman优于现有的聊天机器人,使其成为自然语言处理和人类计算机互动的有前途的工具。大语言模型(LLM)和生成AI是人工智能的重大进步,彻底改变了我们与技术的互动,生成内容和理解人类语言的方式。llms,在大量数据集中受过培训,在语言翻译,文本摘要,问题答案和创意写作等任务中表现出色。生成的AI(AI的一个子集)会产生自主输出,通常表现出惊人的创造力和连贯性。印度亿万富翁穆克什·安巴尼(Mukesh Ambani)与IIT孟买和其他八个印度技术学院合作,加入了AI竞赛,以推出“ Hanooman”,这是一集,该集合以22种印度语言培训了大型语言模型。关键字:哈诺曼,大语言模型,人工智能,生成AI1。简介
大型AI数据中心项目的建议请求(RFP)
OpenAI代表Stargate邀请合格方提交建议,以实现大规模AI数据中心的开发和建设。具体来说,Openai正在寻求地点(土地和权力)建议。目的是建立支持高级AI工作量,有助于经济发展并实现OpenAI的使命的多高夸瓦基础设施舰队。此RFP寻求提出的建议,以解决一套全面的要求,并具有确定地点和权力的特定意图,这使OpenAI的基础设施路线图能够。

可解释的AI(XAI)和大型语言模型(LLM)
➢这是一个欺骗深神经网络(DNN)的实验:在第二和第四张图像中,工程师仅保留了系统用于识别吉他和企鹅的系统的元素,并更改了其余的所有内容,以使系统仍然像吉他和企鹅一样“看到”他们。➢Goodfellow等人的作品。(2014)从普遍的扰动开始打开了进一步发展的大门(Moosavi-Dezfooli等人。2017)最近的一个像素攻击,该攻击显示了如何通过在输入图像中更改一个像素来欺骗神经网络。笔记本在这里一张像素攻击原始纸
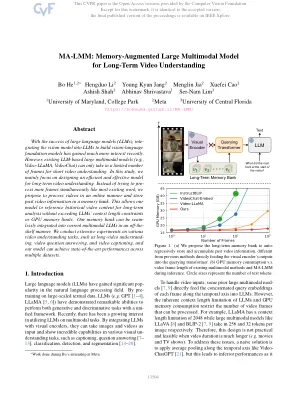
ma-lmm:长期视频理解的内存大型多模型
随着大型语言模型(LLM)的成功,将视觉模型融入了LLM,以建立视觉语言基础模型最近引起了人们的兴趣。但是,现有的基于LLM的大型多模式模型(例如,视频播放,视频聊天)只能摄入有限数量的框架以进行简短的视频理解。在这项研究中,我们主要专注于设计一个有效有效的模型,以进行长期视频理解。我们建议以在线方式处理视频并将过去的视频信息存储在存储库中,而不是像大多数现有作品一样尝试同时进行更多框架。这使我们的模型可以参考历史视频内容以进行长期分析,而不会超过LLM的上下文长度约束或GPU内存限制。我们的内存库可以以现成的方式被缝制到当前的多模式LLMS中。我们在各种视频理解任务上进行了广泛的实验,例如长期介绍,视频问题答案和视频字幕,我们的模型可以在多个数据集中实现最新的性能。
Megascale:将大型语言模型培训扩展到10,000多个GPU
Qi Huang 1 Yangrui Chen 1 Zhi Zhang 1 Yanghua Peng 1 Xiang Li 1 Cong Xie 1 Shibiao Nong 1 Yulu Jia 1 Sun He 1 Hongmin Chen 1 Zhihao Bai 1 Qi Hou 1 Shipeng Yan 1 Ding Zhou 1 Yiyao Sheng 1 Zhuo Jiang 1 Haohan Xu 1 Haoran Wei 1 Zhang Zhang 1 Pengfei Nie 1 Leqi Zou 1 Sida Zhao 1 Liang Xiang 1 Zherui Liu 1 Zhe Li 1 Xiaoying Jia 1 Jianxi Ye 1 Xin Jin 2 , Xin Liu 1
大脑和大型fMRI数据中功能性脑网络的层次结构建模
大规模脑成像数据集的一个主要目标是提供用于研究异质弹出的资源。从这些数据集中为各个受试者提供功能性脑网络的表征将具有预测认知或临床特征的巨大潜力。我们第一次提出了一种技术,即概率的功能模式(sprofumo),该技术可扩展到英国生物库(UKB),有预期的100,000名参与者,并且在个人和人群中层次估算了层次的功能性脑网络,同时对两种信息之间的双向流量进行了影响。使用仿真,我们显示了模型的效用,尤其是在涉及显着的跨主题可变性的情况下,或者需要在网络之间划定细粒度的差异。随后,通过将模型应用于4999名UKB受试者的静止状态fMRI,我们将静止状态网络(RSN)绘制为单个受试者,其详细范围比以前在UKB(> 100 rsns)中可能绘制了,并证明这些RSN可以预测somecorimotor andsocorimotor and somecorimotor and Emperife and Elighe colesions and Level Consoge。此外,我们证明了该模型的几个优点,而不是独立的组件分析与双重回归(ICA-DR)相结合,尤其是在估计RSN的空间配置和认知性状的预测能力方面。所提出的模型和结果可以为将来从大数据中对个性化的脑功能纤维进行调查打开新的门。