
XiaoMi-AI文件搜索系统
World File Search System实时

简短:用于踏板期间定量动态拟合的实时评估系统
在这项研究中,开发了用于踩踏过程中定量动态拟合的实时评估系统。该系统由LED标记,连接到计算机的数码相机和标记检测程序。LED标记附着在矢状面上的臀部,膝盖,踝关节和第五元。PlayStation3 Eye被选为本文中的主要数码相机具有许多使用运动捕获的优点,例如高FPS(每秒帧)约180fps,320×240分辨率和易于使用的低成本。制造商检测程序是通过将LabView2010与Vision Builder一起使用的。该程序由三个部分组成:图像采集和处理,标记检测和关节角度计算以及输出部分。数码相机的映像是在95FPS中获取的,并且设置了程序以实时测量较低的接头角度,以将用户作为图形提供,并允许将其保存为测试文件。通过使用Holmes方法在每个马鞍高度下在每个马鞍高度处进行三个鞍高度(膝盖角:25、35、45 O)和三个节奏(30、60、90 rpm)的踩踏板验证系统,这是一种测量下肢角度的方法,以确定鞍高的高度。结果显示,系统的平均误差和强相关性,分别是1.18±0.44 o,0.99±0.01 o。由于马鞍高度的变化,几乎没有错误,但节制发生了绝对错误。考虑到平均误差约为1°,它是用于定量动态拟合评估的合适系统。在未来的研究中,必须使用两个具有额叶和矢状平面的数码相机来减少误差。
边缘的计算机视觉:使用redmycow系统实时实时识别
在精确的牲畜种植中,牛的个体识别对于为赋予动物福利,健康和生产力做出的决定提供了至关重要的。在文字中,存在可以读取耳罩的模型;但是,它们不容易携带到现实世界中的牛生产环境,并主要在静止图像上做出预测。我们提出了一个基于视频的牛耳牌阅读系统,称为deRmycow,该系统利用视频中的节奏特性来准确检测,跟踪和读取边缘设备上25 fps的牛耳标。对于视频中的每个帧,ReDmycow在两个步骤中发挥作用。1)标签检测:Yolov5s对象检测模型和NVIDIA DEEPSTREAM跟踪层检测并跟踪存在的标签。2)标签读数:小说whentoread mod-ule决定是读取每个标签,使用trba场景文本识别模型或使用从前框架上读取的读数。该系统是在边缘设备上实现的,即NVIDIA JETSON AGX ORIN或XAVIER,使其可移植到没有外部计算资源的牛生产环境中。要达到实时速度,请阅读 - MyCow仅在当前框架中读取检测到的标签,如果它认为在当前框架中明显改善决策时,它将获得更好的读数。理想情况下,这意味着即使标签被遮挡或模糊,也可以在视频中找到标签的最佳读数并存储在视频中。在真正的中西部奶牛场住房测试该系统时,9,000头母牛,雷米科(Demmycow)系统准确地阅读了96.1%的印刷耳廓,并证明了其现实世界中的商业潜力。devmycow为商业牛农场提供了知情的数据驱动决策流程的机会。

仿真使Skyrmion动力学与实时实验对齐
Skyrmions是表现出类似粒子的特性的纳米到微米尺寸的磁旋转,可以通过电流有效地移动。这些属性使Skyrmions成为新型数据存储或计算机的绝佳系统。但是,为了优化此类设备,通常在计算上太昂贵了,无法模拟Skyrmions的复杂内部结构。
深度学习实时卫星对张量处理单元的姿势估计
I.简介基于v iSion的导航是下一代On-On-On-On-On-On-Os-andActivedEbrisredebremoval任务的关键技术。在这些情况下,指导和控制定律应采用相对的Chaser-Chaser-Toget姿势(即位置和态度)喂食,这可能会从单眼图像中方便地估算,因为这些传感器是简单,光线的,并且消耗了很少的功率。传统上,图像处理算法分为1)手工制作的特征[1,2]和2)基于深度学习的[3-14]。然而,前者受到较低鲁棒性的影响,对典型的空间图像特征(例如,信噪比低,严重和迅速变化的照明条件)和背景。神经网络(NNS)可以通过适当的培训克服此类弱点,但通常会导致高计算负担,这与典型的船上处理能力几乎不兼容。
twinlitenet+实时可驱动区域和车道分割的更强模型
结合了标准和深度可分离的扩张卷积,降低了复杂性,同时保持了高度的准确性。它有四种配置,从强大的194万参数Twinlitenet +大到超轻量级34K参数Twinlitenet + Nano。值得注意的是,TwinliteNet +大的达到了92.9%的MIOU(平均交叉路口),用于驱动面积分割,而车道分割的34.2%IOU(与联合的交集)为34.2%。 这些结果实现了能力的性能,超过了当前的最新模型,而仅需少11倍的浮点操作(FLOP)才能计算。 在各种嵌入式设备上进行了严格评估,TwinliteNet +表现出了有希望的LASCENCE和功率效率,从而强调了其对现实世界自动驾驶汽车应用的潜力。 该代码可在https://github.com/chequanghuy/twinlitenetplus上找到。达到了92.9%的MIOU(平均交叉路口),用于驱动面积分割,而车道分割的34.2%IOU(与联合的交集)为34.2%。这些结果实现了能力的性能,超过了当前的最新模型,而仅需少11倍的浮点操作(FLOP)才能计算。在各种嵌入式设备上进行了严格评估,TwinliteNet +表现出了有希望的LASCENCE和功率效率,从而强调了其对现实世界自动驾驶汽车应用的潜力。该代码可在https://github.com/chequanghuy/twinlitenetplus上找到。

通过实时面部识别增强安全性
庞迪切里大学,印度帕德切里摘要:随着暴力犯罪者(包括儿童性犯罪者)的累犯率令人震惊,对维护脆弱环境的高级安全措施的需求越来越紧迫。学校,育儿中心和其他高风险地区特别容易受到潜在威胁的影响,因此必须实施积极的解决方案,以确保儿童和员工的安全和福祉。在很大程度上依赖安全人员手动监控的传统监视系统正越来越多地证明实时识别和应对威胁的不足。人类的监督通常受到诸如延迟反应和判断错误之类的局限性,留下了关键的安全差距。我们建议的工作提供了一种新颖的视频监视系统,该系统使用DeepFaceNet,这是一种高度优化和模块化的深度学习模型,旨在克服这些困难。由于该技术主要旨在处理监视摄像机的实时视频供稿,因此它可以识别和检测具有犯罪背景的人的面孔,尤其是那些被归类为高风险罪犯的人。通过利用最新的面部识别技术,我们建议的系统提供了强大而全面的威胁检测解决方案。随着公共安全的改善,它还可以抑制犯罪行为,这有助于避免这种事件。该系统通过强调高精度,实时处理和可靠性来解决并确保安全和监视领域的更安全环境。索引术语:面部识别,深度学习,深度,监视,安全性。
实时语义立体声匹配-IRIS
摘要 - 场景的理解在机器人技术,自动化,增强现实和许多其他领域至关重要。为了完全完成此任务,一个自主代理必须推断感应场景的3D结构(要知道它的位置)及其内容(了解它看到的内容)。为了解决这两个任务,经过训练的深度神经网络,从立体声图像中推断出语义细分和深度通常是首选的选择。特别是,可以独立训练这两个任务的独立模型或端到端的端到端体系结构来解决语义立体声匹配。到目前为止,这两种解决方案都是不具备的,因为在前一种情况下需要两个正向通行证,或者由于后者中单个网络的复杂性,尽管共同解决这两种任务通常在准确性方面是有益的。在本文中,我们为实时语义立体声匹配提供了一个紧凑而轻巧的体系结构。我们的框架以多阶段的方式依赖于粗到实体的估计,允许:i)即使在嵌入式设备上也非常快速推断,并且与最先进的网络相比,准确性下降的准确性下降,ii)根据特定的应用程序要求,速度的贸易准确性。与独立任务相比,在高端GPU以及嵌入式Jetson TX2上确保语义立体声匹配的优越性,并突出了我们框架在任何硬件和任何应用程序上的多功能性。
与Blynk IoT集成的危险动物检测的深度学习用于实时警报
人们的安全,农业和生物多样性都受到与动物有关的威胁的严重威胁,例如野生动植物与车辆和牲畜入侵之间的碰撞。伤害,死亡,经济损失和对自然生态系统的干扰都是这些灾难的结果。由于这些事件变得越来越频繁,创造性的方法来识别和成功降低这些风险。在实时管理危害方面,诸如物理障碍和手动监控之类的传统技术通常不足。物联网(IoT)和深度学习的新发展提供了令人鼓舞的答案。卷积神经网络(CNN),尤其是使深度学习能够在包括保护区,农场和道路在内的各种环境中准确识别和分类动物。深度学习可用于训练模型以识别各种物种并预测其运动模式,从而使先发制人的行动能够阻止不幸和伤害。深度学习与物联网技术相结合,提高了系统的实时功能。可以通过摄像机,运动探测器和温度传感器等物联网设备的互联网进行可以不断监视动物活动,这些设备也可以引发瞬时反应,例如自动屏障或警报。 通过Blynk IoT等平台使这些系统的遥控和管理可行,该平台可以保证利益相关者可以及时收到通知并从任何位置采取必要的步骤。 这个物联网和深度学习组合为危险动物检测提供了完整的解决方案。可以不断监视动物活动,这些设备也可以引发瞬时反应,例如自动屏障或警报。通过Blynk IoT等平台使这些系统的遥控和管理可行,该平台可以保证利益相关者可以及时收到通知并从任何位置采取必要的步骤。这个物联网和深度学习组合为危险动物检测提供了完整的解决方案。通过降低事故的数量,它不仅可以提高安全性,而且还可以通过使牛摆脱困境和保护作物来帮助农业。此外,它对于野生动植物保护至关重要,因为它在受保护区域提供了非侵入性监测。对于人和野生动植物,这种方法通过提供可扩展,有效和实时系统来帮助创造更安全和可持续的环境。
基于以上为中心的视觉模型,基于便携式实时智能助手
图4。Egovideo-VL模型的概述。 eGovideo-VL是一种旨在实时自我中心的理解和援助的多模式视觉语言模型。 该模型包含五个关键组件:(1)遵循Egovideo [58]的设计模态编码器,并包括一个视频编码器和用于多模式特征提取的文本编码器; (2)存储模块,该模块存储历史上下文以实现时间基础,摘要和个性化互动; (3)大型语言模型(LLM),该模型执行多模式推理和响应生成; (4)生成模块,该模块综合了视觉动作预测,以指导用户完成任务; (5)检索模块,该模块检索第三人称专家演示以补充以自我为中心的理解。Egovideo-VL模型的概述。eGovideo-VL是一种旨在实时自我中心的理解和援助的多模式视觉语言模型。该模型包含五个关键组件:(1)遵循Egovideo [58]的设计模态编码器,并包括一个视频编码器和用于多模式特征提取的文本编码器; (2)存储模块,该模块存储历史上下文以实现时间基础,摘要和个性化互动; (3)大型语言模型(LLM),该模型执行多模式推理和响应生成; (4)生成模块,该模块综合了视觉动作预测,以指导用户完成任务; (5)检索模块,该模块检索第三人称专家演示以补充以自我为中心的理解。
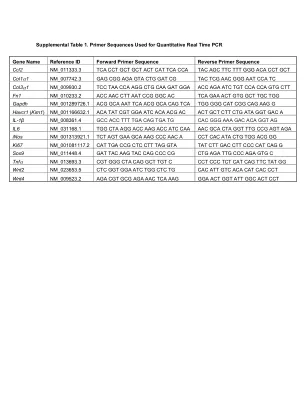
补充表1。用于定量实时PCR的引物序列
havcr1(kim1)NM_001166632.1 ACA TAT CGT GGA ATC ACA ACG ACG AC AC AC AC ACT GCT CTT CTG CTG ATA GGT GAC A