
XiaoMi-AI文件搜索系统
World File Search System对象

CS151,面向对象设计,06,秋季,2022
● 编程作业 (25 %) 将会有几项编程作业,涉及 OO 编程、OO 设计和 UML 图。所有作业都是个人作业。逾期的作业将不被接受。 ● 测验 (10 %) 每章之后都会有简短的测验。这些测验的目的是鼓励学生阅读课程材料并理解概念。这些测验的目的是帮助学生更好地理解概念并将其应用于作业以及为期中和期末考试做准备。 ● 项目 (20 %) 每学期最后一个月,每个小组由 3 名成员组成一个小组项目,涉及 OO 设计和 GUI 编程。 ● 期中和期末(各占 20 %) 将会有一次期中考试和一次期末考试,包括选择题和书面答案。问题可以来自测验、课堂笔记、幻灯片、作业和课堂讨论。 ● 课堂参与 (5 %) 为鼓励参与,您的期末成绩的 5% 将来自您的参与。请注意,参与并不等于出席。
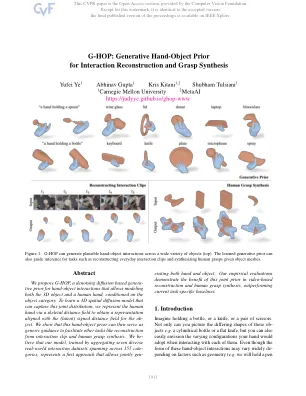
g-hop:相互作用重建的生成性手动对象和掌握合成
和一个锅的不同)或意图(例如通过刀与使用它进行切割),我们人类可以毫不费力地描绘出与日常生活中日常物体的这种互动。在这项工作中,我们的目标是构建一个可以同样生成合理的手动配置的计算系统。具体来说,我们学习了一个基于扩散的常规模型,该模型捕获了3D相互作用期间手和对象的关节分布。给定一个类别的描述,例如“握着板的手”,我们的生成模型可以合成人手的相对配置和表达(见图1个顶部)。我们解决的一个关键问题是,该模型是什么好的HOI表示。通常通过空间(签名)距离场来描述对象形状,但人的手通常是通过由发音变量控制的参数网格建模的。我们提出了一个均匀的HOI表示,而不是在生成模型中对这些不同的代表进行建模,并表明这允许学习一个共同生成手和对象的3D扩散模型。除了能够合成各种合理的手和物体形状的综合外,我们的扩散模型还可以在跨任务的辅助推理之前作为通用,而这种表示是所需的输出。例如,重建或预测相互作用的问题对于旨在向人类学习的机器人或试图帮助他们的虚拟助手来说是核心重要性。重建的视频重新投影错误)或约束(例如我们考虑了这些行沿着这些行的两个经过深入研究的任务:i)从日常交互剪辑中重建3D手对象形状,ii)鉴于任意对象网格,合成了合理的人类grasps。为了利用学到的生成模型作为推论的先验,我们注意到我们的扩散模型允许在任何手动对象配置给定的(近似)log-likelihood梯度计算(近似)log-likelihoodhoodhood。我们将其纳入优化框架中,该框架结合了先前的基于可能性的指南与特定于任务的目标(例如已知对象网格的合成)推理。虽然理解手动相互作用是一个非常流行的研究领域,但现实世界中的数据集限制了3D中这种相互作用的限制仍然很少。因此,我们汇总了7种不同的现实世界交互数据集,从而导致157个对象类别的相互作用长期收集,并在这些范围内训练共享模型。据我们所知,我们的工作代表了第一个可以共同生成手和对象的生成模型,并且我们表明它允许综合跨类别的各种手动相互作用。此外,我们还经验评估了基于视频的重建和人类掌握合成的任务的先前指导的推断,并发现我们所学的先验可以帮助完成这两个任务,甚至可以改善特定于特定于任务的状态方法。
带有嵌入式系统的无人飞行器基于深度学习的对象检测
编辑委员会博士Mustafa Necmiİlhan博士 - 加兹大学 - Özlemçakir博士 - DokuzEylül大学协会。MehmetMerveÖzaydın-AnkaraHacıBayramVeli University Assoc。
评估对象对象的基于视觉模型的弹性...
摘要。鉴于对最近的基于视觉模型的大规模多模式培训及其概括能力,因此了解其鲁棒性的程度对于他们的现实世界部署至关重要。在这项工作中,我们的目标是评估当前基于视觉模型的弹性,以应对不同的对象到后环上下文变化。大多数鲁棒性评估方法都引入了合成数据集,以引起对物体特征(观点,比例,颜色)的变化或实际图像上使用的图像转换技术(对抗性变化,常见的损坏),以模拟分离中的变化。最近的作品探索了利用大型语言模式和di!使用模型来产生背景变化。但是,这些方法要么缺乏对要进行的更改或扭曲对象语义的控制,从而使它们不适合任务。另一方面,我们的方法可以诱导各种对象兼容地面变化,同时保留对象的原始语义和对象的真实性。为了实现这一目标,我们利用文本对图像,图像到文本和图像对段的生成能力自动生成广泛的对象到背景的变化。我们通过修改文本提示或优化文本模型的潜伏期和Textual嵌入来引起自然和对抗背景的变化。这使我们能够量化背景上下文在理解深神经网络的鲁棒性和一般性中的作用。我们生产了各种版本的标准视觉数据集(Imagenet,Coco),将多样的和相同的背景纳入图像中,或在背景中引入颜色,纹理和对抗性变化。我们进行了彻底的实验,并对基于视觉模型的鲁棒性与对象之间的背景环境之间的鲁棒性进行了深入的分析。我们的代码和评估基准将在https://github.com/muhammad-huzaifaa/ObjectCompose上找到。

Unimode:统一的单眼3D对象检测
实现统一的单眼3D对象检测,包括室内和室外场景,在机器人导航等应用中非常重要。然而,涉及各种数据方案来训练模型引起了挑战,因为它们的特性显着不同,例如,二 - 几何特性和异质域分离。为了应对这些挑战,我们根据鸟类的视图(BEV)检测范式建立了一个检测器,在该检测范式中,当采用多个数据方案以训练检测器时,明确的特征投影有利于对几何学学习模棱两可。然后,我们将经典的BEV检测体系结构分为两个阶段,并提出了不均匀的BEV网格设计,以处理由上述Challenges引起的收敛不稳定。此外,我们开发了稀疏的BEV功能策略,以降低计算成本和处理异质域的统一操作方法。将这些技术结合起来,得出了一个统一的检测器Unimode,它超过了富有挑战性的Omni3D数据集(一个大规模的数据集(一个室内和室外场景))的先前最先进的AP 3D,揭示了Bev bev tor tor tor tor tor tor tor unified 3D对象的第一个成功概括。

多视图3D对象检测的多视图actentive上下文化
我们介绍多视图的细心上下文化(MVACON),这是一种简单而有效的方法,用于改善基于查询的多视图3D(MV3D)对象检测中的2D- TO-3D功能。尽管在基于查询的MV3D对象检测的领域取得了显着的进展,但先前的艺术通常会因高分辨率的高分辨率2D特征而缺乏基于密集的注意力提升的高分辨率2D特征,或者由于高计算成本,或者由于3D Queries的高度密集地接地不足,无法以3D Queries的高度质量为基于稀疏注意的多级2D功能。我们提出的MVACON使用代表密集但计算稀疏的细心特征连续化方案击中了两只鸟,该方案对特定的2d到3d feleture提升方法不可知。在实验中,使用BEVFormer及其最近的3D变形注意(DFA3D)变体以及PETR对纳斯曲霉基准进行了彻底的测试,并显示出一致的检测性能提高,尤其是在位置,方向和VELOCITY PRECTICTAR中提高了一致的检测性能。还可以在Waymo-Mini基准测试器上进行测试,并具有类似的改进。我们在定性和定量上表明,基于全局群集的上下文有效地编码了MV3D检测的密集场景级上下文。我们提出的MVA-CON的有希望的结果加强了计算机视觉中的格言 - “(contectu-alsized)特征事项”。
在挑战性的天气条件下可靠的对象检测
对象检测在各种自主系统中至关重要,例如监视,自动驾驶和驾驶员的稳定性,通过识别行人,车辆,交通信号灯和标志来确保安全。然而,诸如雪,雾和雨等不利天气条件构成了挑战,具有检测准确性,冒险发生事故和大坝。这清楚地表明了在所有天气条件下都起作用的强大观察检测解决方案的必要性。我们采用了三种策略来增强不利天气中的基于深度学习的对象检测:对全球全天候图像进行培训,对图像进行培训,并具有合成的增强天气噪声,并将对象的变形与不利天气图像denosistighting进行整合。使用分析方法,GAN网络和样式转移网络产生合成天气噪声。我们使用BDD100K数据集中的真实世界全天候图像和用于评估未见现实世界的不利天气图像的评估,通过训练对象进行分割模型比较了这些策略的性能。通过降级现实世界的不利天气图像以及对物体检测的结果和原始嘈杂图像的结果进行了评估,从而评估了不利天气。我们发现,使用全天候现实世界图像训练的模型表现最佳,而对对象检测进行对象检测的策略则表现最差。
基于事件流的视觉对象跟踪-CVF打开访问
以生物风格的活动相机跟踪近年来引起了人们的兴趣。现有的作品要么利用对齐的RGB和事件数据进行准确跟踪,要么直接学习基于事件的跟踪器。前者会产生较高的推理成本,而后者可能容易受到嘈杂事件或稀疏空间分辨率的影响。在本文中,我们提出了一个新型的分层知识蒸馏框架,该框架可以在培训期间完全利用多模式 /多视图信息,以促进知识转移,使我们能够仅使用事件信号来实现测试过程中高速和低潜伏期视觉跟踪。特别是,基于教师变压器的多模态跟踪框架首先是通过同时喂食RGB框架和事件流来训练的。然后,我们设计了一种新的分层知识蒸馏策略,其中包括成对相似性,功能表示和基于响应地图的知识蒸馏,以指导学生变形金刚网络的学习。在术语中,由于现有的基于事件的跟踪数据集都是低分辨率(346×260),因此我们提出了名为EventVot的第一个大规模高分辨率(1280×720)数据集。它包含1141个视频,并涵盖了许多类别,例如行人,车辆,无人机,乒乓球等。对低分辨率(Fe240Hz,Vi-Sevent,Coesot)和我们新提出的高分辨率EventVot数据集的进行了实验进行了实验
用移动操作的交互式对象搜索语言的动态场景图
摘要 - 为了充分利用移动操纵机器人的功能,必须在大型未探索的环境中自主执行的长途任务。虽然大型语言模型(LLMS)已显示出关于任意任务的紧急推理技能,但现有的工作主要集中在探索的环境上,通常集中于孤立的导航或操纵任务。在这项工作中,我们提出了MOMA-LLM,这是一种新颖的方法,该方法将语言模型基于从开放式摄影场景图中得出的结构化表示形式,随着环境的探索而动态更新。我们将这些表示与以对象为中心的动作空间紧密地交织在一起。重要的是,我们证明了MOMA-LLM在大型现实室内环境中新型语义交互式搜索任务中的有效性。最终的方法是零拍摄,开放式摄影库,并且可以易于扩展到一系列移动操作和家用机器人任务。通过模拟和现实世界中的广泛实验,与传统的基线和最新方法相比,我们证明了搜索效率的显着提高。我们在http://moma-llm.cs.uni-freiburg.de上公开提供代码。
开放式对象检测的生成区域训练
在最近的研究中,已对开放式摄制对象检测任务进行了大量关注,旨在概括训练期间标记的类别的有限级别,并检测推理时任意类别名称所描述的对象。与常规对象检测相比,打开的词汇对象检测在很大程度上扩展了对象检测类别。但是,它依赖于计算图像区域与一组具有验证视觉和语言模型的任意类别名称之间的相似性。这意味着,尽管具有开放式的性质,但该任务仍然需要在推理阶段的预定义对象类别。这提出了一个问题:如果我们在推理中对对象类别没有确切的了解,该怎么办?在本文中,我们称之为新的设置为生成性开放式对象检测,这是一个更普遍和实际的问题。为了解决它,我们将对象检测形式为生成问题,并提出了一个名为generateu的简单框架,该框架可以检测密集的对象并以自由形式的方式生成其名称。尤其是,我们采用可变形的DETR作为区域促成生成器,其语言模型将视觉区域转换为对象名称。为了评估自由形式的对象划分任务,我们介绍了一种评估方法,旨在定量测量生成量的性能。广泛的实验表明我们的生成量强烈的零射击性能。代码可在以下网址获得:https://github.com/foundationvision/generateu。例如,在LVIS数据集上,我们的GenerateU在推理过程中属于类别名称,即类别名称无法看到类别名称,即使类别名称看不见类别名称,我们的GenerateU也可以与开放式唱机对象检测方法GLIP相当。