
XiaoMi-AI文件搜索系统
World File Search System扩散
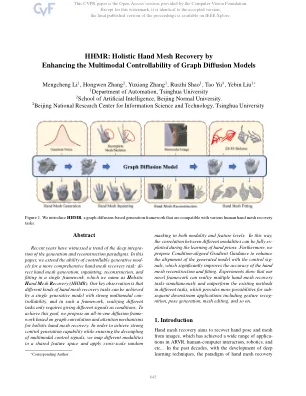
HHMR:通过增强图扩散模型的多模式可控性
近年来见证了一代和重建范式深入融合的趋势。在本文中,我们扩展了可控制的生成模块的能力,以实现更全面的手网恢复任务:在单个框架中,手工网格的生成,内部网状,重建,重建和拟合,我们将其命名为H olistic H和MESH R Ecovery(HHMR)。我们的主要观察结果是,具有强大多模式可偿还性的单个生成模型可以实现不同类型的手网恢复任务,并且在这样的框架中,实现不同的任务只需要给出不同的信号作为条件。为了实现这一目标,我们提出了基于图形卷积和整体手工网状恢复的注意力卷积和注意力机制的多合一扩散框架。为了实现强大的控制能力,同时确保多模式控制信号的解耦,我们将不同的模态映射到共享特征空间并应用跨尺度随机

稳定扩散启用水下深度估计
单眼深度估计在近年来,由于深度学习的进步,近年来在陆地图像上取得了重大进展。,但主要是由于数据稀缺性而导致的水下场景不足。鉴于水中的光衰减和背面的固有挑战,获得清晰的水下图像或精确的深度非常困难且昂贵。为了减轻此问题,基于学习的方法通常依赖于综合数据或转向自欺欺人或无监督的举止。尽管如此,它们的性能通常受到域间隙和宽松的约束而阻碍。在本文中,我们提出了一种新的管道,用于使用准确陆地深度生成感性的水下图像。这种方法有助于对水下深度估计的模型进行超级培训,从而有效地降低了限制和水下环境之间的性能差异。与以前的合成数据集相反,这些数据集仅将样式转移应用于没有场景内容的情况下的Terres试验图像,我们的方法通过通过创新的STA-

使用预先训练的垂直二维扩散模型改善三维成像
扩散模型由于其众多优点已成为一种流行的图像生成和重建方法。然而,大多数基于扩散的逆问题解决方法仅处理二维图像,即使是最近发表的三维方法也没有充分利用三维分布先验。为了解决这个问题,我们提出了一种新方法,使用两个垂直的预训练二维扩散模型来解决三维逆问题。通过将三维数据分布建模为不同方向切片的二维分布的乘积,我们的方法有效地解决了维数灾难。我们的实验结果表明,我们的方法对于三维医学图像重建任务非常有效,包括 MRI Z 轴超分辨率、压缩感知 MRI 和稀疏视图 CT。我们的方法可以生成适合医疗应用的高质量体素体积。代码可在 https://github.com/hyn2028/tpdm 获得
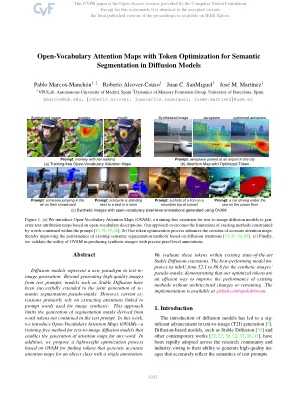
在扩散模型中使用令牌优化的开放式摄取注意图
扩散模型代表文本到图像生成中的新范式。除了从文本提示中生成高质量的图像之外,诸如稳定扩散之类的模型已成功扩展到了共同生成的分段伪遮罩。但是,当前的敏感主要依赖于提取与用于图像合成的及时单词相关的关注。这种方法限制了从文本提示中未包含的单词代币中得出的分割掩码的产生。在这项工作中,我们介绍了开放式摄影注意力图(OVAM) - 用于文本到图像扩散模型的无训练方法,可为任何单词生成注意力图。此外,我们提出了一个基于OVAM的轻巧优化过程,用于查找具有单个注释的对象类的准确注意图。

训练扩散模型通过增强学习
扩散模型在图像生成中表现出了前所未有的ca。然而,它们从原始训练集中纳入并扩大了数据偏差(例如性别,年龄),从而限制了产生的IMEG的多样性。在本文中,我们在基于图像集的重新函数的指导下,使用增强学习(RL)提出了一种面向多样性的细调方法(RL)。具体而言,所提出的奖励函数(表示为多样性奖励),利用一组生成的信息来评估当前生成分配W.R.T.的覆盖范围。参考分布,由一组无偏见的图像表示。建立在分布差异估计的概率方法的基础上,差异奖励可以有效地用一小部分图像来测量相对分布差距。我们进一步将扩散过程作为多步决策问题(MDP),并通过最大化多样性奖励来应用策略梯度方法来微调扩散模型。在放样后选择任务上验证了奖励,其中根据多样性奖励值选择了最多样化的图像的子集。我们还展示了我们的RL微调框架的有效性,可以通过不同类型的扩散模型(包括班级条件模型和文本条件模型,例如stablediffusion)增强图像生成的多样性。
扩散-ES:无梯度计划,扩散自主和指导引导
扩散模型在建模复合物和多模态轨迹分布方面表现出色,以进行决策和控制。最近提出了奖励级别指导的denoising,以生成轨迹,从而最大程度地提高了可差异的奖励函数,又是扩散模型捕获的数据分布下的可能性。奖励级别指导的denoisising需要适合清洁和噪声样本的可区分奖励功能,从而限制了其作为一般轨迹优化器的应用。在本文中,我们提出了扩散-ES,一种将无梯度优化与轨迹deNoising结合起来的方法,以优化黑框非差异性目标,同时留在数据管理中。扩散-ES样品在进化过程中的轨迹 - 从扩散模型中搜索,并使用黑框奖励函数得分。它使用截断的扩散过程突变高得分轨迹,该过程应用了少量的no弱和降解步骤,从而可以更有效地探索解决方案空间。我们表明,扩散-ES在Nuplan上实现了最先进的表现,Nuplan是一个已建立的闭环计划基准,用于自动驾驶。扩散-ES的表现优于现有的基于抽样的计划者,反应性确定性或基于扩散的策略以及奖励梯度指导。此外,我们表明,与先前的指导方法不同,我们的方法可以优化由少数弹药LLM提示产生的非差异性语言形状奖励功能。这使我们能够解决最困难的NUPLAN场景,这些方案超出了现有的传统优化方法和驾驶策略的能力。在以遵循指示的人类老师的指导下,我们的方法可以产生新颖的,高度复杂的行为,例如训练数据中不存在的积极的车道编织。1

使用扩散模型在潜在空间中进行图像修复
使用扩散模型进行图像修复通常使用预条件模型(即针对绘画任务进行微调的图像条件模型)或后条件模型(即在推理时重新用于绘画任务的非条件模型)。预条件模型在推理时很快,但训练成本极高。后条件模型不需要任何训练,但在推理过程中很慢,需要多次前向和后向传递才能收敛到理想的解决方案。在这里,我们推导出一种不需要昂贵训练但推理速度很快的方法。为了解决昂贵的推理计算时间,我们在潜在空间而不是图像空间上执行前向-后向融合步骤。这是通过扩散过程中新提出的传播模块解决的。在多个领域进行的实验表明,我们的方法达到或改善了状态

MatFuse:利用扩散模型实现可控材料生成
在计算机图形学中创建高质量的材质是一项具有挑战性且耗时的任务,需要很高的专业知识。为了简化这个过程,我们引入了 MatFuse,这是一种统一的方法,它利用扩散模型的生成能力来创建和编辑 3D 材质。我们的方法整合了多种条件来源,包括调色板、草图、文本和图片,增强了创造可能性并对材质合成进行了细粒度的控制。此外,MatFuse 通过多编码器压缩模型的潜在操作实现了地图级材质编辑功能,该模型可以学习每个地图的解开的潜在表示。我们在多种条件设置下展示了 MatFuse 的有效性,并探索了材质编辑的潜力。最后,我们根据 CLIP-IQA 和 FID 分数定量评估生成材质的质量,并通过开展用户研究定性评估生成材质的质量。用于训练 MatFuse 的源代码和补充材料可在 https://gvecchio.com/matfuse 上公开获取。

真实srgd:使用无分类器引导扩散
摘要。现实世界图像超分辨率(RISR)旨在从退化的低分辨率(LR)输入中重新结构高分辨率(HR)图像,以应对诸如模糊,噪声和压缩工件之类的挑战。与传统的超分辨率(SR)不同,该方法通过合成的下采样来典型地生成LR图像,而RISR则是现实世界中降级的复杂性。为了有效地应对RISR的复杂挑战,我们适应了无分类器指导(CFG),这是一种最初用于多级图像生成的技术。我们提出的方法,真实的SRGD(带有无分类器引导扩散的现实世界图像超分辨率),将RISR挑战分解为三个不同的子任务:盲图恢复(BIR),常规SR和RISR本身。然后,我们训练针对这些子任务量身定制的类别条件SR扩散模型,并使用CFG来增强现实世界中的超分辨率效果。我们的经验结果表明,实际SRGD超过了定量指标和定性评估中的现有最新方法,如用户研究所证明的那样。此外,我们的方法在
基于扩散模型的机器人视觉运动策略学习
背景和动机视觉策略学习涉及将视觉观察映射到运动动作上,使机器人能够有效地与环境互动。传统方法通常在多模式作用分布的复杂性以及对高精度和时间一致性的需求中挣扎。最近引入的扩散策略通过采用有条件的降级扩散过程来生成机器人动作,从而提供了有希望的解决方案。这些模型在产生复杂的行为方面表现出了卓越的性能,使其成为机器人操纵和组装任务的理想候选人。此外,整合自然语言处理(NLP)允许多功能任务调理,使机器人能够根据人类指令执行各种任务。