
XiaoMi-AI文件搜索系统
World File Search System数据分析

CAP4631C数据分析的机器学习i
课程描述CAP4631C |数据分析的机器学习| 4.00学分,该上限课程适用于专业的数据分析学生。学生将了解为什么机器学习对于数据分析至关重要,以及为什么回归分析是监督机器学习的基础。使用Python编程,学生将使用各种软件包来创建进行预测的回归模型。先决条件:COP1047C; STA3164或CAP3330

使用充电数据分析对快速充电站进行计量误差估计
摘要 - 快速充电站(FCSS)的电力计量计算器(EEM),是电动汽车(EV)行业的关键基础设施,并且是车辆到网格(V2G)技术的重要载体,是确保公平电能交易的基石。传统的现场验证方法受其高成本和低效率限制的限制,努力与FCS的全球快速扩张保持同步。在响应中,本文采用了数据驱动的方法,并提出了测量绩效比较(MPC)方法。通过利用电荷(SOC)作为介质的估计值,MPC建立了多个FCS的EEM表现的比较链。因此,启用了具有高效率的FCS的EEM错误的估计。此外,本文总结了估计结果的干扰因素,并建立了相应的误差模型和不确定性模型。另外,提出了FCSS中是否存在EEM性能缺陷的一种方法。最后,验证了MPC方法的可行性,结果表明,对于精度级别为2%的FCSS,判别精度超过95%。MPC为FCSS的EEM绩效提供了可行的方法,为公平而公正的电力交易市场奠定了基础。

利用 RNA 测序数据分析,构建阿尔茨海默病药物再利用和 microRNA 识别流程
引言:阿尔茨海默病 (AD) 是一种进行性神经退行性疾病,全球至少有 2700 万人受其影响。这种疾病不仅严重影响患者及其家人的生活,还给社会带来沉重的经济负担。目前尚无明确的疾病改良疗法,各种疗法已被开发用于控制 AD 的症状。药物再利用是一种有价值的替代方法,可以发现已获批或正在研究的药物在其原有适应症之外的新用途。RNA 测序 (RNA-seq) 是发现疾病异质性基因表达的一种实用方法。因此,我们的研究应用了一种计算药物再利用流程,基于从 RNA-seq 数据中提取的 AD 差异基因表达特征来探索候选药物。方法与材料:从 GEO 数据库 (https://www.ncbi.nlm.nih.gov/geo/) 获取了 10 例对照和 8 例 AD 死后人类海马脑组织(登录号为 GSE173955)的表达谱。使用 GEO2R 识别 AD 与正常组织之间的差异表达基因 (DEG)。接下来,使用 LINCS 数据库识别 AD 疾病的潜在候选药物。然后,通过大量文献综述和药物研究,筛选出排名靠前的 FDA 批准药物。反过来,将 DEG 导入 STRING 数据库,以识别蛋白质之间的相互作用关联。之后,选择所有显著性综合评分为 0.7 的相互作用进行进一步分析。选择连接度最高的合适基因作为枢纽基因。靶标扫描数据库是一个专门收集 microRNA-mRNA 靶向关系的数据库。这些数据库用于获取枢纽基因相关的 miRNA。结果:本研究鉴定出 1,878 个 |log2FC| ≥ 1 且 p 值 ≤ 0.05 的基因为 DEG:909 个基因上调,969 个基因下调。能够逆转 AD 表达模式的显著改变的药物谱包括奥沙利德、莫米洛替尼和恩扎妥林。此外,S100A8 已被确定为 Cytoscape 中最突出的枢纽基因之一,在 AD 的背景下它可以被 miR-98-5p 抑制。结论和讨论:在本研究中,我们提出了几种潜在的可重新利用的候选药物,莫沙必利、莫米洛替尼和恩扎斯塔林,以及 miR-9-5p,用于治疗 AD 进展。莫沙必利目前用于治疗 2 型糖尿病、功能性消化不良、功能性便秘和上腹痛综合征。莫米洛替尼是一种 Janus 激酶 1 和 2 抑制剂,用于治疗骨髓纤维化。恩扎斯塔林已用于治疗复发性多形性胶质母细胞瘤。我们的研究结果可能指导针对不同疾病进展阶段的进一步重新利用研究。此外,我们报告 S100A8 充当炎症介质,其水平随着大脑年龄的增长而增加。MiR-98-5p 有可能抑制 AD 中的 S100A8 表达。

可访问,可重复和协作数据分析的银河平台:2024 Update
摘要星系(https://galaxyproject.org)全球范围内消失,主要是通过免费使用服务,支持每年扩大范围的用户驱动研究。用户被platf orm st abilit y,工具和参考dat Aset y多样性,培训,支持和集成的公共星系服务吸引,这可以实现复杂,可重复的,可共享的数据分析。应用用户体验设计的原理(UXD),已驱动了可访问性,通过Galaxy Labs / subdomains的工具访问性以及重新设计的Galaxy Toolshed驱动的。Galaxy工具功能正在以两个战略方向发展:整合通用图形处理单元(GPGPU)访问尖端方法和许可的工具支持。通过在银河系中开发更多的工作流程并通过为公共银河服务提供资源来运行它们,从而增加了与全球研究财团的参与。Galaxy Training网络(GTN)投资组合的规模和可访问性通过学习路径和与培训课程中功能的Galaxy工具的直接集成。代码v elopment继续与Galaxy项目路线图保持一致,并提供了工作调度和用户Interf ACE的精力。环境影响评估还可以帮助用户和De V Elopers吸引他们,通过显示每个星系作业产生的估计的CO 2排放,使他们想起了他们在维持Ainabilit y中的作用。

Galaxy中的RNA-Seq数据分析
近年来,RNA测序(简短的RNA-Seq)已成为一种非常广泛的技术,可以分析一个不断变化的细胞转录组,即一个细胞或一个细胞中的所有RNA分子的集合。RNA-seq最常见的目标之一是通过鉴定两个或多个生物学条件之间差异表达(DE)的基因或分子途径来填充基因表达。从RNA-seq数据中检测DE基因和途径的计算工作流量需要使用多种命令行工具和大多数用户可能无法访问的大量计算资源。Galaxy [1]是一个强大且易于使用的基于Web的平台,用于科学数据分析。分析中的步骤是通过运行Galaxy工具执行的,该工具描述了如何将命令行软件的参数转换为用户友好的Web界面。图形网络界面以及大量高质量,社区开发和维护的工具和培训材料,可以为新手和专家用户进行快速的交互式分析。对于分析的每个步骤,Galaxy捕获了几个元数据(例如,工具标识和版本,输入和参数)启用

请求高级研究数据分析的简短课程(...
此短期课程旨在使研究人员能够分析和解释研究数据,这对于产生可靠和有影响力的发现至关重要。它还使参与者拥有管理数据,应用统计技术和目前基于证据的见解的技能。培训是研究人员,学者和专业人员的理想选择,可提供研究数据集和现代分析工具的实践经验。加入本课程,以增强您的分析能力,并使您的研究更加严格和引人注目。
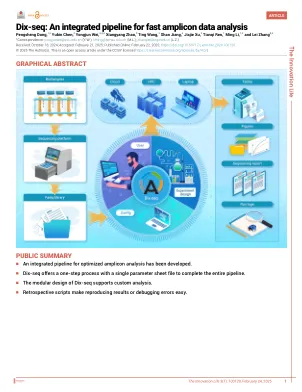
dix-seq:快速扩增子数据分析的集成管道
8 DeepBiome。Co. Ltd.,上海200031,中国 *通信:yongjunwei@zzu.edu.cn(y.w. ); liming@henau.edu.cn(M.L。 ); zhanglei@logictek.cn(L.Z.) 收到:2024年10月18日;接受:2025年2月21日;在线发布:2025年2月22日; https://doi.org/10.59717/j.xinn-life.2024.100120©2025作者。 这是CC下的开放访问文章(https://creativecommons.org/licenses/4.0/)。 引用:Dong P.,Chen Y.,Wei Y.等。 (2025)。 dix-seq:用于快速扩增子数据分析的集成管道。 创新生活3:100120。 在过去十年中,测序技术的快速进步推动了Amplicon Metagenome的广泛采用。 但是,当前的Amplicon数据分析软件/管道通常需要手动干预跨越多个步骤,因此需要清楚了解参数,并阻碍缺乏经验的用户自动化其工作流程。 在这里,我们介绍了Dix-Seq,这是一种完全容器化的工具,用于快速,自动化和可扩展的扩增子数据分析。 使用一个单个命令,DIX-Seq可以将原始扩增子序列处理为各种统计和可视化结果,生成基于HTML的报告和恢复的日志文件。 dix-seq利用单个参数表可以大大简化其命令行接口,从而使其不受欢迎的用户更容易实现,同时改善了研究可重复性。 DIX-SEQ的模块化设计使得将新方法和数据库的快速采用到其软件框架中。Co. Ltd.,上海200031,中国 *通信:yongjunwei@zzu.edu.cn(y.w.); liming@henau.edu.cn(M.L。); zhanglei@logictek.cn(L.Z.)收到:2024年10月18日;接受:2025年2月21日;在线发布:2025年2月22日; https://doi.org/10.59717/j.xinn-life.2024.100120©2025作者。这是CC下的开放访问文章(https://creativecommons.org/licenses/4.0/)。引用:Dong P.,Chen Y.,Wei Y.等。(2025)。dix-seq:用于快速扩增子数据分析的集成管道。创新生活3:100120。在过去十年中,测序技术的快速进步推动了Amplicon Metagenome的广泛采用。但是,当前的Amplicon数据分析软件/管道通常需要手动干预跨越多个步骤,因此需要清楚了解参数,并阻碍缺乏经验的用户自动化其工作流程。在这里,我们介绍了Dix-Seq,这是一种完全容器化的工具,用于快速,自动化和可扩展的扩增子数据分析。使用一个单个命令,DIX-Seq可以将原始扩增子序列处理为各种统计和可视化结果,生成基于HTML的报告和恢复的日志文件。dix-seq利用单个参数表可以大大简化其命令行接口,从而使其不受欢迎的用户更容易实现,同时改善了研究可重复性。DIX-SEQ的模块化设计使得将新方法和数据库的快速采用到其软件框架中。当前,已将21个以上的算法,软件和第三方程序集成到DIX-Seq中的八个模块中,而越来越多。这种方法还允许经验丰富的用户微调工作流程,从而促进定制分析。在实际案例研究的数据集上执行的基准测试了DIX-Seq的能力,该功能在生成统计信息和提取生物学上有意义的模式的完整数字中生成了发布的数字。此外,它在检测模拟测序深度下降的方差方面仍然非常有效,结果在所有和某些方面(例如植物网络多样性和Pearson的相关性),结果保持稳健至11000和1000的深度。总而言之,Dix-Seq是用于扩增数据分析的方便但高度可自定义的工具,使其成为入门级和经验丰富的用户的理想选择。

Askor,RNASEQ数据分析的R软件包
农业生态系统的生物信息学平台(BIPAA)是法国农业,食品和环境研究所(INRAE)的生物启发性平台。它致力于支持与农业生态系统相关的昆虫开发的基因组学和基因组学计划,并协助多个从事Arthopod基因组学工作的社区的合作和协调。该信息系统是十多年前创建的,以支持国际蚜虫基因组学联盟(IAGC),以注释和策划PEA蚜虫基因组[1],并经过不断的改进并扩展到phylloxera基因组的最新成就(daktulosplaira paroseraheyter paraster paraster(2])[2] Campoletis Sonorensis [3],Cotesia Congregata [4],Aphidius Ervi和Lysiphlebus Fabarum [5])或Spodoptera Frugiperda [6]。因此,BIPAA是几个公共参考数据库的所在地,包括蚜虫,鳞翅目和parwaspDB,每个数据库都有多种昆虫基因组。总共有38个基因组目前可在线获得,其基础设施已经发展为支持众多新基因组的负载并促进浏览和导航。对于每个物种,Web应用程序的集合允许用户探索参考基因组或转录组组件和注释(例如基因组浏览器,基因报告),以比较基因组学区域(同义查看器),以使用多种工具分析这些数据(例如对齐各种序列,注释,SNP预测等)通过专用的Galaxy服务器[7]或特定的Web应用程序(例如爆炸形式),或通过策划Apollo [8]中的基因组注释来纠正或添加信息。RNA-Seq研究现在负担得起,并且在许多实验室中广泛使用。在昆虫科学中,目前仍用于研究现象,例如整个昆虫的分子反应,器官和组织对不同的生物或非生物胁迫的组织,包括暴露于杀虫剂,微生物感染或对不同宿主的喂养,以及对我们对基因表达的改善与免疫的知识的改善,

数据科学和数据分析的执行MTECH -IIT Bhilai
在合格程度上至少要有55%的分数或同等的5.5 CGPA/CPI。如果属于SC,ST或残疾人(PWD)类别的候选人,则将其放松至50%或等效的5.0 CGPA/CPI。对于MCA/MSC通过了毕业生,将考虑MCA/MSC的百分比评分。对于没有PG专业化的BE/BTECH工程毕业生,将考虑本科学位的百分比评分。对于研究工程领域的毕业后,可以考虑PG评分资格。选择过程将安排在后咨询和申请过程中,具体取决于该计划的符合条件的申请数量。整个过程将在线。

性能和数据分析师
• Communicate effectively verbally, in writing, and through data visualizations • Think logically and systematically to solve complex problems • Analyze business and technical processes and determine ways of making them more efficient • Engage in building a culture of data literacy and continuous performance improvement • Seek out and propose data projects and opportunities to collaborate internally and externally • Monitor emerging technology and tools (e.g., Artificial Intelligence) and evaluate opportunities and challenges of applying new technologies以及绩效管理和数据分析的工具•在压力下工作并满足紧迫的截止日期•保持机密和专业精神