
XiaoMi-AI文件搜索系统
World File Search System文本
增强文本对图像合成的DF-GAN
摘要。文本对图像合成是机器学习中最具挑战性和最受欢迎的任务之一,许多模型旨在提高该领域的性能。深融合生成的对抗网络(DF-GAN)是图像生成的直接但有效的模型,但它具有三个关键局限性。首先,它仅支持句子级文本描述,从而限制了其从文字级输入中提取细颗粒特征的能力。第二,可以优化残差层和块的结构以及关键参数,以提高性能。第三,现有的评估指标,例如FréchetInception距离(FID),倾向于不适当地强调无关紧要的功能,例如背景,当重点放在生成特定对象上时,这是有问题的。为了解决这些问题,我们引入了一个新的文本编码器,该编码器增强了具有处理单词级描述能力的模型,从而导致更精确和文本一致的图像生成。此外,我们优化了关键参数,并重新设计了卷积和残留网络结构,从而产生了更高质量的图像并减少了运行时间。最后,我们提出了一种量身定制的新评估理论,以评估生成图像中特定对象的质量。这些改进使增强的DF-GAN在有效地产生高质量的文本分配图像方面更有效。

推进和评估文本指导的图像inpainting
文本引导的图像编辑可以在支持创意应用程序方面具有变革性的影响。关键挑战是生成忠于输入文本提示的编辑,同时与输入图像一致。我们提出了Imagen Edor,这是一种构建的级联扩散模型,通过对文本引导的图像插入的微调[36]构建。Imagen ed- Itor的编辑忠实于文本提示,这是通过使用对象探测器在培训期间提出涂料面罩来提出的。此外,成像编辑器在输入图像中通过对原始高分辨率图像进行调节管道来详细信息。为了证明定性和定量评估,我们介绍了EditBench,这是用于文本指导图像插入的系统基准。EditBench评估在Natu-ral和生成的图像上探索对象,属性和场景的图像。Through extensive human evaluation on EditBench, we find that object-masking during training leads to across- the-board improvements in text-image alignment – such that Imagen Editor is preferred over DALL-E 2 [ 31 ] and Stable Diffusion [ 33 ] – and, as a cohort, these models are better at object-rendering than text-rendering, and handle mate- rial/color/size attributes better than count/shape attributes.

学习多维人类对文本对...
文本对图像模型的当前指标通常依赖于不足以代表人类真正偏好的统计指标。尽管最近的工作试图通过人类注释的图像来学习这些偏好,但它们将人类偏好的丰富挂毯降低到单个总分。然而,当人类评估不同方面的图像时,偏好会有所不同。因此,为了学习多维人类偏好,我们提出了多维偏好评分(MPS),这是评估文本对图像模型的第一个多维偏好评分模型。MPS引入剪辑模型上的偏好条件模块,以学习这些不同的偏好。它是根据我们的多维人类偏好(MHP)数据集进行了训练的,该数据集包括607,541图像的四个维度(即美学,语义一致性,详细信息,详细质量和整体评估)的918,315个人类偏好选择(即,美学,语义一致性,细节质量和整体评估)。这些信息是由各种最新的文本对图像模型生成的。MPS在4个维度上的3个数据集上优于现有的评分方法,从而使其成为评估和改进文本对象的有希望的指标。该模型和数据集将被公开使用,以促进未来的研究。项目页面:https://wangbohan97.github.io/mps/。
具有扩散模型的生成文本视频检索
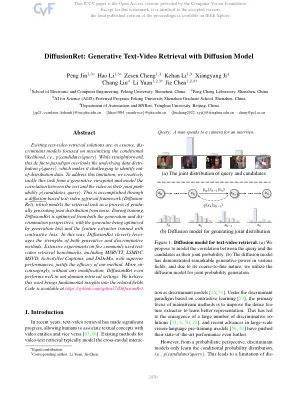
现有的文本视频检索解决方案本质上是侧重于最大程度地提高条件可能性的模型,即P(候选人|查询)。虽然很简单,但这种事实上的范式却忽略了基本的数据分布p(查询),这使得识别出分布数据的挑战。为了解决这一限制,我们从生成观点创造性地解决了此任务,并将文本和视频之间的相关性建模为其关节概率P(候选人,查询)。这是通过基于扩散的文本视频检索框架(扩散-RET)来完成的,该框架将检索任务建模为从噪声中产生关节分布的过程。在训练过程中,从发电和犯罪的角度优化了Diffusionret,其发电机通过生成损失优化,并且具有对比度损失的训练的特征提取器。以这种方式,diffusionret巧妙地杠杆化了生成和歧视方法的优势。在五个常用的文本检索基准测试中进行了广泛的实验,包括MSRVTT,LSMDC,MSVD,ActivityNet字幕和DIDEMO,并具有出色的性能,证明了我们方法的效果。更加谨慎,没有任何修改,diffusionret甚至在外域检索设置中表现良好。我们认为这项工作带来了对相关领域的基本见解。代码可从https://github.com/jpthu17/diffusionret获得。
从文本到图像综合的前景 - 背景分割的无监督共同生成
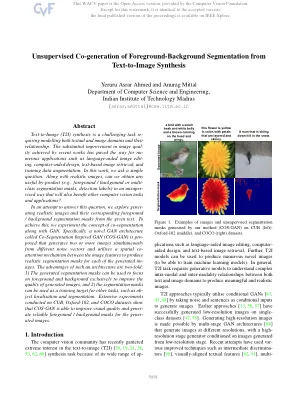
文本对图像(T2I)合成是一项艰巨的任务,该任务是对文本和图像域及其关系进行建模。最近作品实现的图像质量的实质性改进为Nuberon应用程序铺平了道路,例如语言辅助图像编辑,计算机辅助设计,基于文本的图像检索和培训数据增强。在这项工作中,我们提出了一个简单的问题:与逼真的图像一起,我们是否可以以一种不受影响的方式获得任何有用的副产品(例如前景 /背景或多类分割掩码,检测标签,检测标签),这也将使其他计算机视觉任务任务和应用受益?试图回答这个问题,我们探索了从给定文本中的逼真的图像及其相应的前景 /背景分割掩码。为了实现这一目标,我们与GAN一起实验了共进行分割的概念。具体而言,提出了一种名为“共裂”启发的GAN(COS-GAN)的新型GAN结构,该结构同时从不同的噪声矢量中同时生成两个或多个图像,并利用图像特征之间的空间关注机制来生成逼真的分段掩码,以生成生成的Im-Im-Im-Im-Im-Im-Im-Im-Im-Im-Im-Agens。这种架构的优点是两倍:1)生成的分割掩码可用于专注于前景和背景,以改善生成的图像的质量,2)分段蒙版可以用作其他任务的训练目标,例如访问本地化和分割。在CUB,Oxford-102和可可数据集上进行的广泛实验表明,Cos-Gan能够改善视觉质量,并为发电图像提供可靠的前景 /背景掩码。

从文本说明中生成人类运动
由于其广泛的应用范围,从文本描述中产生人类动作已引起了越来越多的研究兴趣。但是,只有少数作品将人类场景的互动与文本条件一起考虑,这对于视觉和物理现实主义至关重要。本文提出了在3D门场景中产生人类动作的任务,鉴于人类习惯的文本描述。由于文本,场景和运动的多种形式性质以及对空间推理的需求,此任务提出了挑战。为了应对这些挑战,我们提出了一种新方法,将复杂的概率分解为两个更可管理的子问题:(1)目标对象的语言接地和(2)以对象为中心的信息产生。对于目标对象的语言基础,我们利用大型语言模型的力量。对于运动生成,我们设计了一个以对象为中心的场景代表生成模型,以专注于目标对象,从而降低场景的复杂性并促进人类运动与对象之间关系的建模。实验证明了与基准相比,我们的方法的更好运动质量并验证了我们的设计选择。代码将在链接上可用。

MOS2中的Moiré工程光 - 摩擦相互作用... 引用了原始发表的论文(记录的版本):Jafarzadeh,S.,Nooshkam,M.,Qazanfarzadeh,Z。等(2024)。解锁潜在的O 加油否认:气候变化反动运动和瑞典极右媒体 有效的微孔子频率梳 可用性比较拟人化数字人的健康参与者和基于文本的聊天机器人,以此作为对心理健康问题的响应者:随机对照试验 朝着光网络中的可解释的强化学习:RMSA用例 和电热膜蒸馏 基于滑动触摸的探索,用于用多指双手建模未知对象形状 原子能洞察纳米片分裂水的竞争边缘 引用原始发表的论文(记录的版本):Konzock,O。,Nielsen,J。(2024)。试图评估微生物Biote的生产成本 引用了原始发表的论文(记录的版本):Bainsla,L.,Zhao,B.,Behera,N。等(2024)。 中的大面外旋转轨道扭矩 引用了原始发表的论文(记录的版本):Monsel,J。,Ciers,A.,Kini Manjeshwar,S。等(2024)。耗散和色散cav 引用了原始发表的论文(记录的版本):Kumar,R。,Srivastav,S.,Roy,U。等(2024)。镁的电噪声光谱 用快速电子梁探测光学叠液 基于机器学习的极化签名分析,用于检测和分类窃听事件和有害事件
van der waals异质结构中的Moiré超级晶格代表了高度可调的量子系统,在多体模型和设备应用中都引起了极大的兴趣。然而,在室温下,Moiré电位对光物质相互作用的影响在很大程度上仍然没有。在我们的研究中,我们证明了MOS 2 /WSE 2中的Moiré潜力促进了室温下层间激子(IX)的定位。通过执行反射对比光谱,我们证明了原子力显微镜实验支持的原子重建在修饰内部激子中的重要性。降低扭转角时,我们观察到IX寿命会更长,并且发光增强,表明诸如缺陷之类的非辐射衰减通道被Moiré电位抑制。此外,通过将Moiré超晶格与硅单模腔的整合,我们发现,使用Moiré捕获的IXS的设备显示出明显较低的阈值,与利用DelaCalized IXS的设备相比,较小的一个数量级。这些发现不仅鼓励在升高温度下在Moiré超晶格中探索多体物理学,而且还为利用光子和光电应用中的这些人工量子材料铺平了道路。

FCC 提出首创的人工智能生成的自动拨号和机器人文本规则
这些拟议的自动拨号规则是委员会为保护消费者免受人工智能生成的骗局而采取的一系列行动中的最新举措,这些骗局会误导消费者并误导公众,使消费者能够做出明智的决定。委员会提出了新的透明度标准,要求在广播和电视的政治广告中使用人工智能技术时进行披露。委员会最近通过了一项宣告性裁决,明确指出,在未经被叫方事先明确同意或豁免的情况下,针对消费者的常见自动拨号诈骗中使用的语音克隆技术是非法的。它还提议对使用深度伪造、人工智能生成的语音克隆技术和来电显示欺骗进行明显非法的自动拨号进行巨额罚款,以便在 2024 年 1 月初选之前向潜在的新罕布什尔州选民传播选举错误信息。
反事实说明的文本到图像模型
本文解决了生成法定说明(CES)的挑战,涉及识别和修改最少的必要特征,以使分类器对给定图像的预测进行预测。我们提出的方法是反事实e xplanations(Time)的tept to-i mage m odels,是一种基于蒸馏的黑盒反事实技术。与以前的方法不同,此方法仅需要图像及其预测,从而忽略了分类器的结构,参数或梯度的需求。在生成反事实之前,时间将两个不同的偏见引入了文本嵌入的形式稳定扩散:与图像的结构相关联的上下文偏差和类别偏见,与目标分类器学到的类特异性特征相关。学习了这些偏见后,我们发现了使用类预测的类令牌的最佳潜在代码,并使用目标嵌入作为条件,从而产生了符合性的解释。广泛的经验研究证明,即使在黑色盒子设置中运行时,时间也可以产生可比性的解释。
南苏丹共和国 工人接触低的人工智能 世界银行文件 采购计划(文本零件) 马拉维政府 利用成熟技术进行卫生融资... 采购计划(文本零件) 采购计划(文本零件) 采购计划(文本零件) 加纳二级城市支持计划 公共披露授权 采购计划(文本零件) 公共披露授权 太平洋的气候数据库 冈比亚基础设施项目(GIP) 数据 - 的动态,高分辨率财富测量 世界银行 柬埔寨健康公平和质量改进项目 采购计划 世界银行 菲律宾数字经济报告2020
I.在2024年6月3日至7日,针对东非地区数字整合计划(EA -RDIP,P176181)进行了项目实施支持任务(ISM)。作为该更广泛的地区项目的一部分,南苏丹共和国的混合动力(虚拟和面对面)任务于6月3日 - 7112023在南苏丹的朱巴举行。南苏丹的任务由Naomi 1-Lalewood(Tane Tean Leader,高级数字开发专家)领导,由Victor Kyalo(高级数字发展专家),Ariic David Reng(数字发展顾问),Michael Okuny(高级财务管理专家)和Ocheng Kenneth Kenneth Kaneth Kaunda Odek(高级生产专家)组成。Giacomo Assenza(网络安全专家)和Dereje Agonafir Hablewold(高级环保专家)和Jennifer Gui(南苏丹项目焦点,高级数字发展专家)实际上加入了任务。