
XiaoMi-AI文件搜索系统
World File Search System视觉


引用原始发表的论文(记录的版本):Wang,H.,Salunkhe,O.,Quadrini,W。等(2023)。计算机视觉技术的概述
线束是现代汽车车辆中电子系统的必不可少的硬件。随着汽车行业向电力和自动驾驶的转变,越来越多的汽车电子设备负责能源传输和关键安全功能,例如操纵,驾驶员援助和安全系统。此范式转移从安全角度来看,对汽车线束的需求更大,并强调了在车辆中高质量的线束组件的更重要性。但是,熟练的工人仍然手动执行电线线束组件的大多数操作,并且某些手动过程在质量控制和人体工程学方面都是有问题的。行业对提高竞争力并获得市场份额的需求也持续存在。因此,需要确保组装质量,同时提高人体工程学并优化人工成本。由机器人或人类机器人协作完成的机器人组装,是实现越来越苛刻的质量和安全性的关键推动力,因为它可以使比完全手动操作更具复制,透明和可理解的过程。然而,由于可变形物体的灵活性,在实际环境中,机器人的汇编组装在实际环境中具有挑战性,尽管在简化的工业结构下提出了许多初步的自动化解决方案。先前的研究E↵Orts提出了使用计算机视觉技术来促进线束组件的机器人自动化,从而使机器人能够更好地感知和操纵灵活的线束。本文介绍了针对机器人线束组件提出的计算机视觉技术的概述,并得出了需要进一步研究的研究差距,以促进更实用的机器人丝带线束。
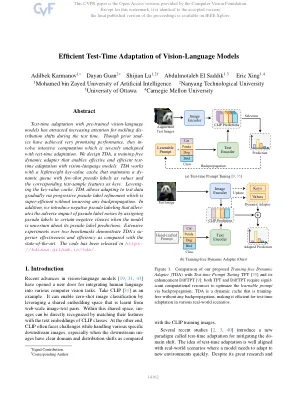
视觉模型的有效测试时间适应
通过预训练的视觉模型进行测试时间适应,引起了越来越多的关注,以应对测试时间的分离转移。尽管事先实现了非常有前途的性能,但它们会进行密集的计算,这与测试时间适应非常不规则。我们设计了TDA,这是一种无训练的动态适配器,可通过视觉模型进行有效,有效的测试时间适应。tda可与轻巧的键值缓存一起使用,该缓存维持具有很少射击伪标签的dy-namic队列作为值,而相应的测试样本特征则是键。杠杆键值缓存,TDA允许通过渐进式伪标签的细化逐渐调整数据,而逐步测试数据,而不会产生任何反向传播。此外,我们引入了负伪标记,即当模型不确定其伪标签预测时,通过将伪标签分配给某些负类时,可以减轻伪标签噪声的不利影响。在两个基准上进行的广泛实验表明,与最先进的艺术品相比,TDA的实体有效性和效率。该代码已在https://kdiaaa.github.io/tda/中发布。

使用夸张的视觉层次结构映射改善视觉识别
视觉场景是自然组织的,在层次结构中,粗糙的语义递归由几个细节组成。探索这种视觉层次结构对于认识视觉元素的复杂关系至关重要,从而导致了全面的场景理解。在本文中,我们提出了一个视觉层次结构映射器(HI-MAPPER),这是一种增强对预训练的深神经网络(DNNS)结构化理解的新方法。hi-mapper通过1)通过概率密度的封装来调查视觉场景的层次结构组织; 2)学习双曲线空间中的分层关系,并具有新颖的分层对比损失。预定义的层次树通过层次结构分解和编码过程递归地与预训练的DNN的视觉特征相互作用,从而有效地识别了视觉层次结构并增强了对整个场景的识别。广泛的实验表明,Hi-Mapper显着增强了DNN的表示能力,从而改善了各种任务的性能,包括图像分类和密集的预测任务。代码可在https://github.com/kwonjunn01/hi-mapper上找到。

气候弹性的旁遮普视觉和行动计划2024
1。水资源:通过保护和保护水资源来增强水安全。改善综合水资源管理,并通过法规和技术措施确保水质。促进气候硫化的水存储和分配基础设施,例如为井,雨水收集和社区池塘。2。生物多样性:制定和实施综合的生物多样性保护计划,以保护和保护高保护价值领域。通过基于生态系统的适应来修复降级的栖息地,并建立新的保护区以确保受威胁生态系统的生存。改善湿地的健康状况(即Ramsar遗址)充当闸门,牧场,牧场和沙漠和保护水生的多样性和栖息地条件。3。改善针对气候诱发灾难的反应:通过优先考虑灾难挽救基础设施来加强气候诱发的灾难管理能力,
通过控制视觉刺激的时间,使用脑电图进行字符输入......
研究成果概要(中文):在本研究中,我们旨在开发一种使用 P300 和稳态视觉诱发电位 (SSVEP) 的混合型输入系统,这两种技术在利用脑电图进行字符输入时被广泛使用。该系统发挥了 P300 和 SSVEP 的优势,并弥补了彼此的不足。首先,我们通过视觉刺激呈现建立了一种同时生成方法。接下来,利用呈现方法,我们确认可以通过控制候选字符的呈现时间来有效分离两种不同的脑电图。我们已经证明,我们的原创方法可以实现高速输入。然而,差异程度因对象而异。这是未来需要解决的一个挑战。
使用Pytorch的计算机视觉的初学者指南
要使用Pytorch中的数据增强,您将需要定义一组可以应用于培训数据的转换功能。您还需要确保将转换功能始终应用于输入图像和相应的注释。然后,您可以使用Torchvision.datasets.ObjectDetectionDataSet类使用批次的方式,将这些转换应用于培训数据。

nvautonet:快速准确的360DEG 3D自动驾驶视觉感知
实现强大而实时的3D感知是自动驾驶汽车的基础。虽然大多数现有的3D感知方法优先考虑检测准确性,但十个忽略了关键方面,例如计算效率,板载芯片部署友好性,对传感器安装偏差的韧性以及对各种VE-HILE类型的适应性。为了应对这些挑战,我们提出了nvautonet:一种专业的鸟类视图(BEV)感知网络 - 针对自动化车辆的明确量身定制。nvautonet将同步的相机图像作为输入,并预测3D信号(例如障碍物,自由空间和停车位)。NVAUTONET架构(图像和Bev Back-bones)的核心依赖于有效的卷积网络,该网络使用Tensorrt优化了高性能。我们的图像到BEV转换采用简单的线性层和BEV查找表,从而确保了快速推理速度。Nvautonet在广泛的专有数据集中受过培训,在NVIDIA DRIVE ORIN SOC上以每秒53帧的速度运行,始终达到升高的感知精度。值得注意的是,Nvautonet表现出对不同汽车模型产生的偏差偏差的韧性。此外,Nvautonet在适应各种车辆类型方面表现出色,这是通过廉价模型的微调程序来促进的,可以加快兼容性调整。
在不同姿势下的外源空间注意力的触觉 - 视觉联系:心理物理学和ERP的收敛证据
空间注意力的机制优先考虑与其他位置相对于其他位置的感官信息。这些机制已通过多种方法进行了深入的研究,包括心理物理学,事件型大脑电位,功能成像和单细胞记录(例如,参见Parasuraman,1998年,有关所有这些方法的发现)。这项工作导致了许多可复制的发现和一些重要的区别。的秘密关注转移(例如Mangun,Hillyard和Luck,1993; Posner,1978)。刺激驱动的外源机制已与预期驱动的内源性机制区分开来(例如Hopfinger&Mangun,1998; Jonides,1981; Posner,1978)。通常通过使用空间非预测的外围提示来研究前者,后者通过中央提示或指示可能目标位置的指令进行研究。两种形式的提示都可以在提示的位置带来性能优势,但是外源和内源性机制被认为在几种方面有所不同,包括其效果的时间过程(例如,外源性效应通常更短暂地遵循
计算机视觉 / ML工程师实习生< / div>
理想的候选人将具有强大的背景:计算机科学,机械工程,电气工程,生物医学工程或相关领域。如果有兴趣,候选人将暴露于从头开始发展初创公司的各个方面(R&D,光学系统集成和原型化)。工作将主要在我们的马里兰州哥伦比亚办事处进行。工资与经验相称(至少$ 17/hr)。我们的紧密联系的团队很高兴欢迎有才华的申请人并一起发展我们的冒险!