
XiaoMi-AI文件搜索系统
World File Search System语言
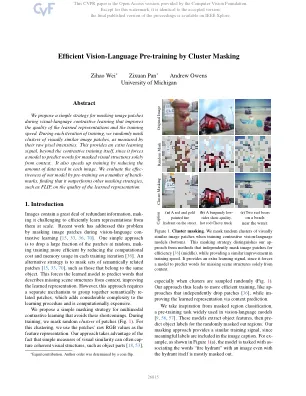
通过群集掩模的有效视力语言预训练
图像包含大量冗余信息,使其具有挑战性地在大规模上从它们中有效地了解它们。最近的工作通过在视觉语言构想学习期间掩盖图像贴片来解决这个问题[15,33,36,70]。一种简单的方法是随机放下大部分斑块,通过降低每个训练迭代中的计算成本和记忆使用量,从而更有效地培训训练[36]。替代策略是掩盖语义相关的贴片[15,33,70],例如属于同一对象的贴片。这迫使学习的模型预测从上下文中描述缺少场景结构的单词,从而改善了学识渊博的表示。但是,这种方法需要一种单独的机制来将语义重新贴定的补丁分组在一起,这为学习过程增加了相当大的复杂性,并且计算上很昂贵。我们提出了一种简单的掩盖策略,用于避免这些缺点的多模式对比学习。在训练期间,我们掩盖了斑块的随机簇(图1)。对于此聚类,我们将Patches的原始RGB值用作特征表示。我们的方法利用了一个事实,即视觉相似性的简单度量通常可以限制相干的视觉结构,例如对象部分[18,53],
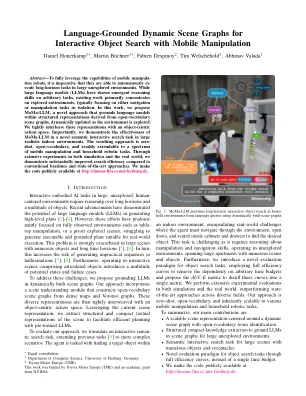
用移动操作的交互式对象搜索语言的动态场景图
摘要 - 为了充分利用移动操纵机器人的功能,必须在大型未探索的环境中自主执行的长途任务。虽然大型语言模型(LLMS)已显示出关于任意任务的紧急推理技能,但现有的工作主要集中在探索的环境上,通常集中于孤立的导航或操纵任务。在这项工作中,我们提出了MOMA-LLM,这是一种新颖的方法,该方法将语言模型基于从开放式摄影场景图中得出的结构化表示形式,随着环境的探索而动态更新。我们将这些表示与以对象为中心的动作空间紧密地交织在一起。重要的是,我们证明了MOMA-LLM在大型现实室内环境中新型语义交互式搜索任务中的有效性。最终的方法是零拍摄,开放式摄影库,并且可以易于扩展到一系列移动操作和家用机器人任务。通过模拟和现实世界中的广泛实验,与传统的基线和最新方法相比,我们证明了搜索效率的显着提高。我们在http://moma-llm.cs.uni-freiburg.de上公开提供代码。
语言技术就像人们重要的一样:居中语言技术发展中的社区
在过去的十年中,言语和语言技术已经看到了前所未有的“成功”。在既定基准中衡量的广泛应用的性能显然稳步增长。许多工具通过在消费者和商业计算中的集成而广泛采用,语音和语言技术已成为围绕“人工智能”的兴趣(和炒作)的焦点。结果,研究人员长期以来以某种形式知道的技术,例如自动语音识别(ASR),语音综合(TTS)和(大型)语言模型(LLMS)在新颖的社会环境中被解释(和开发)。上下文中的这些变化,而不是(仅)技术本身,提出了许多埃斯特,技术和法律问题,例如:

使用TF-IDF技术在阿拉伯社交媒体中进行进攻性语言检测
摘要。我们的生活现在围绕社会交流,并且由于阿拉伯文本非常复杂并且包含了许多方言,因此在阿拉伯社交媒体上很难识别出令人反感的语言。本文研究了机器学习模型的实施。使用了选择的分类器,包括决策树,支持向量机,随机森林和逻辑回归。在实验中使用了包含4505个推文的“ ARCYBC”数据集,以评估机器学习模型的性能。根据实验的结果,使用更多运行可以增强机器学习模型的性能,尤其是在精度和召回率方面。随着更多的运行,决策树(DT)和随机森林(RF)分类器显示出更好的回忆和精度,但是DT分类器显示出更好的精度。
培训大语言模型
培训大语言模型(LLM)已成为人工智能进展的核心,数据集,培训前和训练后方法在其性能和可扩展性方面扮演着互补的角色。此博士学位课程探讨了训练这些模型的关键阶段,并强调了数据对下游任务中模型性能的影响。学生将通过全面研究数据集构建,优化技术,缩放定律,培训前策略,合成数据生成以及培训后的改进(例如,进行微调和对齐方式),通过全面的研究构建LLM的理论和实践。该课程将结合理论指导与动手实验相结合。学生将洞悉:##创建高质量,多样化和有效数据集的原则和方法。##¢优化策略,用于大规模模型培训,包括计算效率。##经验缩放定律及其对模型大小和数据集大小的影响。#¢利用合成数据及其在改善概括和鲁棒性中的作用。##训练技术,例如人类反馈(RLHF)的增强学习以及与期望的结果结合。

关于单词顺序和方面的跨语言,基于语料库的定量建模
人类语言最引人注目的特征之一是它们的极端变化。更加惊人的是,在统治其形式和功能的强烈代表性和认知规律的明显变化背后的存在:语言普遍性。我们在这里讨论我们小组的一些最新工作,其中大规模,数据密集型计算建模技术用于解决有关语言规律性的基本语言问题。在单词顺序区域中,我们在此处报告工作,这些工作利用大量单语和平行语料库数据来开发名词短语(通用20)和一般结构最小化原则的内部结构的计算模型。在事件持续时间的领域,我们报告的工作利用了深厚的相似性和表面差异来开发真正的跨语言自然语言处理工具。
开发基于精细语言模型的瑞典法律判断的语义搜索工具
大型语言模型(LLMS)是非常大的深度学习模型,可根据大量数据进行重新训练。是句子的双向编码器表示,来自变形金刚(SBERT)的句子是基于变压器的DeNoising AutoCoder(TSDAE),生成查询网络(GENQ)和生成假伪标记(GPL)的改编。本论文项目旨在为瑞典法律判断开发语义搜索工具,以克服法律文件检索中传统关键字搜索的局限性。为此,使用高级培训方法(例如TSDAE,GENQ和GPL的改编),通过利用自然语言处理(NLP)(NLP)(NLP)(NLP)和精细的LLM来开发一种善于理解法律语言的语义细微差别的模型。要从未标记的数据中生成标记的数据,对其进行微调后使用了GPT3.5模型。使用生成模型的使用标记数据的生成对于该项目有效训练Sbert至关重要。已经评估了搜索工具。评估表明,搜索工具可以根据语义查询准确检索相关文档,并同样提高法律研究的效率和准确性。genq已被证明是此用例的最有效的训练方法。

可解释的AI(XAI)和大型语言模型(LLM)
➢这是一个欺骗深神经网络(DNN)的实验:在第二和第四张图像中,工程师仅保留了系统用于识别吉他和企鹅的系统的元素,并更改了其余的所有内容,以使系统仍然像吉他和企鹅一样“看到”他们。➢Goodfellow等人的作品。(2014)从普遍的扰动开始打开了进一步发展的大门(Moosavi-Dezfooli等人。2017)最近的一个像素攻击,该攻击显示了如何通过在输入图像中更改一个像素来欺骗神经网络。笔记本在这里一张像素攻击原始纸
语言模型的视觉检查
学习建模字符串之间的关系的学习是什么教授大型语言模型(LLMS)关于Vi-Sual世界的?我们系统地评估了LLMS生成和识别出增加复杂性的各种视觉概念的能力,然后演示如何使用文本模型来培训预先的视觉表示学习系统。由于语言模型缺乏将视觉信息作为像素消耗或输出视觉信息的能力,因此我们使用代码来表示研究中的图像。尽管LLM生成的图像看起来不像自然图像,但图像产生的结果以及模型校正这些固定图像的能力表明,字符串的精确建模可以教授有关Vi-Sual World的许多方面的语言模型。此外,使用文本模型生成的图像进行了自我监督的视觉表示学习的实验,突出了能够训练能够使用LLMS对自然IM的语义评估进行训练视觉模型的潜力。