
XiaoMi-AI文件搜索系统
World File Search System扩散

基于扩散模型的机器人视觉运动策略学习
背景和动机视觉策略学习涉及将视觉观察映射到运动动作上,使机器人能够有效地与环境互动。传统方法通常在多模式作用分布的复杂性以及对高精度和时间一致性的需求中挣扎。最近引入的扩散策略通过采用有条件的降级扩散过程来生成机器人动作,从而提供了有希望的解决方案。这些模型在产生复杂的行为方面表现出了卓越的性能,使其成为机器人操纵和组装任务的理想候选人。此外,整合自然语言处理(NLP)允许多功能任务调理,使机器人能够根据人类指令执行各种任务。

稳定扩散启用水下深度估计
单眼深度估计在近年来,由于深度学习的进步,近年来在陆地图像上取得了重大进展。,但主要是由于数据稀缺性而导致的水下场景不足。鉴于水中的光衰减和背面的固有挑战,获得清晰的水下图像或精确的深度非常困难且昂贵。为了减轻此问题,基于学习的方法通常依赖于综合数据或转向自欺欺人或无监督的举止。尽管如此,它们的性能通常受到域间隙和宽松的约束而阻碍。在本文中,我们提出了一种新的管道,用于使用准确陆地深度生成感性的水下图像。这种方法有助于对水下深度估计的模型进行超级培训,从而有效地降低了限制和水下环境之间的性能差异。与以前的合成数据集相反,这些数据集仅将样式转移应用于没有场景内容的情况下的Terres试验图像,我们的方法通过通过创新的STA-

C9orf72 ALS/FTD二肽重复蛋白水平通过抑制PKA或增强蛋白质降解的小分子降低对扩散:全面的多模式对象级图像编辑器
基于扩散的生成模型在合成和操纵图像具有巨大的图像方面表现出了令人鼓舞的结果,其中文本到图像模型及其后续作品在学术界和行业中都具有很大的影响。编辑真实图像时,用户通常希望对不同元素具有直观而精确的控制(即对象)组成图像,并不断地操纵它们。我们可以根据图像中的单个观察的控制级别对现有的图像编辑方法进行分类。一条工作涉及使用文本提示来操纵图像[2,15,24,27]。由于很难与文本同时描述多个对象的形状和外观,因此在对象级别上对细粒度控制的能力有限。同时,迅速的工程使操纵任务乏味且耗时。另一项工作线使用低级调理信号,例如Hu等人。[18],Patashnik等。[34],Zeng等。[58],草图[50],图像[5,47,54]编辑图像。但是,其中大多数作品要么属于迅速的工程陷阱,要么无法独立操纵多个对象。与以前的作品不同,我们的目标是独立控制组成图像的多个对象的正确条件,即对象级编辑。我们表明,我们可以在对象级编辑框架下制定各种图像编辑任务,从而实现全面的编辑功能。
HHMR:通过增强图扩散模型的多模式可控性
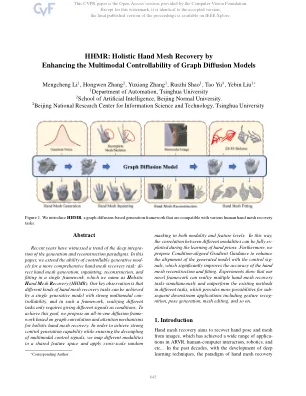
近年来见证了一代和重建范式深入融合的趋势。在本文中,我们扩展了可控制的生成模块的能力,以实现更全面的手网恢复任务:在单个框架中,手工网格的生成,内部网状,重建,重建和拟合,我们将其命名为H olistic H和MESH R Ecovery(HHMR)。我们的主要观察结果是,具有强大多模式可偿还性的单个生成模型可以实现不同类型的手网恢复任务,并且在这样的框架中,实现不同的任务只需要给出不同的信号作为条件。为了实现这一目标,我们提出了基于图形卷积和整体手工网状恢复的注意力卷积和注意力机制的多合一扩散框架。为了实现强大的控制能力,同时确保多模式控制信号的解耦,我们将不同的模态映射到共享特征空间并应用跨尺度随机
在扩散模型中使用令牌优化的开放式摄取注意图
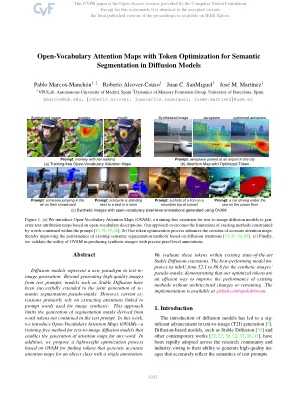
扩散模型代表文本到图像生成中的新范式。除了从文本提示中生成高质量的图像之外,诸如稳定扩散之类的模型已成功扩展到了共同生成的分段伪遮罩。但是,当前的敏感主要依赖于提取与用于图像合成的及时单词相关的关注。这种方法限制了从文本提示中未包含的单词代币中得出的分割掩码的产生。在这项工作中,我们介绍了开放式摄影注意力图(OVAM) - 用于文本到图像扩散模型的无训练方法,可为任何单词生成注意力图。此外,我们提出了一个基于OVAM的轻巧优化过程,用于查找具有单个注释的对象类的准确注意图。
扩散-ES:无梯度计划,扩散自主和指导引导
扩散模型在建模复合物和多模态轨迹分布方面表现出色,以进行决策和控制。最近提出了奖励级别指导的denoising,以生成轨迹,从而最大程度地提高了可差异的奖励函数,又是扩散模型捕获的数据分布下的可能性。奖励级别指导的denoisising需要适合清洁和噪声样本的可区分奖励功能,从而限制了其作为一般轨迹优化器的应用。在本文中,我们提出了扩散-ES,一种将无梯度优化与轨迹deNoising结合起来的方法,以优化黑框非差异性目标,同时留在数据管理中。扩散-ES样品在进化过程中的轨迹 - 从扩散模型中搜索,并使用黑框奖励函数得分。它使用截断的扩散过程突变高得分轨迹,该过程应用了少量的no弱和降解步骤,从而可以更有效地探索解决方案空间。我们表明,扩散-ES在Nuplan上实现了最先进的表现,Nuplan是一个已建立的闭环计划基准,用于自动驾驶。扩散-ES的表现优于现有的基于抽样的计划者,反应性确定性或基于扩散的策略以及奖励梯度指导。此外,我们表明,与先前的指导方法不同,我们的方法可以优化由少数弹药LLM提示产生的非差异性语言形状奖励功能。这使我们能够解决最困难的NUPLAN场景,这些方案超出了现有的传统优化方法和驾驶策略的能力。在以遵循指示的人类老师的指导下,我们的方法可以产生新颖的,高度复杂的行为,例如训练数据中不存在的积极的车道编织。1

训练扩散模型通过增强学习
扩散模型在图像生成中表现出了前所未有的ca。然而,它们从原始训练集中纳入并扩大了数据偏差(例如性别,年龄),从而限制了产生的IMEG的多样性。在本文中,我们在基于图像集的重新函数的指导下,使用增强学习(RL)提出了一种面向多样性的细调方法(RL)。具体而言,所提出的奖励函数(表示为多样性奖励),利用一组生成的信息来评估当前生成分配W.R.T.的覆盖范围。参考分布,由一组无偏见的图像表示。建立在分布差异估计的概率方法的基础上,差异奖励可以有效地用一小部分图像来测量相对分布差距。我们进一步将扩散过程作为多步决策问题(MDP),并通过最大化多样性奖励来应用策略梯度方法来微调扩散模型。在放样后选择任务上验证了奖励,其中根据多样性奖励值选择了最多样化的图像的子集。我们还展示了我们的RL微调框架的有效性,可以通过不同类型的扩散模型(包括班级条件模型和文本条件模型,例如stablediffusion)增强图像生成的多样性。

真实srgd:使用无分类器引导扩散
摘要。现实世界图像超分辨率(RISR)旨在从退化的低分辨率(LR)输入中重新结构高分辨率(HR)图像,以应对诸如模糊,噪声和压缩工件之类的挑战。与传统的超分辨率(SR)不同,该方法通过合成的下采样来典型地生成LR图像,而RISR则是现实世界中降级的复杂性。为了有效地应对RISR的复杂挑战,我们适应了无分类器指导(CFG),这是一种最初用于多级图像生成的技术。我们提出的方法,真实的SRGD(带有无分类器引导扩散的现实世界图像超分辨率),将RISR挑战分解为三个不同的子任务:盲图恢复(BIR),常规SR和RISR本身。然后,我们训练针对这些子任务量身定制的类别条件SR扩散模型,并使用CFG来增强现实世界中的超分辨率效果。我们的经验结果表明,实际SRGD超过了定量指标和定性评估中的现有最新方法,如用户研究所证明的那样。此外,我们的方法在
扩散光学中蒙特卡洛模拟的缩放关系的应用限制。第1部分:理论
摘要:Monte Carlo(MC)是研究散射媒体中光子迁移的强大工具,但很耗时以解决反问题。为了加快MC模拟的速度,可以将缩放关系应用于现有的初始MC模拟,以生成具有不同光学属性的新数据集。我们命名了这种方法基于轨迹,因为它使用了初始MC模拟的检测到的光子轨迹的知识,这与基于较慢的光子方法相反,在这种方法中,新型MC模拟具有新的光学特性。我们研究了缩放关系的收敛性和适用性限制,这两者都与所考虑的轨迹样本也代表了新的光学特性有关。为了吸收吸收,缩放关系包含平滑收敛的兰伯特啤酒因子,而对于散射,它是两个快速分化因子的乘积,其比例很容易达到十个数量级。我们通过研究给定长度的轨迹中的散射事件数量来研究这种不稳定。我们根据记录的轨迹中的最小最大散射事件进行了散射缩放关系的收敛测试。我们还研究了MC模拟对光学性质的依赖性,这在反问题中最关键,发现散射衍生物归因于小泊松分布的散射事件分布的小偏差。本文也可以用作教程,有助于理解比例关系的物理学与其局限性的原因,并制定了应对它们的新策略。