
XiaoMi-AI文件搜索系统
World File Search SystemAugmen

增强现实如何塑造医疗保健的未来
现代医疗机构正在经历快速而根本的变化。医生,技术人员和其他医生的需求比以往任何时候都更高,并难以维持相同的护理水平 - 同时同时实施了新的临床和数据存储技术。医疗保健设施越来越复杂,那是在Covid-19迫使他们实施社会疏远和占用限制之前。

通过风格增强和双重规范化实现通用的跨模态医学图像分割
对于医学图像分割,想象一下如果一个模型仅使用源域中的 MRI 图像进行训练,那么它在目标域中直接分割 CT 图像的性能如何?这种设置,即具有临床潜力的通用跨模态分割,比其他相关设置(例如域自适应)更具挑战性。为了实现这一目标,我们在本文中提出了一种新颖的双重规范化模型,该模型在通用分割过程中利用增强的源相似和源不相似图像。具体而言,给定一个源域,旨在模拟看不见的目标域中可能的外观变化,我们首先利用非线性变换来增强源相似和源不相似图像。然后,为了充分利用这两种类型的增强,我们提出的基于双重规范化的模型采用共享主干但独立的批量规范化层进行单独规范化。随后,我们提出了一种基于风格的选择方案,在测试阶段自动选择合适的路径。在三个公开数据集(即 BraTS、跨模态心脏和腹部多器官数据集)上进行的大量实验表明,我们的方法优于其他最先进的领域泛化方法。代码可在 https://github.com/zzzqzhou/Dual-Normalization 获得。

触觉增强的辐射场 - CVF Open Access
我们提出了一个场景表示形式,我们称之为触觉的辐射场(TARF),它将视觉和触摸带入共享的3D空间。此表示形式可用于估计场景中给定3D位置的视觉和触觉信号。我们从一系列照片和稀疏采样触摸探针中捕获了场景的tarf。我们的方法利用了两个见解:(i)基于常见的触摸传感器建立在普通摄像机上,因此可以使用多视图几何形状中的方法对图像进行注册,并且(ii)在视觉和结构上相似的场景区域具有相同的触觉效果。我们使用这些见解将触摸信号注册到捕获的视觉场景中,并训练有条件的扩散模型,该模型带有从神经辐射场呈现的RGB-D图像,生成其相应的触觉信号。为了评估我们的方法,我们收集了一个TARF的数据集。此数据集比预先持有的现实世界数据集包含更多的触摸样本,并且为每个捕获的触摸信号提供了空间对齐的视觉信号。我们揭示了跨模式生成模型的准确性以及在下游任务上捕获的视觉效果数据的实用性。项目页面:https:// dou- yiming.github.io/tarf。
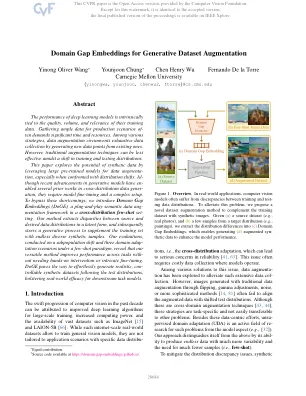
生成数据集增强的域间隙嵌入
本文通过利用大型预训练模型来探讨合成数据的潜力,尤其是在面对分布变化时。al-尽管生成模型的最新进展已经阐明了跨分布数据发生的几项先前的作品,但它们需要模型调整和复杂的设置。为了绕过这些缺点,我们介绍了主要的g a a a a a a a a embeddings(doge),这是一个跨分布的插件语义数据augpection框架,几乎没有射击设置。我们的方法以潜在形式提取源和所需数据分布之间的差异,然后引导生成过程,以补充无数多种合成样本的训练集。我们的评估是在几个射击范式下进行亚种群偏移和三个领域适应方案进行的,表明我们的多功能方法改善了各个任务的性能,需要进行动手干预或复杂的调整。Doge铺平了毫不费力地生成遵循测试分布的现实,可转让的合成数据集的道路,从而加强了下游任务模型的现实世界效率。

一个基于增强现实的游戏来教授编程
摘要:近年来,技术彻底改变了生活的所有领域。由于编程是软件技术的核心,因此,对程序员的需求也必须日复一日地增加。随着增强现实(AR)和计算机视觉(CV)领域的进步,我们现在可以为教育领域的独特体验开发应用程序。本研究旨在为小学生开发一种学习编程技能的游戏。为学生提供了作为我们游戏标记的卡片。每个标记在AR中都具有独特的编程块,这会导致我们的游戏角色执行一定的动作。学生需要以正确的方式放置这些块才能完成给定的任务。因此,它使学生能够以吸引他们的方式学习一些基本的编程技能。
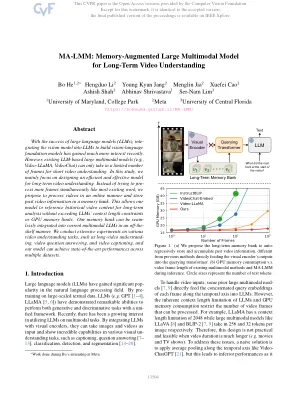
ma-lmm:长期视频理解的内存大型多模型
随着大型语言模型(LLM)的成功,将视觉模型融入了LLM,以建立视觉语言基础模型最近引起了人们的兴趣。但是,现有的基于LLM的大型多模式模型(例如,视频播放,视频聊天)只能摄入有限数量的框架以进行简短的视频理解。在这项研究中,我们主要专注于设计一个有效有效的模型,以进行长期视频理解。我们建议以在线方式处理视频并将过去的视频信息存储在存储库中,而不是像大多数现有作品一样尝试同时进行更多框架。这使我们的模型可以参考历史视频内容以进行长期分析,而不会超过LLM的上下文长度约束或GPU内存限制。我们的内存库可以以现成的方式被缝制到当前的多模式LLMS中。我们在各种视频理解任务上进行了广泛的实验,例如长期介绍,视频问题答案和视频字幕,我们的模型可以在多个数据集中实现最新的性能。
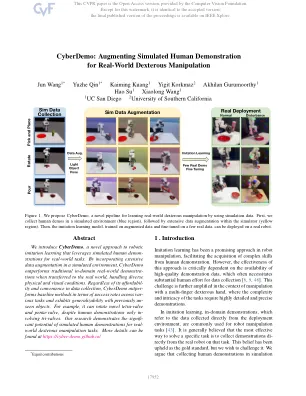
Cyberdemo:增强现实世界灵巧操纵的模拟人类示范
我们介绍了Cyberdemo,这是一种用于机器人模仿学习的新方法,该方法利用了模拟人类的策略来实现现实世界的任务。通过在模拟环境中纳入广泛的数据增强,CyberDemo在转移到现实世界中的传统现实世界中的表现优于传统的现实世界中的演示,从而处理了多样化的物理和视觉条件。无论其负担能力和在数据收集中的便利性如何,Cyberdemo Opper-pers-pers-pers-pers of-lip-term-term of基线方法在跨不同任务的成功率方面,并具有以前未见的对象的普遍性。例如,尽管只有人类的示范插入三瓣,但它仍可以旋转新型的四阀和五角谷。我们的研究证明了模拟人类示范对现实世界灵活操纵任务的重要潜力。更多详细信息可以在https://cyber-demo.github.io/
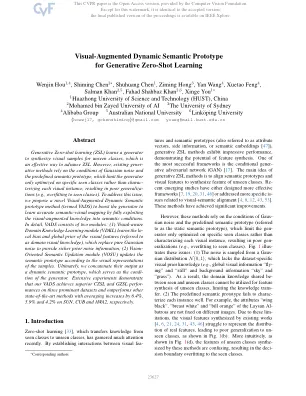
视觉增强的动态语义原型,用于生成零拍学习
生成的零拍学习(ZSL)学习了一个生成器来合成看不见类的视觉样本,这是推进ZSL的有效方法。然而,现有的发电方法依赖于高斯噪声和预定义的语义原型的条件,这限制了仅在特定的看到类中优化的发电机,而不是对每个视觉实例进行特征,从而导致概括不良(例如,过度适用于可见的类)。为了解决这个问题,我们提出了一种新颖的视觉启动动态语义原型方法(称为VADS),以增强发电机来学习准确的语义 - 视觉映射,以充分利用视觉效果的知识为语义条件。详细说明,VADS由两个模块组成:(1)视觉吸引域知识学习模块(VDKL)了解视觉特征的偏见和全局先验(称为域的视觉知识),这些偏见取代了纯净的高斯噪声,以提供更丰富的先验噪声信息; (2)以视觉为导向的语义更新模块(VOSU)根据样本的视觉表示更新语义原型。最终,我们将它们的输出作为动态语义原型串联,作为发电机的条件。广泛的实验表明,我们的VAD在三个突出的数据集上实现了上升的CZSL和GZSL prounperces,并且在Sun,Cub和Awa2上分别胜过其他最先进的方法,其平均分别增加了6.4%,5.9%,5.9%和4.2%。

增强型基础设施:数字化气候? - Ardian
因此,我们的增强基础设施框架应推动这种方法的新动态,创新应被视为改善气候影响的推动因素。我们还需要意识到数字本身对环境的影响,并找到在其设计和使用中减轻影响的方法。

包容性增强和虚拟现实:研究议程
摘要增强现实和虚拟现实体验给残疾人带来了重大障碍,使他们难以充分参与沉浸式平台。虽然研究人员已经开始探索解决这些无障碍问题的潜在解决方案,但我们目前缺乏对需要进一步研究的研究领域的全面了解,以支持包容性 AR/VR 系统的开发。为了解决当前的知识空白,我们与相关利益相关者(即学术研究人员、行业专家、有残疾生活经历的人、辅助技术人员以及残疾人组织、慈善机构和特殊需要教育机构的代表)领导了一系列多学科沙箱,共同探索研究挑战、机遇和解决方案。根据参与者分享的见解,我们提出了一个研究议程,确定了与特定形式的残疾(即涵盖身体、视觉、认知和听力障碍的范围内)相关的需要进一步研究的关键领域,包括与开发更易于访问的沉浸式平台相关的更广泛的考虑。