
XiaoMi-AI文件搜索系统
World File Search Systemiterative

USask 的临时人工智能 (AI) 原则和指南 i USask 的 AI 原则旨在确保以支持 USask 的使命、愿景、价值观和战略目标的方式合乎道德、有效和负责任地使用 AI,并维护所有利益相关者的信任和信心。这些原则和指南旨在指导我们提供、支持和使用 AI 工具开展研究、教学、管理和支持服务。重要的是,当 AI 成为研究或教学的主题时(例如,关于 AI 的研究或教学),其中一些原则和指南可能不适用。这些活动被视为通过其他大学政策和实践以及学术自由的权利和义务进行管理。USask 坚持包括合议和包容性 ii 在内的核心价值观。重要的是,我们的流程包括研究人工智能 (AI) 使用教育特定原则的有影响力的例子,包括《北京人工智能与教育共识》 iii 和世界经济论坛的《教育人工智能七项原则》 iv 。这些框架要么以联合国教科文组织的《人本主义人工智能十大核心原则》为基础,要么以此为参考。以这些国际范例为参考点,萨斯喀彻温大学人工智能原则是通过一个强大而反复的过程制定的,该过程涉及来自我们校园各地的社区成员。萨斯喀彻温大学的人工智能原则和实践对于萨斯喀彻温大学的人工智能使用具有包容性、响应性和有效性。我们将继续采取持续响应的方式,以不断发展的人工智能原则和指导方针——考虑大学社区的反馈和人工智能技术的进步——以确保人工智能的使用保持有效、相关,并与我们大学不断变化的需求和价值观保持一致。随着萨斯喀彻温大学社区成员得到支持,将他们的人工智能实践与这些原则和指导方针保持一致,将培养一种负责任和道德的人工智能文化。萨斯喀彻温大学将接受我们作为人工智能使用方面的批评者和社会良知的角色,将公开其人工智能使用的原则和指导方针,并随着原则和指导方针的不断发展及时提供更新。重要的是,这些原则代表了我们在快速变化的环境中使用人工智能的愿望。道德和负责任的使用 1. 负责任。人类有意的选择和行动引领着我们对人工智能的使用,而人工智能
USask 的临时人工智能 (AI) 原则和指南 i USask 的 AI 原则旨在确保以支持 USask 的使命、愿景、价值观和战略目标的方式合乎道德、有效和负责任地使用 AI,并维护所有利益相关者的信任和信心。这些原则和指南旨在指导我们提供、支持和使用 AI 工具开展研究、教学、管理和支持服务。重要的是,当 AI 成为研究或教学的主题时(例如,关于 AI 的研究或教学),其中一些原则和指南可能不适用。这些活动被视为通过其他大学政策和实践以及学术自由的权利和义务进行管理。USask 坚持包括合议和包容性 ii 在内的核心价值观。重要的是,我们的流程包括研究人工智能 (AI) 使用教育特定原则的有影响力的例子,包括《北京人工智能与教育共识》 iii 和世界经济论坛的《教育人工智能七项原则》 iv 。这些框架要么以联合国教科文组织的《人本主义人工智能十大核心原则》为基础,要么以此为参考。以这些国际范例为参考点,萨斯喀彻温大学人工智能原则是通过一个强大而反复的过程制定的,该过程涉及来自我们校园各地的社区成员。萨斯喀彻温大学的人工智能原则和实践对于萨斯喀彻温大学的人工智能使用具有包容性、响应性和有效性。我们将继续采取持续响应的方式,以不断发展的人工智能原则和指导方针——考虑大学社区的反馈和人工智能技术的进步——以确保人工智能的使用保持有效、相关,并与我们大学不断变化的需求和价值观保持一致。随着萨斯喀彻温大学社区成员得到支持,将他们的人工智能实践与这些原则和指导方针保持一致,将培养一种负责任和道德的人工智能文化。萨斯喀彻温大学将接受我们作为人工智能使用方面的批评者和社会良知的角色,将公开其人工智能使用的原则和指导方针,并随着原则和指导方针的不断发展及时提供更新。重要的是,这些原则代表了我们在快速变化的环境中使用人工智能的愿望。道德和负责任的使用 1. 负责任。人类有意的选择和行动引领着我们对人工智能的使用,而人工智能
迭代横向CNOT解码器
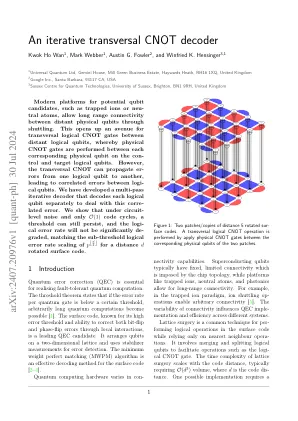
现代候选候选物的现代平台,例如被困的离子或神经原子,可以通过穿梭量允许遥远的物理速度之间的长距离连通性。这为远处逻辑量子位之间的横向逻辑cnot门开辟了道路,从而在该控制和目标逻辑Qubits上的每个相应的物理量子之间执行物理cnot门。但是,横向cnot可以从一个逻辑量子频率传播到另一个逻辑量子,从而导致logimal Qubits之间的误差相关。我们已经开发了一个多通迭代解码器,该解码器分别解码每个逻辑量子量子,以处理这种符合的误差。我们表明,在电路级别的噪声和O(1)代码周期下,阈值仍然可以持续存在,并且逻辑错误率将不会显着分级,与p⌊d

迭代横向CNOT解码器
现代候选候选物的现代平台,例如被困的离子或神经原子,可以通过穿梭量允许遥远的物理速度之间的长距离连通性。这为远处逻辑量子位之间的横向逻辑cnot门开辟了道路,从而在该控制和目标逻辑Qubits上的每个相应的物理量子之间执行物理cnot门。但是,横向cnot可以从一个逻辑量子频率传播到另一个逻辑量子,从而导致logimal Qubits之间的误差相关。我们已经开发了一个多通迭代解码器,该解码器分别解码每个逻辑量子量子,以处理这种符合的误差。我们表明,在电路级别的噪声和O(1)代码周期下,阈值仍然可以持续存在,并且逻辑错误率将不会显着分级,与p⌊d

自主总线轨迹跟踪系统的强大无模型自适应迭代学习控制
摘要在这项工作中提出了一种强大的无模型自适应迭代学习控制(R-MFAILC)算法,以解决横向控制自动驾驶总线的问题。首先,根据自主总线的周期重复工作特性,利用了迭代域中使用的一种新型的动态线性化方法,并给出了具有伪梯度(PG)的时变数据模型。然后,R-MFAILC控制器的设计具有建议的自适应衰减因子。所提出的算法的优势在于R-MFAILC控制器,该控制器仅利用了调节实体的输入和输出数据。此外,R-MFAILC控制器具有很强的鲁棒性,并且可以处理系统的非线性测量干扰。在基于卡车SIM模拟平台的模拟中,验证了所提出的算法的有效性。使用严格的数学分析来证明所提出算法的稳定性和收敛性。

Aurigene.AI 是一种端到端的小分子药物发现解决方案,将 AI 和 ML 功能与 Aurigene 在合成和体内外测试分子方面的核心专业知识相结合。 该平台由一个精心策划的数据库组成,可用作训练数据。 模块化平台允许用户从一组生成、预测和计算算法中灵活地选择合适的 AI 模型。 它利用迭代 ML 过程进行合理有效的化学设计,并根据合成的可处理性和 ADME(吸收、分布、代谢、排泄)和效力等特性进行优先排序。
Aurigene Pharmaceutical Services 是一家全球合同研究、开发和制造组织 (CRDMO)。我们以加速创新的传统为基础,并在小分子和大分子药物发现、开发和制造方面拥有丰富的经验,我们的使命是坚持不懈地为客户的成功而努力,并通过整体方法建立长期关系,以加速分子从实验室到市场的进程。我们为发现化学、生物治疗药物发现、发现生物学、临床 I-III 期计划、监管提交批次和商业制造的开发和制造服务提供集成和独立服务。Aurigene 的独特之处在于其集成的 API 和配方服务,涵盖从关键起始材料、高级中间体和 API 到成品(如口服固体、无菌产品、鼻腔溶液等)。英国、墨西哥、美国和印度的 GMP 商业制造设施补充了我们在印度的开发和制药 API 制造服务。

teemi:一种迭代设计建筑测试循环的开源识字编程方法
1 Novo Nordisk生物可持续性基金会,丹麦技术大学,公里。Lyngby,丹麦2号生物技术与生物医学系,丹麦技术大学,公里。Lyngby,丹麦,丹麦技术大学应用数学与计算机科学系3。Lyngby,丹麦,4联合生物能源研究所,加利福尼亚州埃默里维尔,美国,美国5个生物系统与工程部,劳伦斯·伯克利国家实验室,伯克利,美国加利福尼亚州伯克利,美国6化学和生物分子工程系6深圳高级技术学院合成生物学研究所,中国深圳

使用迭代学习控制加速基于 P300 的神经反馈训练以增强注意力:一项随机对照试验
摘要 目的:通过脑机接口进行的神经反馈 (NFB) 训练已被证明可有效治疗神经系统缺陷和疾病,并提高健康个体的认知能力。之前的研究显示,使用 P300 拼写器的基于事件相关电位 (ERP) 的 NFB 训练可以通过逐步增加拼写任务的难度来提高健康成年人的注意力。本研究旨在评估任务难度适应对健康成人基于 ERP 的注意力训练的影响。为此,我们引入了一种采用迭代学习控制 (ILC) 的新型适应方法,并将其与现有方法和具有随机任务难度变化的对照组进行比较。方法:该研究涉及 45 名健康参与者,为一项单盲、三组随机对照试验。每组接受一次 NFB 训练,使用不同的方法来调整 P300 拼写任务中的任务难度:两组采用个性化难度调整(我们提出的 ILC 和现有方法),一组采用随机难度。我们使用视觉空间注意任务在训练课程之前和之后评估认知表现,并通过问卷收集参与者的反馈。主要结果。所有组在训练后的空间注意任务中都表现出显著的表现提高,平均增加了 12.63%。值得注意的是,使用所提出的迭代学习控制器的组在训练期间实现了 P300 幅度增加 22%,训练后 alpha 功率降低 17%,同时与其他组相比显著加快了训练过程。意义。我们的结果表明,使用 P300 拼写器的基于 ERP 的 NFB 训练可有效增强健康成年人的注意力,一次课程后即可观察到显著的改善。使用 ILC 的个性化任务难度调整不仅可以加速训练,还可以增强训练期间的 ERP。加速 NFB 训练,同时保持其有效性,对于最终用户和临床医生的接受度至关重要。

通过双向深度神经网络和迭代算法设计的超表面用于生成定量场分布
超表面是超材料的二维对应物,它已展示出前所未有的能力,可以在单个平面设备中操纵电磁波的波前。尽管该领域取得了各种进展,但超表面所实现的独特功能是以结构复杂性为代价的,导致传统超表面设计的参数扫描非常耗时。尽管人工神经网络提供了一个灵活的平台来显著改善设计过程,但当前的超表面设计仅限于生成定性场分布。在本研究中,我们证明,通过结合串联神经网络和迭代算法,可以用定量场分布克服超表面设计的先前限制。作为原理验证示例,通过设计的网络架构预测的超透镜具有多个焦点,具有相同/正交的偏振状态,以及精确的强度比(定量场分布),并通过数值计算和实验证明。独特而强大的超表面设计方法将加速开发可应用于成像、检测和传感的高精度功能设备。