
XiaoMi-AI文件搜索系统
World File Search Systemlabl

可扩展的高斯流程变量自动编码器
稀疏的高斯过程。在稀疏的高斯过程近似过程中已经进行了一系列工作,可以追溯到Snelson和Ghahramani(2006),Qui〜nonero-Candela和Rasmussen(2005)等。这些稀疏方法中的大多数都依赖于一个汇总的一组,称为诱导点,主要是选择这些点的确切方式。在Titsias(2009)中首先考虑了诱导点的变异学习,并被证明会导致显着的性能提高。而不是在非变化稀疏模型中使用近似边缘的GP可能性,而是在确切的GP边际可能性上的下限被得出并用作训练目标。与我们工作相关的另一种方法是Hensman等人的随机变异方法。(2013),作者提出了一个稀疏模型,除了降低GP复杂性外,还可以在小型批次中训练,从而使(极其)大型数据集使用GP模型。

耶鲁大学/GRA ACC模型:可用于自然的新独特工具;解释器
科学家用来解释生态系统中捕获和存储的碳量的数学工具很少考虑动物的影响。这源于这样的假设:由于动物比生态系统中的植物和微生物要稀有得多,因此它们的潜在影响应该是最小的。然而,现场研究已经开始表明,这种假设可能不是准确的,如2023年3月下旬的《自然气候变化》杂志发表的《自然气候变化可以扩大自然气候解决方案》中所示。这导致了一个新的询问领域,称为碳循环(ACC)。

CHIME:CMOS 体内微电极,用于大规模可扩展的神经元记录
哺乳动物的大脑由数千万到数千亿个神经元组成,这些神经元以毫秒级的时间尺度运行,而目前的记录技术只能捕捉到其中的一小部分。能够以高时空分辨率对神经活动进行采样的记录技术一直难以扩展。研究最深入的哺乳动物神经元网络(例如大脑皮层)呈现出分层结构,其中最佳记录技术可在大面积上进行密集采样。然而,对特定应用设计的需求以及大脑的三维结构与二维微加工技术之间的不匹配严重限制了神经生理学研究和神经假体。在这里,我们讨论了一种可扩展神经元记录的新策略,即将玻璃包覆微线束与来自高密度 CMOS 体外 MEA 系统或高速红外摄像机的大规模放大器阵列相结合。由于玻璃包覆微线中芯金属的高导电性,允许使用超薄金属芯(低至 < 1 µ m)和可忽略不计的杂散电容,因此实现了高信噪比(< 25 µ V RMS 本底噪声,SNR 高达 25)。尖端的多步电化学改性可实现超低接入阻抗和最小几何面积,这与芯直径基本无关。我们表明,可以减小微线尺寸,以几乎消除插入时对血脑屏障的损伤,并且我们证明微线阵列可以稳定地记录单个单元活动。将微线束和 CMOS 阵列相结合可以实现高度可扩展的神经元记录方法,将电神经元记录的进展与硅微加工的快速进展联系起来。系统的模块化设计允许自定义记录位置的排列。我们采用微创、高度绝缘和功能化的微线束将二维 CMOS 架构扩展到第三维,这种方法可以转化为其他 CMOS 阵列,例如电刺激设备。

• DTEK Oil & Gas Production、DTEK Energy BV 和 DTEK Renewables BV 的 2024 年上半年财务报表现已发布 • 欧盟更新的财务
• DTEK 石油和天然气生产、DTEK Energy BV 和 DTEK Renewables BV 的 H1-2024 财务报表现已发布 • 欧盟对乌克兰及其能源部门重新提供财政支持 • DTEK 寻求在联合国加强对乌克兰能源部门的国际支持 • IEA 报告:乌克兰的能源安全和即将到来的冬天 • DTEK 在基辅的安装揭示了俄罗斯袭击对乌克兰能源设备的巨大影响 • 能源市场更新 DTEK 石油和天然气生产、DTEK Energy BV 和 DTEK Renewables BV 的 H1-2024 财务报表现已发布 DTEK 石油和天然气生产、DTEK Energy BV 和 DTEK Renewables BV 的 H1-2024 财务报表已经发布,请找到相应的链接访问它们:


可控文本到图像合成,适用于多模态 MR 图像
近年来,生成模型取得了重大进展,尤其是在文本到图像合成领域。尽管取得了这些进展,但医学领域尚未充分利用大规模基础模型的功能来生成合成数据。本文介绍了一种文本条件磁共振 (MR) 成像生成框架,解决了与多模态考虑相关的复杂性。该框架包括一个预先训练的大型语言模型、一个基于扩散的提示条件图像生成架构和一个用于输入结构二进制掩码的附加去噪网络。实验结果表明,所提出的框架能够生成与医学语言文本提示一致的逼真、高分辨率和高保真的多模态 MR 图像。此外,该研究根据文本条件语句解释了生成结果的交叉注意力图。这项研究的贡献为未来文本条件医学图像生成的研究奠定了坚实的基础,并对加速医学成像研究的进步具有重要意义。
对建筑行业的市售自主绘画机器人的审查
在建筑业中的绘画是一种危险活动,为工人带来了许多建筑风险,例如从高处掉下来,笨拙的位置肌肉骨骼疾病以及暴露于有毒物质,尤其是在狭窄的空间中。大多数建筑项目都包括绘画活动和绘画活动的重复性质,导致了几个绘画机器人的提议,目前很少有商业上可用。这些机器人在目前的状态下有一定的局限性,影响了机器人的最终生产力及其在建筑工作地点的实施。本文解决的问题是缺乏对自主绘画机器人(APR)必要要素的研究,以有效,安全地执行施工绘画活动。这表明需要评估可用绘画机器人的当前局限性,以生成可以作为提高APR效率的方法进一步研究的基础的信息。因此,这项研究的目的是确定有效的APR的特性,并将其与市售APR的特性进行比较。对Scopus数据库和Google Scholar库的相关文献进行了全面研究,介绍了定义APR性能的主要参数。该研究强调了评估APR性能以及可用机器人的当前局限性的主要特性。这项研究的结果有望为对提高APR生产率提高的研究人员提供进一步的研究领域。关键词:绘画机器人,自动移动机器人,建筑自动化,建筑安全
与区块链和AI的可扩展,安全和有效组合合并的下一代平台,该平台合并了工资访问(EWA)。
Volante在其服务司法管辖区的当前法律框架内运作。本文档仅出于信息目的,不应将其解释为法律,财务或投资建议。Volante对本文档中的任何错误或错误不承担任何责任,并且可以在未经事先通知的情况下更新内容。所有争议将根据适用司法管辖区的相关法律管辖。由于监管不确定性,我们的白皮书中详细介绍的计划的发展和部署可能会面临局限性,或者在某些领域无法获得限制。这些举措可能需要进行重组,或者可能部分或完全不可用,具体取决于监管环境。Volante可能取决于在某些发展阶段与有执照的第三方实体的关系。这些实体的许可状态的变化可能会影响Volante利用其服务的能力。
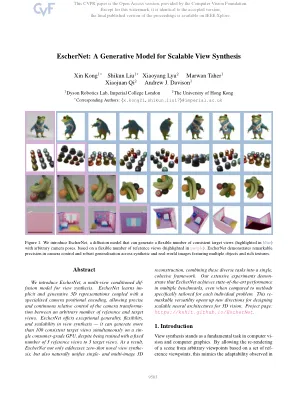
Eschernet:可扩展视图合成的生成模型
人类的视野。这种能力不仅对于诸如对象操纵和导航之类的实践日常任务至关重要,而且在培养人类创造力方面起着关键作用,使我们能够以深度,幽默感和沉浸感进行设想和制作对象。在本文中,我们重新审视了视图综合问题并提出:我们如何学习一般的3D表示以促进可扩展的视图综合?我们试图从以下两个观察结果中调查这个问题:i)到目前为止,目前的最新进展主要集中在训练速度和/或提高效率上[12,18,18,31,48]。值得注意的是,这些进步都共同依赖于体积渲染以进行场景优化。因此,所有这些视图合成方法固有地是场景特定的,再加上全局3D空间坐标。相比之下,我们主张一个范式移动,其中3D表示仅依赖场景颜色和几何形状,学习隐式表示无需地面真相3D几何形状,同时也从任何特定坐标系统中具有重要的独立性。这种区别对于实现可扩展性至关重要,以超越场景指编码所施加的约束。ii)本质上,视图合成更适合作为有条件的生成建模问题,类似于生成图像中的图像[25,60]。随着可用信息的增加,生成的场景变得更加限制,逐渐收敛于地面真相表示。仅给出一组稀疏的参考视图时,所需的模型应提供多个合理的预测,并利用生成表述中的固有随机性,并从自然图像统计信息和从其他图像和对象中学到的语义先验中获取见解。值得注意的是,现有的3D生成模型通常仅支持单个参考视图[20 - 23,44]。我们认为,更理想的生成配方应具有不同级别的输入信息。在这些见解的基础上,我们引入了Eschernet,这是一种图像到图像的条件扩散模型,用于视图合成。Eschernet利用了使用Dot-Product自我注意力的变压器体系结构[51],以捕获参考对目标和目标对目标视图一致性之间的复杂关系。Eschernet中的一个关键创新是相机位置编码(CAPE)的设计,专门代表4个DOF(以对象)和6个DOF相机姿势。这种编码的速率空间结构进入令牌,使模型能够仅基于其相对摄像机的转换来计算查询和密钥之间的自我注意事项。总而言之,Eschernet表现出以下非凡的特征:•一致性:埃舍内特固有地整合了视图的固定性,这要归功于相机位置编码的设计,从而鼓励了对目标对目标和目标视图视图的一致性。

”可扩展的监督学习算法,用于实时可再生能源预测智能电网”
将可再生能源集成到现代智能电网中,由于能源产生的可变性和不可预测性,提出了重大挑战。对可再生能源输出的准确实时预测对于确保网格稳定性,优化能量分布并最大程度地减少了能量浪费至关重要。本研究探讨了针对智能电网中实时可再生能源预测的可扩展监督学习算法的开发和应用。