
XiaoMi-AI文件搜索系统
World File Search System跟踪
基于事件流的视觉对象跟踪-CVF打开访问
以生物风格的活动相机跟踪近年来引起了人们的兴趣。现有的作品要么利用对齐的RGB和事件数据进行准确跟踪,要么直接学习基于事件的跟踪器。前者会产生较高的推理成本,而后者可能容易受到嘈杂事件或稀疏空间分辨率的影响。在本文中,我们提出了一个新型的分层知识蒸馏框架,该框架可以在培训期间完全利用多模式 /多视图信息,以促进知识转移,使我们能够仅使用事件信号来实现测试过程中高速和低潜伏期视觉跟踪。特别是,基于教师变压器的多模态跟踪框架首先是通过同时喂食RGB框架和事件流来训练的。然后,我们设计了一种新的分层知识蒸馏策略,其中包括成对相似性,功能表示和基于响应地图的知识蒸馏,以指导学生变形金刚网络的学习。在术语中,由于现有的基于事件的跟踪数据集都是低分辨率(346×260),因此我们提出了名为EventVot的第一个大规模高分辨率(1280×720)数据集。它包含1141个视频,并涵盖了许多类别,例如行人,车辆,无人机,乒乓球等。对低分辨率(Fe240Hz,Vi-Sevent,Coesot)和我们新提出的高分辨率EventVot数据集的进行了实验进行了实验

2024 SA AI 立法跟踪_2024 0820.docx
2024 年的《培育原创、促进艺术和保障娱乐安全(禁止假冒)法案》将要求个人或公司对制作、托管或共享个人在视听作品、图像或录音中表演的数字复制品承担损害赔偿责任,而该个人从未真正出现或以其他方式获得批准——包括由生成人工智能 (AI) 创建的数字复制品。托管未经授权复制品的在线服务必须在收到权利人的通知后删除该复制品。为公认的《第一修正案》保护提供了例外,例如纪录片和传记作品,或出于评论、批评或模仿等目的。该法案还将在很大程度上取代处理数字复制品的州法律,以创建可行的全国标准。发起人:参议员 Coons (D-DE);Blackburn (R-TN);Klobuchar (D-MN);蒂利斯 (R-NC) 最新行动:7/31/24 - 提交并提交给参议院 JUD。

即时见解:如何跟踪AI搜索
想为营销人员学习生成AI吗?参加我们的自节奏课程:https://www.trustinsights.ai/aicourse对如何将AI集成到您的工作中有疑问吗?问我们!请访问www.trustinsights.ai/aiservices,以获取更多帮助。

用于定位、导航和跟踪的粒子过滤器
开发了使用粒子滤波器(递归蒙特卡罗方法)解决定位、导航和跟踪问题的框架。提出了一种粒子维度简约的通用算法。汽车和航空应用从数字上说明了与基于卡尔曼滤波器的传统算法相比的优势。这里使用非线性模型和非高斯噪声是准确度提高的主要原因。更具体地说,我们描述了如何使用地图匹配技术将飞机的海拔剖面图与数字海拔地图进行匹配,将汽车的水平行驶路径与街道地图进行匹配。在这两种情况下,都可以实时实现,测试表明,其准确度可与卫星导航(如 GPS)相媲美,但完整性更高。基于模拟,我们还讨论了粒子滤波器如何用于基于手机测量的定位、飞机的综合导航以及飞机和汽车的目标跟踪。最后,粒子滤波器为导航和跟踪的组合任务提供了一个有希望的解决方案,这在空中搜寻和汽车防撞上都有所体现。

印度储能链接的招标跟踪器| 2018-2024
在竞争性招标空间中,总容量招标,有35%处于各个执行阶段,在招标过程中有28%,而37%的人已被取消。下表详细介绍了自2019年以来各个节点机构发行的所有11个招标的状态
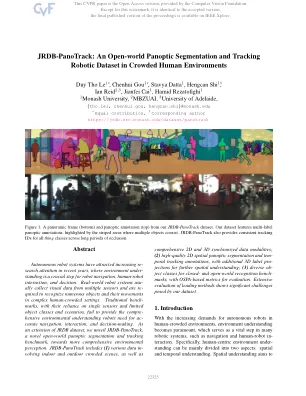
JRDB-Panotrack:一个开放世界的全景进行分割和跟踪拥挤的人类环境中的机器人数据集
自主机器人系统近年来引起了越来越多的关注,在这种环境中,环境是机器人导航,人类机器人互动和决策的关键步骤。现实世界机器人系统通常会从多个传感器中收集视觉数据,并经过重新识别以识别许多对象及其在复杂的人拥挤的设置中。传统的基准标记,依赖单个传感器和有限的对象类和场景,无法提供机器人对策划导航,互动和决策的需求的综合环境理解。作为JRDB数据集的扩展,我们揭开了一种新颖的开放世界式分割和跟踪基准,介绍了一种新型的开放世界式分割和跟踪基准。JRDB-Panotrack包括(1)各种数据室内和室外拥挤的场景,以及
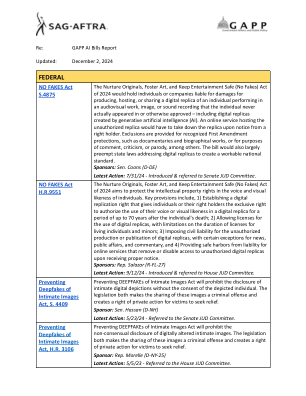
2024 SA AI 立法跟踪_2024 1202.docx
2024 年的《培育原创、促进艺术和保障娱乐安全(禁止假冒)法案》将要求个人或公司对制作、托管或共享个人在视听作品、图像或录音中表演的数字复制品承担损害赔偿责任,而该个人从未实际出现或以其他方式获得批准——包括由生成人工智能 (AI) 创建的数字复制品。托管未经授权复制品的在线服务必须在收到权利人的通知后删除该复制品。为公认的《第一修正案》保护提供了例外,例如纪录片和传记作品,或出于评论、批评或模仿等目的。该法案还将在很大程度上取代涉及数字复制品的州法律,以创建可行的国家标准。发起人:参议员 Coons (D-DE) 最新行动:7/31/24 - 提交并提交给参议院 JUD 委员会。

NST奖学金MPHIL 2024-2025(食品与农业科学)串行编号跟踪
外源睾丸激素对黑孟加拉山羊附睾后发育的影响6 1719490692 Abul Kasem kasem kasemrufish92@gmail.com拉杰沙希大学渔业系的影响naznin nahar nazninnila59@gmail.com拉杰沙希大学渔业系的生产力评估巴达虾(Penaeus monodon)农场,来自孟加拉国南部

intrinsicavatar:通过显式射线跟踪
我们提出了intincavatar,这是一种新的方法,是一种从单眼视频中照亮的,包括几何形状,反照率,材料和环境的内在特性。基于人类的神经渲染的最新进展已使来自单眼视频的穿着人类的高质量几何形状和外观重建。然而,这些方法烘烤了内在特性,例如反照率,材料和环境照明成一个单一的纠缠神经表示。另一方面,只有少数作品可以解决估计单眼视频中穿衣人类的几何形状和分离的外观特性的问题。,由于通过学习的MLP对次要阴影效应的近似值,他们通常会获得有限的质量和分离。在这项工作中,我们建议通过蒙特卡罗射线跟踪明确地对次级阴影效应进行建模。我们将衣服的人体的渲染过程建模为体积散射过程,并将射线跟踪与人体的作用相结合。我们的方法可以从单眼视频中恢复服装人类的高质量地理,反照率,材料和照明特性,而无需使用地面真相材料进行监督的预训练。fur-hoverore,因为我们明确地对体积散射过程和射线追踪进行了建模,所以我们的模型自然而然地形成了一般 -

基于计算机视觉方法的智能手机跟踪手动障碍
摘要。本文介绍了使用基于智能手机的计算机视觉技术来诊断手动障碍的经济高效,高效且可访问的解决方案的开发。它突出了使用TOF相机数据与RG数据和机器学习算法相结合的想法,以准确识别四肢和运动,这克服了传统运动识别方法的局限性,改善了康复和降低专业医疗设备的高成本。使用智能手机和先进的计算方法的无处不在,该研究提供了一种新的方法来提高运动障碍诊断的质量和可及性,为未来的研究和在临床实践中的研究和应用提供了有希望的方向。