
XiaoMi-AI文件搜索系统
World File Search System图像
medblip:3D医学图像和文本
摘要。视觉语言预处理(VLP)模型已在众多计算机视觉应用中被证明。在本文中,我们基于图像扫描和电子健康记录中的文本介绍,为医疗领域开发VLP模型,以促进计算机辅助诊断(CAD)。为了实现这一目标,我们介绍了MedBlip,这是一种轻巧的CAD系统,该系统启动了从架子冻结的预训练的图像编码器和大型语言模型中启动VLP。我们合并了一个MEDQFormer模块,以弥合3D医学图像和2D预训练的图像编码器和语言模型之间的差距。为了评估MEDBLIP的有效性,我们从五个公共阿尔茨海默氏病(AD)数据集中收集了30,000多个图像量:ADNI,NACC,OASIS,OASIS,AIBL和MIRIAD。在这个大规模的广告集中,我们的模型在健康,轻度认知障碍(MCI)和AD主题的零摄像分类中表现出了令人印象深刻的表现,并且还显示了其在M3D-VQA-AD数据集中的医学视觉问题An-Swering(VQA)中的能力。代码和预训练模型可在https://github.com/qybc/medblip上找到。

脑图像数据结构 (BIDS) 的过去、现在和未来
Poldrack,Russell A. 1,Markiewicz,Christopher J. 1,Appelhoff,Stefan 2,Ashar,Yoni K. 3,Auer,Tibor 4,5,Baillet,Sylvain,Sylvain 6,Bansal,Bansal,Shashank 7,Shashank 7,Beltrachini,Beltrachini,Beltrachini,Leanar,Leanar,Benar,Christian G. 9,Bertazzoli,bertazzoli,bertazzoli,bertazzoli,10,11,11,11,11,11,11,11,11,11,11,11,11,11,11,11,11,11,11,11,11,11,1111 ,, ,Blair,Ross W. 1,Bortoletto,Marta 10,Boudreau,Mathieu 16,Brooks,Teon L. 1,Teon L. 1,Calhoun,Vince D. 17,Castelli,Castelli,Filippo Maria 18,19,Clement,Clement,Patricia 20,21,Cohen,Cohen,Cohen,Cohen,Alexander L.22 23,24,吉尔斯(De Hollander),吉尔斯(De Hollander),25,de la iglesia-vayá,玛丽亚26,de la vega,Alejandro 27,Delorme,Arnaud,28,Devinsky,Orrin 29,Draschkow,Draschkow,Dejan,Dejan 30,Duff,Duff,Eugene Paul 31,Dupre,Dupre,Elizabeth 1,Earlin,Erlin,Erlind 32 Illaume 34,Galassi,Anthony 32,Gallitto,Giuseppe 35,36,Ganz,Melanie 37,38,Gau,Rémi39,Gholam 39,Gholam,James 40,Ghosh,Satrajit S. 41,Giacomel,Giacomel,Giacomel,Alessio,Alessio,Alessio 42 44 , Gramfort, Alexandre 45 , Guay, Samuel 46 , Guidali, Giacomo 47 , Halchenko, Yaroslav O. 48 , Handwerker, Daniel A. 32 , Hardcastle, Nell 1 , Herholz, Peer 49 , Hermes, Dora 50 , Honey, Christopher J. 51 , Innis, Robert B. 32 , Ioanas, Horea-Ioan 48 , Jahn, Andrew 52 , Karakuzu, Agah 16 , Keator, David B. 53,54,55 , Kiar, Gregory 56 , Kincses, Balint 35,36 , Laird, Angela R. 57 , Lau, Jonathan C. 58 , Lazari, Alberto 59 , Legarreta, Jon Haitz 60 , Li, Adam 61 , Li, Xiangrui 62 ,Love,Bradley C. 63,Lu,Hanzhang 64,Marcantoni,Eleonora 65,Maumet,Camille 66,Mazzamuto,Giacomo67,Meisler 67,Meisler,Steven L. 68,Mikkelsen,Mikkelsen,Mark 69 4,75,Niso,Guiomar 76,Norgaard,Martin 32,37,Okell,Thomas W. 59,Oostenveld,Robert 77,78,Ort,Ort,Eduard 79,Park J. 80,Patrick J. 80,Pawlik,Pallik,Pallik,Mateusz,Mateusz 81,Pernet,Pernet,Pernet,Cyril R.38,Pestilli,Pestilli,Pestilli,Petilli,franco,Petr,Petr,Petr,Jan,Jan 272菲利普斯(Phillips),克里斯托夫(Christophe),83,派恩,让·巴蒂斯特(Jean-Baptiste)84,波罗尼尼(Pollonini),卢卡(Luca)85,86,拉马纳(Raamana),普拉德普·雷迪(Pradeep Reddy),里特(Ritter),佩特拉(Ritter),佩特拉(Petra)88,89,90,91,92,里佐(Rizzo) 99,Routier,Alexandre 100,Saborit-Torres,Jose Manuel 26,Salo,Taylor 101,Schirner,Michael 88,89,90,91,92,Smith,Smith,Robert E. 102,103,Spisak,Spisak,Spisak,Spisak,Tamas,Tamas 35,104,Sprenger,Sprenger,Julia,Julia 105,Swann,Swann,Swann,Swann,Nicole C. C. C. Nicole C. 106 , Szinte, Martin 105 , Takerkart, Sylvain 105 , Thirion, Bertrand 45 , Thomas, Adam G. 32 , Torabian, Sajjad 107 , Varoquaux, Gael 108 , Voytek, Bradley 109 , Welzel, Julius 110 , Wilson, Martin 111 , Yarkoni, Tal 112 , Gorgolewski, Krzysztof J. 1
ODM:文本图像进一步的对齐预训练方法,用于场景文本检测和发现
近年来,文本图像联合预训练技术在各种任务中显示出令人鼓舞的结果。然而,在光学特征识别(OCR)任务中,将文本实例与图像中的相应文本区域对齐是一个挑战,因为它需要在文本和OCR文本之间有效地对齐(将图像中的文本称为ocr-文本以与自然语言中的文本区分开来),而不是对整体图像内容的全面理解。在本文中,我们提出了一种新的预训练方法,称为o cr-text d估计化m odeling(ODM),该方法根据文本提示将图像中的文本样式传输到统一样式中。使用ODM,我们在文本和OCR文本之间实现了更好的对齐方式,并启用预训练的模型以适应场景文本的复杂和多样化的样式。此外,我们为ODM设计了一种新的标签生成方法,并将其与我们提出的文本控制器模块相结合,以应对OCR任务中注释成本的挑战,并以大量未标记的数据参与预培训。在多个Pub-LIC数据集上进行的广泛实验表明,我们的方法显着地证明了性能,并且在场景文本检测和发现任务中的当前预训练方法优于当前的预训练方法。代码在ODM上可用。


卫星图像处理中的人工智能&...
卫星图像处理是管理我们星球资源的强大工具之一。最近,它在应对全球挑战(例如资源管理,可持续性,气候变化,灾难管理和响应,作物监测等)等全球挑战方面非常重要。图像处理中AI技术的演变已成为处理卫星图像的动力。通过提供高级工具进行分析。FDP旨在深入了解AI在卫星图像处理及其应用中的范围和影响。

FedDG:通过连续频率空间中的情节学习对医学图像进行分割的联合域概括
联合学习允许分布式的医疗机构可以协作学习具有隐私保护的共享预测模型。在临床部署时,接受联邦学习的模型仍会在联邦外面完全看不见的霍斯群岛上使用时仍会遭受性能下降。在本文中,我们指出并解决了联合域的生成(FedDG)的新型问题设置,该设置旨在从多个分布式源域中学习联合模型,以便它可以直接概括为看不见的目标域。我们提出了一种新颖的方法,在持续频率空间(ELCF)中称为情节学习,通过启动每个客户端在数据分散率的挑战性约束下利用多源数据分布来利用多源数据分布。我们的方法通过有效的连续频率空间插值机制以隐私保护方式传输客户之间的分布信息。通过转移的多源分布,我们进一步仔细设计了面向边界的情节学习范式,以将本地学习暴露于域分布变化,尤其是在医学图像分割场景中尤其满足模型概括的挑战。在两个医学图像分割任务上,我们的方法的有效性优于最先进的表现和深入消融实验。可以在https://github.com/liuquande/feddg-elcfs上使用代码。
具有深层生成模型的扩散加权磁共振大脑图像的现实产生
深度学习方法有可能减轻放射科医生处理繁琐的,耗时的任务,例如检测和细分病理病变[1],但是在医学成像的背景下对神经网络的培训面临着主要的挑战:它们需要训练大量图像,因为这是很难获得的,因为在许多方面都可以限制医疗信息,并且由于许多方面的范围限制了其他方面的范围。此外,虽然在世界各地的医院数据库中可以提供相对较大的医学图像,但这些图像是未标记的,并且不同的机构以派遣和不均匀的方式保存医疗图像,这使得它们在较大的数据库中收集它们。在这种情况下,从头开始生成医学图像的方法可能引起人们的极大兴趣。生成建模是机器学习的一个子字段,它在产生新的高质量自然图像(例如面部照片[2])方面具有令人印象深刻的精力[2],并应用于语音综合[3]和磁共振图像重建等任务[4]。如果可以教导生成模型来产生现实且多样化的新医学图像,那么它们将具有很有吸引力的潜力,可以显着增加可用于深神经网络培训的图像数量,因此可以帮助提高这些网络的准确性[5-7]。
ZK证明图像转换瓷砖在您的笔记本电脑上
[nt s&p2016] A. Naveh和E. Tromer,“ Photoproof:任何一组允许转换的加密图像身份验证” - S&P- 2016
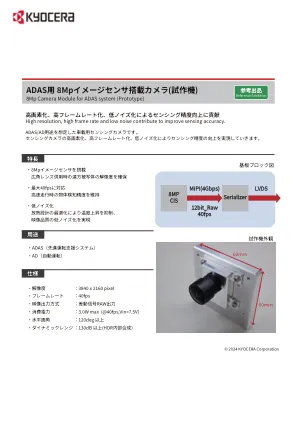
8MP图像传感器配备ADA的相机(原型机)
3( *34co𝑃𝑃𝑃𝑃𝑃𝑃↑注意4fotjoh efwjdf uibu efufdu up pckfdu up pckfdu jo b wbsjfuz pg tjuvbujpot cz ijhi sftpmvujpo tufsfpo tufsfp tufsfp dbnfs dbnfs dbnfs dbnfs dbnfsb xjui 3(