
XiaoMi-AI文件搜索系统
World File Search System多模式
通过非侵入式脑机接口和生成式人工智能辅助多模式软件记录梦境
摘要:本研究提出了一种新的梦境记录方法,该方法结合了非侵入式脑机接口 (BMI)、思维输入软件和生成式 AI 辅助多模态软件。该方法旨在将 REM 睡眠期间的意识过程升华到半意识状态,并产生用于思维输入的信号。我们概述了一个两阶段的过程:首先,使用生成式 AI 开发多模态软件来补充文本流并生成多媒体内容;其次,采用基于摩尔斯电码的打字方式来简化信号要求并提高打字速度。我们通过建议一种涉及植入 BMI 的用户的控制系统来优化非侵入式信号,从而应对非侵入式 EEG 的挑战。文献综述重点介绍了 BMI 打字、意识过程升华以及生成式 AI 在基于文本提示的思维输入方面的潜力方面的最新进展。

多模式推理的问题意识视力变压器
视觉语言(VL)模型已获得了显着的重点,从而在多模式推理方面取得了显着进步。这些体系结构通常包括视觉编码器,大型语言模型(LLM)和一个将视觉特征与LLM的代表空间保持一致的投影模块。尽管他们成功了,但仍然存在一个关键的限制:愿景编码过程仍然与用户查询相关,通常是以与图像相关的问题的形式。因此,所得的视觉特征可能无法最佳地调整图像的特定元素。为了解决这个问题,我们介绍了QA-Vit,这是一种问题的多模式原因,这是一种问题,将问题意识直接嵌入到视觉编码器中。此集成导致动态视觉特征,重点是提出问题的相关图像方面。QA-VIT是模型 - 静态的,并且可以有效地将其置于任何VL体系结构中。广泛的经验证明了将我们的方法应用于各种多模式体系结构的有效性,从而导致跨不同任务的一致改进,并展示了其以增强视觉和场景文本理解的能力。

大多数:运动预测的多模式场景象征化
许多现有的运动预测方法都依赖于符号感知输出来生成代理轨迹,例如边界框,路图信息和traf-fight。这种符号表示是现实世界的高级表现,它可能会使运动预测模型容易受到感知错误的影响(例如,在检测开放式录音障碍时失败),而缺少场景中的显着信息(例如,糟糕的道路条件)。另一种范式是从原始传感器中端到端学习。但是,这种方法缺乏解释性,需要大量的培训资源。在这项工作中,我们提出将视觉世界的标记化为一组紧凑的场景元素,然后利用预先训练的图像基础模型和LiDAR神经网络以开放式播音方式进行编码所有场景元素。图像基础模型使我们的场景令牌可以编码开放世界的一般知识,而LiDAR神经网络编码几何信息。我们提出的表示形式可以有效地用几百个令牌编码多帧多模式观察,并且与大多数基于变压器的体系结构兼容。为了评估我们的方法,我们使用了带有凸轮嵌入的Waymo开放运动数据集。通过Waymo开放运动数据集进行的实验表明,我们的方法会导致对最先进的表现的显着改善。
U-Limb:关于健康和中风后手臂运动控制的多模式、多中心数据库
1 “Enrico Piaggio”研究中心和 Dipartimento di Ingegneria dell'Informazione,比萨拉戈大学 Lucio Lazzarino 1, 56122 比萨,意大利; 2 用于人类合作与康复的软机器人,Fondazione Istituto Italiano di Tecnologia,Via Morego 30, 16163 Genova,意大利; 3 RSI - 慕尼黑工业大学 (TUM) 慕尼黑机器人与机器智能学院机器人与系统智能主席,Heßstr。 134, 80797 慕尼黑, 德国; 4 MoMiLab 研究中心,IMT 卢卡高级研究学院,Piazza S. Francesco 19, 55100 Lucca, Italy; 5 苏黎世大学神经病学系血管神经病学和神经康复科,Frauenklinikstrasse 26, 8006 苏黎世,瑞士;6 汉诺威医学院矫形外科系生物力学和生物材料实验室 (LBB),L384, 30625 汉诺威,德国;7 苏黎世健康科学与技术系机器人与智能系统研究所康复工程实验室,CLA H 1.1 Tannenstrasse 3, 8092 苏黎世,瑞士
多模式面部图像生成的扩散驱动的GAN倒置
摘要我们提出了一种新的多模式面部图像生成方法,该方法将文本提示和视觉输入(例如语义掩码或涂鸦图)转换为照片真实的面部图像。为此,我们通过使用DM中的多模式特征在预训练的GAN的潜在空间中使用多模式特征来结合一般的对抗网络(GAN)和扩散模型(DMS)的优势。我们提供了一个简单的映射和一个样式调制网络,可将两个模型链接起来,并在特征地图和注意力图中将有意义的表示形式转换为潜在代码。使用gan inversion,估计的潜在代码可用于生成2D或3D感知的面部图像。我们进一步提出了一种多步训练策略,该策略将文本和结构代表反映到生成的图像中。我们提出的网络生成了现实的2D,多视图和风格化的面部图像,这些图像与输入很好。我们通过使用预训练的2D和3D GAN来验证我们的方法,我们的结果表现优于现有方法。我们的项目页面可在https://github.com/1211SH/diffusion-driven_gan-inversion/。
增强具有生成负面挖掘的视觉语言模型的多模式组成推理
当代的大规模视觉语言模型(VLM)具有强大的表示能力,使它们无处不在,可以增强图像和文本理解任务。他们经常以对比的方式受到大量图像和相应的文本字幕的对比方式进行训练。尽管如此,VLMS经常在构图推理任务上挣扎,这些任务对对象及其属性的复杂相互作用进行了精细的了解。此失败可以归因于两个主要因素:1)对比的方法传统上专注于从现有数据集中开采负面示例。但是,该模型可能不难区分阳性检查。替代采矿的替代方法是负样本2),但现有的生成方法主要集中于生成与给定图像相关的硬性负面文本。在另一个方向上进行挖掘,即生成与给定文本相关的负面图像样本已被忽略。为了克服这两种限制,我们提出了一个框架,不仅在两个方向上矿山,而且在这两种方式(即图像和文本)中产生了有挑战性的负面样本。利用这些生成硬性负样本,我们在涉及多模式综合推理的任务中显着提高了VLMS的性能。我们的代码和数据集在https://ugorsahin.github.io/enhancing-- vlm.html上发布。

通过熵和引导多模式融合在不利天气条件下增强对象检测
摘要。通过互补感应方式整合各种表示形式对于自主驾驶中的强大场景解释至关重要。近年来,融合视觉和范围数据的深度学习体系结构具有先进的2D和3D对象检测。但是,这些方式在不利的天气或照明条件下通常会降解,从而导致性能下降。虽然已经开发了域适应性甲基元素来弥合源域和目标域之间的缝隙,但由于源和目标域之间的固有差异,它们通常会缺乏。此差异可以在数据的不同分布和不同特征空间的不同分布中表现出来。本文介绍了一个全面的域自适应对象检测框架。通过深度转移学习开发,该框架旨在从标记的透明天气数据中稳健地概括到无标记的不良天气条件,从而增强了基于深度学习的对象检测模型的性能。创新的斑块熵融合模块(PEFM)是我们方法的核心,该方法动态整合了sens-sor数据,强调关键信息并最大程度地减少了背景干扰。这进一步补充了一种新型的加权决策模块(WDM),该模块(WDM)根据其在特定环境条件下的功效来调整不同传感器的贡献,从而优化了检测准确性。此外,我们在转移学习过程中集成了域对齐损失,以确保有效的域适应性通过将特征图差异定于清晰和不利天气数据集之间的差异。我们评估了不同数据集的模型,包括Exdark(单峰),CityScapes(单峰)和密集(Mul-timodal),在我们评估的时间点,它在所有数据集中排在所有数据集中。
L2词汇音调采集中的多模式提示
海洋生物膜是全球无处不在的表面相关微生物群落,由于其独特的结构和功能,引起了人们的关注。The aim of this study is to provide a comprehensive overview of the current scienti fi c understanding, with a speci fi c focus on naturally occurring bio fi lms that develop on diverse marine abiotic surfaces, including microplastics, sea fl oor sediments, subsurface particles, and submerged arti fi cial structures susceptible to biocorrosion and biofouling induced by marine bio fi LMS。本文介绍了有关海洋环境中这些表面相关微生物群落的多样性,结构,功能和动态的最新进展和发现,突出了它们的生态和生物地球化学维度,同时也是为了进一步研究海洋生物生物LMS的灵感。

一种多模式的方法利用脑电图研究VR环境对心理工作负载的影响
抽象虚拟现实(VR)是一项允许用户体验模拟真实或虚构场景的多感觉和交互式环境的技术。仍然辩论了不同的VR沉浸式技术神学对心理工作量(MWL)的影响,即执行任务所需的资源数量;但是,从未利用脑电图在这种情况下的潜在作用。本文旨在调查在VR环境中对MWL进行认知任务的影响,这是通过使用多模式的方法进行的,其特征在于以不同程度的沉浸式来进行,这些方法通过生理EEG测量对MWL进行了良好评估的主观评估。提出了基于N-BACK测试的认知任务,以比较使用头部安装显示器(HMD)或桌面计算机展示Stim uli的特定裤子的性能和MWL。任务具有四个不同的复杂度(N¼1或2具有视觉或视觉和听觉刺激)。二十七名健康参与者都参加了这项研究,并在两种情况下都执行了任务。EEG数据和NASA任务负荷指数(NASA-TLX)分别用于评估客观和主观MWL的变化。 错误率(ER)和反应时间(RTS)也针对每个条件和任务水平进行了COL。 任务水平在两种情况下都对MWL产生了重大影响,增加了次级措施和降低性能。 EEG MWL指数显示出显着增加,特别是与休息相比。 不同程度的沉浸式均未显示个人的表现和MWL的显着差异,如主观评分所估计。EEG数据和NASA任务负荷指数(NASA-TLX)分别用于评估客观和主观MWL的变化。错误率(ER)和反应时间(RTS)也针对每个条件和任务水平进行了COL。任务水平在两种情况下都对MWL产生了重大影响,增加了次级措施和降低性能。EEG MWL指数显示出显着增加,特别是与休息相比。 不同程度的沉浸式均未显示个人的表现和MWL的显着差异,如主观评分所估计。EEG MWL指数显示出显着增加,特别是与休息相比。不同程度的沉浸式均未显示个人的表现和MWL的显着差异,如主观评分所估计。但是,在大多数情况下,HMD降低了EEG衍生的MWL,表明较低的认知负载。总而言之,HMD可能会减少某些任务的认知负担。如脑电图MWL指数所示,MWL的降低水平可能对基于VR的应用程序的设计和未来评估有影响。
多模式和多任务自动驾驶数据集
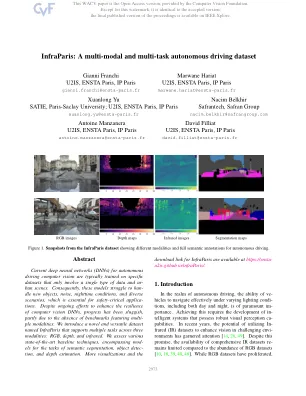
当前用于自动驾驶计算机视觉的深层神经网络(DNNS)通常在仅涉及单一类型的数据和urban场景的特定数据集上进行培训。因此,这些模型努力使新物体,噪音,夜间条件和各种情况,这对于安全至关重要的应用至关重要。尽管持续不断努力增强计算机视觉DNN的弹性,但进展一直缓慢,部分原因是缺乏具有多种模式的基准。我们介绍了一个名为Infraparis的新颖和多功能数据集,该数据集支持三种模式的多个任务:RGB,DEPTH和INDRARED。我们评估了各种最先进的基线技术,涵盖了语义分割,对象检测和深度估计的任务。更多可视化和