
XiaoMi-AI文件搜索系统
World File Search SystemConti


进化:增强无监督的持续学习与多位专家
近年来在未加强的持续学习方法中取得了重大进展。尽管它们在受控设置中取得了成功,但它们在现实世界中的实用性仍然不确定。在本文中,我们首先从经验上介绍了现有的自我保护的持续学习方法。我们表明,即使有了重播缓冲液,现有的methods也无法保留与时间相关输入的视频的关键知识。我们的见解是,无监督的持续学习的主要挑战源于无法预测的意见,缺乏监督和先验知识。从Hybrid AI中汲取灵感,我们介绍了E Volve,这是一个创新的框架,它是云中的多个预审预周化模型,作为专家,以加强对Lo-cal Clister的现有自我监督的学习方法。e Volve通过新颖的专家聚合损失来利用专家指导,并从云中返回并返回。它还根据专家的信心和量身定制的先验知识将权重动态分配给专家,从而为新流数据提供自适应监督。我们在几个具有时间相关的实地世界数据流中广泛验证了E volve。结果令人信服地表明,E Volve超过了最佳的无监督持续学习方法,在跨Var-IOS数据流的Top-1线性评估准确性中,volve持续了6.1-53.7%,从而确认了多样化的专家指南的功效。代码库位于https://github.com/ orienfish/evolve。
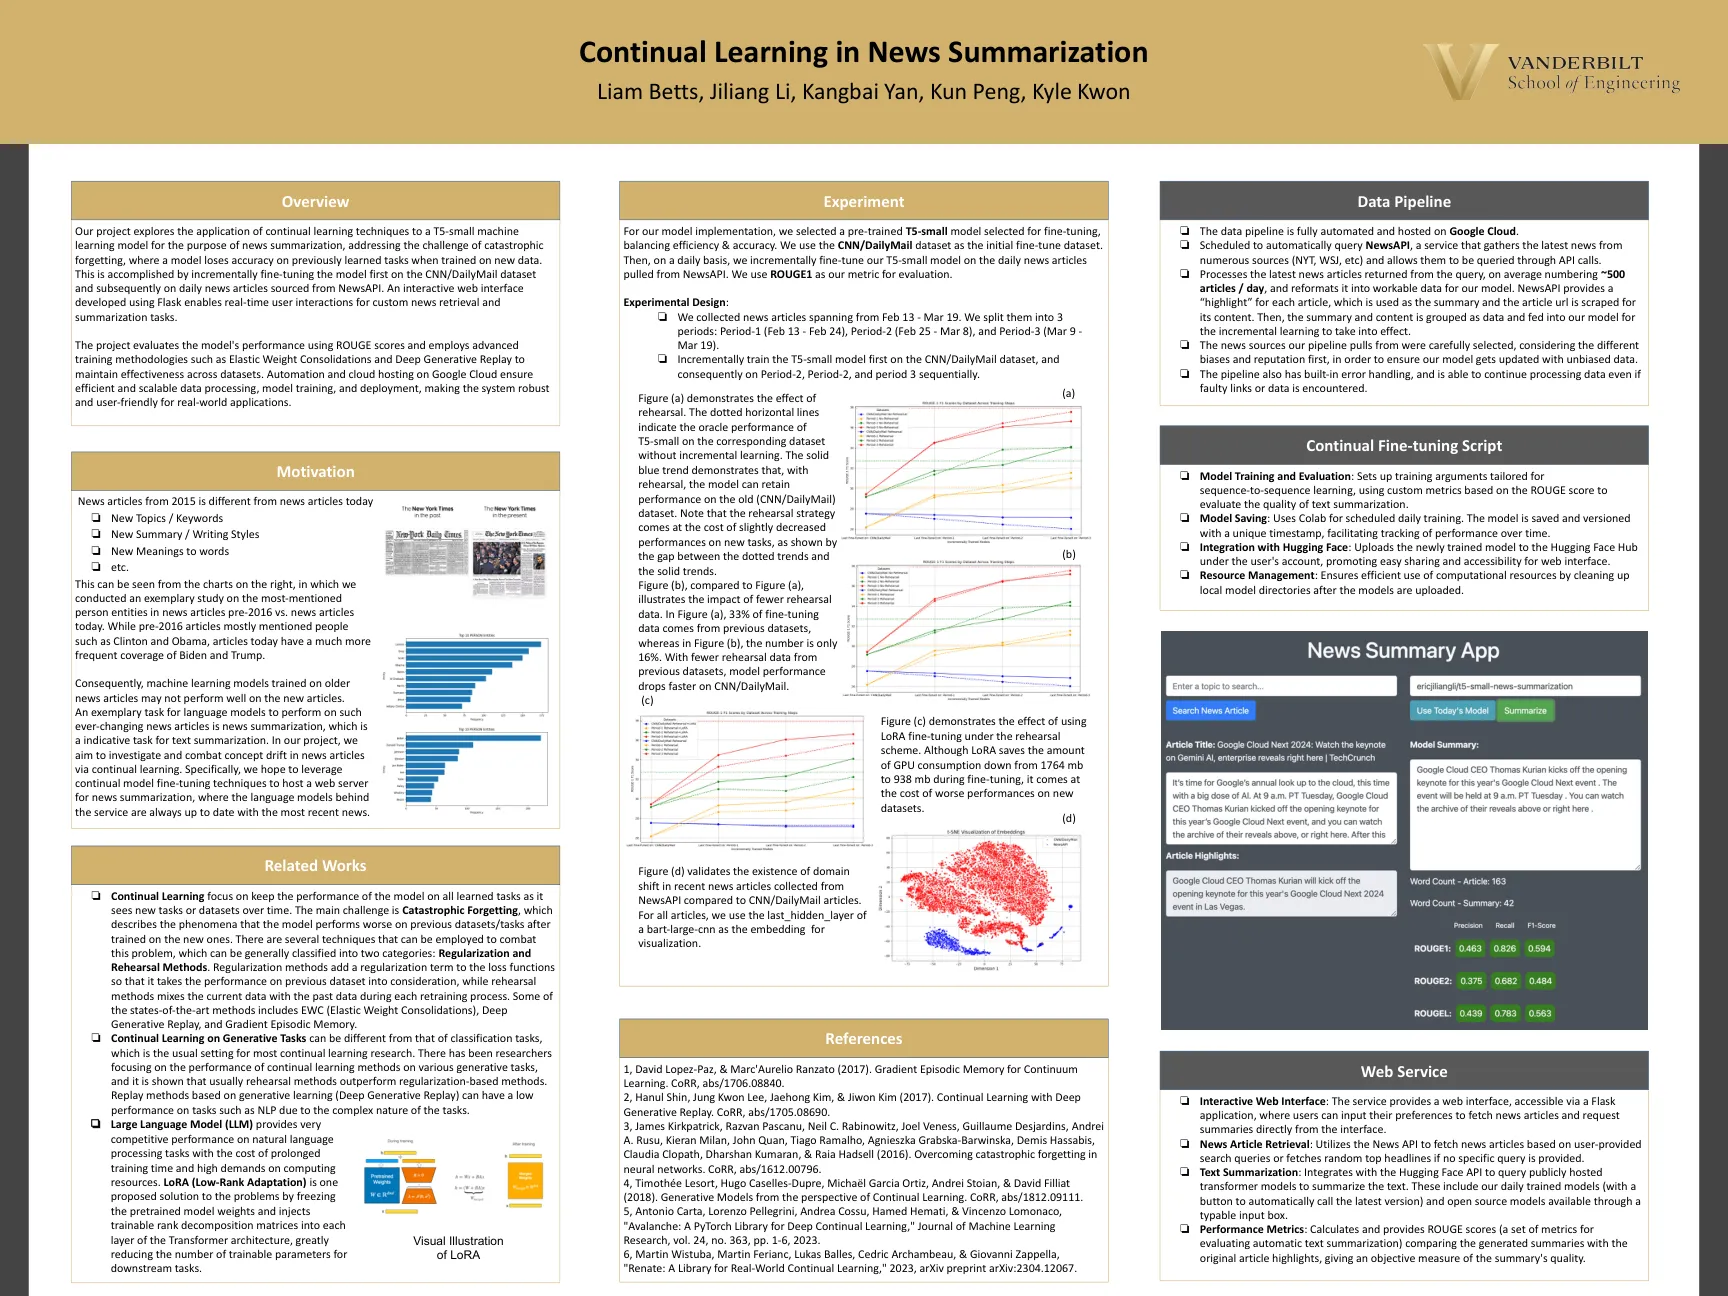
新闻摘要中的持续学习-Jiliang(Eric)li
Web服务1,David Lopez-Paz和Marc'aurelio Ranzato(2017)。连续学习的梯度情节记忆。corr,ABS/1706.08840。2,Hanul Shin,Jung Kwon Lee,Jaehong Kim和Jiwon Kim(2017)。 持续学习,并具有深刻的生成重播。 corr,ABS/1705.08690。 3,詹姆斯·柯克帕特里克(James Kirkpatrick),拉兹万·帕斯卡努(Razvan Pascanu),尼尔·C·拉比诺维茨(Neil C. Hadsell(2016)。 克服神经网络中的灾难性遗忘。 Corr,ABS/1612.00796。 4,TimothéeLesort,Hugo Caselles-Dupre,MichaëlGarciaOrtiz,Andrei Stoian和David Filliat(2018)。 从持续学习的角度来看生成模型。 corr,ABS/1812.09111。 5,Antonio Carta,Lorenzo Pellegrini,Andrea Cossu,Hamed Hemati和Vincenzo Lomonaco,“ Avalanche:Pytorch的深度持续学习图书馆”,《机器学习研究杂志》,第1卷。 24,否。 363,pp。 1-6,2023。 6,Martin Wistuba,Martin Ferianc,Lukas Balles,Cedric Archambeau和Giovanni Zappella,“ Renate:现实世界中持续学习的图书馆”,2023年,Arxiv Preprint Arxiv:2304.12067。2,Hanul Shin,Jung Kwon Lee,Jaehong Kim和Jiwon Kim(2017)。持续学习,并具有深刻的生成重播。corr,ABS/1705.08690。3,詹姆斯·柯克帕特里克(James Kirkpatrick),拉兹万·帕斯卡努(Razvan Pascanu),尼尔·C·拉比诺维茨(Neil C. Hadsell(2016)。克服神经网络中的灾难性遗忘。Corr,ABS/1612.00796。4,TimothéeLesort,Hugo Caselles-Dupre,MichaëlGarciaOrtiz,Andrei Stoian和David Filliat(2018)。 从持续学习的角度来看生成模型。 corr,ABS/1812.09111。 5,Antonio Carta,Lorenzo Pellegrini,Andrea Cossu,Hamed Hemati和Vincenzo Lomonaco,“ Avalanche:Pytorch的深度持续学习图书馆”,《机器学习研究杂志》,第1卷。 24,否。 363,pp。 1-6,2023。 6,Martin Wistuba,Martin Ferianc,Lukas Balles,Cedric Archambeau和Giovanni Zappella,“ Renate:现实世界中持续学习的图书馆”,2023年,Arxiv Preprint Arxiv:2304.12067。4,TimothéeLesort,Hugo Caselles-Dupre,MichaëlGarciaOrtiz,Andrei Stoian和David Filliat(2018)。从持续学习的角度来看生成模型。corr,ABS/1812.09111。5,Antonio Carta,Lorenzo Pellegrini,Andrea Cossu,Hamed Hemati和Vincenzo Lomonaco,“ Avalanche:Pytorch的深度持续学习图书馆”,《机器学习研究杂志》,第1卷。24,否。363,pp。1-6,2023。6,Martin Wistuba,Martin Ferianc,Lukas Balles,Cedric Archambeau和Giovanni Zappella,“ Renate:现实世界中持续学习的图书馆”,2023年,Arxiv Preprint Arxiv:2304.12067。6,Martin Wistuba,Martin Ferianc,Lukas Balles,Cedric Archambeau和Giovanni Zappella,“ Renate:现实世界中持续学习的图书馆”,2023年,Arxiv Preprint Arxiv:2304.12067。
通过稀疏诱导生成来培养大脑以实现持续学习
深度神经网络在持续学习中会遭受灾难性遗忘,在优化新任务时,它们往往会丢失有关先前学习过的任务的信息。最近的策略是隔离先前任务的重要参数,以便在学习新任务时保留旧知识。然而,使用固定的旧知识可能会成为获取新表示的障碍。为了克服这个限制,我们提出了一个框架,通过吸收新任务的知识来演化先前分配的参数。该方法在两个不同的网络下执行。基础网络学习顺序任务的知识,而稀疏诱导超网络为每个时间步骤生成参数以演化旧知识。生成的参数将基础网络的旧参数转换为反映新知识。我们设计超网络以根据任务特定信息和基础网络的结构信息生成稀疏参数。我们在图像分类和视频动作识别任务的类增量和任务增量学习场景中评估了所提出的方法。实验结果表明,通过发展旧知识,所提出的方法在这些场景中始终优于各种各样的持续学习方法。

SUD 1-21-25 的数字应急管理
● 技术援助协作组织 (TAC) 成立于 2023 年 4 月 ● 由 MSU、UM 和 WSU 组成 ● 与 MDHHS 合作 ● 为接受阿片类药物和解资金的县、市和乡镇级社区提供技术援助和专业知识 ● 专注于基于证据的最佳实践、有前景的计划和策略,以补救阿片类药物过量死亡 ● TAC 学习系列为政府官员、社区和公众提供了一个每月听取我们专家意见的机会

应急计划的考虑事项
虽然不可能为每一种可能性做好计划,但你越能预见和准备,就越有可能找到公平公正的解决方案,而不必在最后一刻手忙脚乱。CoE 建议开发混合灵活 (HyFlex) 课程,因为它们内置了在再次紧急关闭教室时的选项。HyFlex 课程为每种学习目标提供等效的面对面和在线课程。无论学生是在实体教室上课还是参加等效的 Canvas 课程,他们都会获得相同质量的教学。教授相同或相似课程的教师可以协作分配工作量,为此类课程创建材料。一些教师还聘请了 GSI 和 IA 来帮助录制视频和准备材料(请记住 GSI 和 IA 也是学生,并记住他们受雇工作的时间 - 通常 GSI 最多工作 0.5 小时,IA 每周工作约 10 小时;请与您所在部门的管理员确认)。

人工智能和继续教育计划
进一步说,终身学习的根源在于这样的信念:教育不局限于人生的某个特定时期或阶段,而是一个不断获取新知识和技能的过程。这一框架认识到,个人需要不断适应和学习,以满足劳动力不断变化的需求,并追求个人成长和发展。在人工智能和继续教育计划的背景下,终身学习的原则为理解将人工智能融入教育和技能提升计划的重要性提供了基础,以使个人在就业市场上保持竞争力。通过接受终身学习原则,个人可以培养学习和适应新技术和进步的能力,并在快速变化的就业市场中继续取得成功。

FedDG:通过连续频率空间中的情节学习对医学图像进行分割的联合域概括
联合学习允许分布式的医疗机构可以协作学习具有隐私保护的共享预测模型。在临床部署时,接受联邦学习的模型仍会在联邦外面完全看不见的霍斯群岛上使用时仍会遭受性能下降。在本文中,我们指出并解决了联合域的生成(FedDG)的新型问题设置,该设置旨在从多个分布式源域中学习联合模型,以便它可以直接概括为看不见的目标域。我们提出了一种新颖的方法,在持续频率空间(ELCF)中称为情节学习,通过启动每个客户端在数据分散率的挑战性约束下利用多源数据分布来利用多源数据分布。我们的方法通过有效的连续频率空间插值机制以隐私保护方式传输客户之间的分布信息。通过转移的多源分布,我们进一步仔细设计了面向边界的情节学习范式,以将本地学习暴露于域分布变化,尤其是在医学图像分割场景中尤其满足模型概括的挑战。在两个医学图像分割任务上,我们的方法的有效性优于最先进的表现和深入消融实验。可以在https://github.com/liuquande/feddg-elcfs上使用代码。
