
XiaoMi-AI文件搜索系统
World File Search SystemGenerate

计划、参加、生成:规划序列到...
我们研究了使用注意力机制将规划机制集成到序列到序列模型中。我们开发了一个模型,该模型可以在计算输入和输出序列之间的对齐时提前规划未来,构建一个拟议未来对齐矩阵和一个承诺向量,该承诺向量决定是否遵循或重新计算计划。该机制的灵感来自最近提出的强化学习战略性专注读者和作家 (STRAW) 模型。我们提出的模型是端到端可训练的,主要使用可微分操作。我们表明,它在 WMT'15 的字符级翻译任务、查找图的欧拉电路的算法任务以及从文本生成问题方面的表现优于强大的基线。我们的分析表明,该模型计算出定性的直观对齐,比基线收敛得更快,并且以更少的参数实现了卓越的性能。

人工智能生成文本检测工具的测试
生成式预训练 Transformer 大型语言模型的最新进展强调了在学术环境中不公平使用人工智能 (AI) 生成内容的潜在风险,并加大了寻找检测此类内容的解决方案的力度。本文研究了人工智能生成文本检测工具的一般功能,并根据准确性和错误类型分析对其进行了评估。具体来说,该研究试图回答以下研究问题:现有检测工具是否能够可靠地区分人类书写的文本和 ChatGPT 生成的文本,以及机器翻译和内容混淆技术是否会影响对人工智能生成文本的检测。该研究涵盖了 12 种公开可用的工具和两种在学术环境中广泛使用的商业系统(Turnitin 和 PlagiarismCheck)。研究人员得出结论,现有的检测工具既不准确也不可靠,主要偏向于将输出归类为人类书写的文本,而不是检测人工智能生成的文本。此外,内容混淆技术会显著降低工具的性能。该研究做出了几项重要贡献。首先,它总结了该领域最新的类似科学和非科学成果。其次,它展示了迄今为止最全面的测试之一的结果,该测试基于严格的研究方法、原始文档集和广泛的工具覆盖范围。第三,它讨论了在学术环境中使用检测工具检测人工智能生成的文本的含义和缺点。

评估 AI 生成音乐的启发式方法
- 需要大量“真实”数据 - 这些数据可能会有偏差 - 示例:统计差异箱的数量 (NDB) - 示例:MuseGAN 客观指标(下一张幻灯片) - 人类专业知识

人工智能生成的艺术和创造力
当使用人工智能来创作艺术作品时,它会阻止人们使用自己的创造力和思维技能来创作艺术作品。由于许多不同的网站制作相同的艺术作品并且不知道谁是第一个创作的,因此人工智能艺术也存在许多版权问题。而且,人工智能艺术没有真实性,有时还会出现错误。很多时候,人工智能无法生成您要求它生成的内容,因为它无法正确理解您的要求,因此有时它们生成的图片可能与您想要的完全不同。
炼油者:一个自动化框架生成任务...
ab s tr a ct。 p a r c e ll a t i o n s e d i n r e s t i ng -s t a t e t e f m ri(r s -f m ri) f un c t i o n a l d i ff e r e n c e s an nd t h e d o w n s t r e am t a s k。I n t h i s p a p e r , w e i n t r o du c e R e f i n e N e t , a B a y e s i a n - i n s p i r e d d ee p n e t w o r k a r c h i t e c t u r e t h a t a d j u s t s r e g i o n b o und a r i e s b a s e d o n i nd i v i du a l f Un c t i o n a l c o nn e c t i v i ty p r o f il e s。R e f i n e N e t u s e s a n i t e r a t i v e v o x e l r e a ss i gn m e n t p r o c e du r e t h a t c o n s i d e r s n e i ghb o r h oo d i n f o r ma t i o n w h il e b a l a n c i ng t e m p o r a l c o h e r e n c e o f t h e r e f i n e d p a r c e ll a t i o n。W e v a li d a t e R e f i n e N e t o n r s - f M RI d a t a f r o m t h r ee d i ff e r e n t d a t a s e t s , e a c h o n e g e a r e d t o w a r d s a d i ff e r e n t p r e d i c t i v e t a s k : ( 1 ) c o gn i t i v e f l u i d i n t e lli g e n c e p r e d i c t i o n u s i ng t h e H C P d a t a s e t ( r e g r e ss i o n ) , ( 2 ) a u t i s m v e r s u s c o n t r o l d i a gn o s i s u s i ng t h e A B I D E II d a t a s e t ( c l a ss i f i c a t i o n ) , a nd ( 3 ) l a ngu a g e l o c a li z a t i o n u s i ng a n r s - f M RI b r a i n t u m o r d a t a s e t ( s e g m e n t a t i o n ) .W e d e m o n s t r a t e t h a t R e f i n e N e t i m - p r o v e s t h e p e r f o r ma n c e o f e xi s t i ng d ee p n e t w o r k s f r o m t h e li t e r a t u r e o n e a c h o f t h e s e t a s k s .W e a l s o s h o w t h a t R e f i n e N e t p r o du c e s a n a t o m i c a ll y m e a n i ng f u l s ub j e c t - l e v e l p a r c e ll a t i o n s w i t h h i gh e r t e m p o r a l c o h e r e n c e .
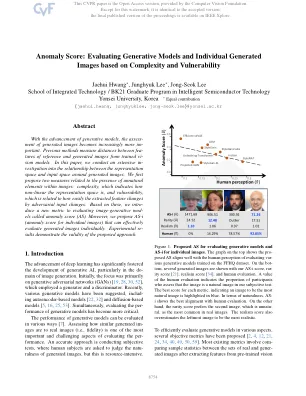
异常得分:根据复杂性和脆弱性评估生成模型和个体生成的图像
随着生成模型的发展,生成图像的评估变得越来越重要。先前的方法测量参考文献和从训练有素的VI-SION模型产生的图像之间的距离。在本文中,我们对表示图像周围的表示空间与输入空间之间的关系进行了广泛的影响。我们首先提出了与图像中不自然元素存在有关的两项措施:复杂性,这表明表示空间的非线性和脆弱性是与对抗性输入变化的轻易变化相关的脆弱性。基于这些,我们为评估称为异常评分的图像生成模式(AS)进行了新的指标。此外,我们提出了可以有效地评估生成的图像的AS-I(单个图像的异常得分)。实验性依据证明了所提出的方法的有效性。

人工智能生成内容的法律问题
除了版权之外,人工智能生成的内容还会在商标和专利等领域引发知识产权问题。商标法保护与产品或服务相关的独特标志和符号,当人工智能生成的内容包含或引用现有商标时,商标法可能会面临挑战。同样,当人工智能系统开发新技术或流程并产生人工智能生成的内容时,保护发明和技术创新的专利法可能会面临新问题。这些知识产权问题需要仔细审查,以确保公平、平衡的法律框架,在促进创新的同时保护所有利益相关者的权利。

立场文件:机器翻译应该被标记为 AI 生成的内容吗?
2023 年 9 月,加拿大政府发布了《生成式人工智能使用指南》,其中为加拿大政府机构及其员工提出了建议。与近年来各组织发布的其他类似文件一样,该文件就透明度提出了建议,指出每当使用生成式人工智能生成内容时,都应告知读者“发给他们的消息是由人工智能生成的”。虽然本指南没有专门针对机器翻译的情况,但它确实提到翻译是生成式人工智能的潜在应用。因此,自然而然地出现了一个问题:无论在哪里使用机器翻译的文本,都应明确标记为人工智能生成的内容吗?在本立场文件中,我们详细研究了这个问题,目的是提出关于机器翻译的明确指导方针,不仅针对政府机构,也针对任何使用机器翻译技术的人。我们的主要结论是,机器翻译的文本确实是 AI 生成的内容。因此,应在使用它的所有地方明确标记。我们就这种标记可能采取的形式提出建议。我们还研究了在什么条件下可以删除或省略 MT 标记。

研究表明,艺术和文化产业为德克萨斯州经济创造了 61 亿美元的收入......https://www.prnewswire.com/news-releases/arts-and-culture-industry-ge...
艺术状况报告显示,艺术对德克萨斯州至关重要,因为它可以推动经济发展、提高学业成功率、改善健康和福祉