
XiaoMi-AI文件搜索系统
World File Search SystemMini

Rosetta神经元:挖掘模型动物园中的普通单位
是否有不同的神经网络,接受过各种视觉任务的培训,共享一些共同的表示?在本文中,我们证明了我们在具有不同体系结构,不同任务(生成和歧视本地)以及不同类型的监督(班级监督,私人文本,文本监督,自学,自我求职,自我求助)的一系列模型中称为“ Rosetta神经元”的存在。我们提出了一种用于挖掘跨多种流行视觉模型的Rosetta神经元词典的算法:类监督 - Resnet50,Dino-Resnet50,Dino-Vit,Mae,Mae,Clip-Resnet50,Big-Gan,Big- Gan,stylegan-gangan-2,stylegan-xl。我们的发现表明,某些视觉概念和结构在自然世界中固有地植根于自然界,并且可以通过不同的模型来学习,而不论特定的任务或体系结构,并且不使用语义标签。,由于我们的分析中包含的生成模型,我们可以直接可视化共享概念。Rosetta神经元促进了模型对模型翻译,实现了各种基于反转的操作,包括跨级比对,变化,放大等,而无需进行专业培训。

研究提案的资金机构清单1环境与森林部印度政府秘书,环境部和工会
研究提案的资金机构清单1环境与森林部印度政府秘书,环境与森林部,Paryavaran Bhawan,Paryavaran Bhawan,CGO Complex,Lodhi Road,New Delhi 110 003电子邮件: http://www.moef.nic.in//fax:011-258586422,011-24364594。电话:011-258586422,011-24364594。2 Forests Research Institute Group Coordinator ( Research), Forest Research Institute, Post Office New Forest, Dehradun e-mail: hooda@icfre.org, groupco_fri_icfre.org web: http://www.fri.icfre.gov.in Fax: 0135 - 2756865 Tel: 0135 - 2752670 EBPAX No.2757021-26 Extn。4316 3科学技术系(DST)政府科学技术系秘书。印度技术Bhawan,新德里新梅赫拉里路。 110016电子邮件:dstinfo@nic.in web:http://www.dst.gov.in/传真:( +91)011-23016857,265673,26962819印度技术Bhawan,新德里新梅赫拉里路。110016电子邮件:dstinfo@nic.in web:http://www.dst.gov.in/传真:( +91)011-23016857,265673,26962819

环境,能源和企业部
21(e2303)公用事业86,469 95,000 128,000 22(E2306)材料和用品51,349 77,000 70,000 70,000 70,000 23(E2309)维修和维护40,547 35,000 50,000 24(E2312) (E2318)办公室服务27,744 40,000 40,000 27(E2321)运输80,81,000 100,000 28(E2324)旅行98,118 300,000 260,000 260,000 29(E2327) 138,051 155,000 155,000 32 (E2336) Training 3,270 17,000 5,000 33 (E2339) Hospitality 21,914 22,000 25,000 34 (E2342) Incidental Expenses 2,151 3,000 2,000 ____________ ____________ ____________ Total Operational and Maintenance Expenses 1,232,152 1,635,000 1,622,000 ____________ ____________ ____________

建模合作者:通过LLM工具使用
从内容节制到野生动植物保护,需要模型识别细微或主观的视觉概念的应用数量正在增长。传统上,开发用于此类概念的分类器需要在数小时,天甚至数月内衡量的大量手动努力来识别和注释培训所需的数据。即使最近提出的敏捷建模技术可以快速地进行图像分类器的快速启动,但仍需要用户花费30分钟或更多的单调,重复的数据标签,以训练一个罪恶的分类器。利用了Fiske的认知灾难理论,我们提出了一个新框架,通过用自然语言相互作用代替人类标签,从而减少了由自然语言相互作用,从而减少了通过一个数量级来定义的总体努力所需的总体努力:从将2,000张标记的图像定义为只有2,000张图像到只有100张图像到100次自然语言相互作用。我们的框架利用了大型语言模型和视觉语言模型的基础模型的最新进展,以通过对话和自动标记培训数据点来雕刻概念空间。最重要的是,我们的框架消除了对人群来源注释的需求。此外,我们的框架最终生产出在成本敏感的方案中可部署的轻量级分类模型。在15个主观概念和2个公共图像分类数据集中,我们训练的模型的表现优于传统敏捷建模以及最先进的零拍模型,例如Align,clip,cupl,Cupl和大型视觉问题回答诸如Pali-X之类的模型。
绿色预算联盟致财政部长Leblanc Re联邦对美国贸易威胁和公告的回应(2025年3月5日).docx
绿色预算联盟对预算的建议2025概述了许多战略行动,这些行动仍然是联邦投资的优先事项,在当前情况下确实更为重要。许多支持长期可持续性的措施 - 例如省外电力传播,建筑能源效率改造,自然保护,可持续的农业以及可持续工作的培训和市场发展 - 有可能创造就业机会,改善土著社区,以及加拿大农村和城市的土著社区的负担能力,并帮助加拿大出现强大的加拿大。

将水的海洋与岩浆区分开 -
轻微照射的迷你纽扣具有潜在的密度与托管大量液态水海洋(“ Hycean”行星)一致。已经提出了在大气中同时存在氨(NH 3)的存在作为这种世界的细节。JWST观察K2-18b(原型Hycean)发现了CO 2的存在,而NH 3至<100 ppm的耗竭;因此,已经推断出该星球可以容纳液态水域。相比之下,气候建模表明,包括K2-18B在内的许多迷你纽扣可能太热了,无法容纳液态水。,我们通过研究岩浆海洋对迷你北极大气化学的影响,提出了一种解决观测和气候建模之间的差异的解决方案。我们证明,大气NH 3耗竭是岩浆在还原条件下岩浆中氮种的高溶解度的自然结果。恰好是厚氢包膜与熔融行星表面通信的条件。岩浆海洋模型将K2-18b至3σ的当前JWST光谱重现,这表明这是对当前观察的可信解释,就像主持液态水海洋的星球一样。可以用来排除岩浆海洋模型的光谱区域包括>4μm区域,其中CO 2和CO特征主导:Magma Ocean模型表明,与自由化学检索相比,系统的CO 2 / CO比率低于自由化区域的估计,这表明对该光谱区域的更深入观察到,该光谱区域的更深入的观察可能能够区分液态水和Magma oni-Neptunes的海洋。
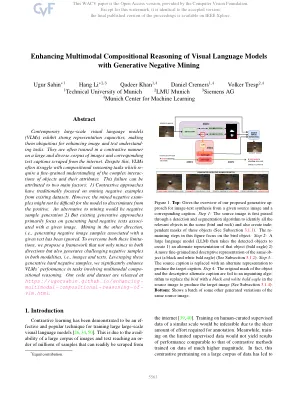
增强具有生成负面挖掘的视觉语言模型的多模式组成推理
当代的大规模视觉语言模型(VLM)具有强大的表示能力,使它们无处不在,可以增强图像和文本理解任务。他们经常以对比的方式受到大量图像和相应的文本字幕的对比方式进行训练。尽管如此,VLMS经常在构图推理任务上挣扎,这些任务对对象及其属性的复杂相互作用进行了精细的了解。此失败可以归因于两个主要因素:1)对比的方法传统上专注于从现有数据集中开采负面示例。但是,该模型可能不难区分阳性检查。替代采矿的替代方法是负样本2),但现有的生成方法主要集中于生成与给定图像相关的硬性负面文本。在另一个方向上进行挖掘,即生成与给定文本相关的负面图像样本已被忽略。为了克服这两种限制,我们提出了一个框架,不仅在两个方向上矿山,而且在这两种方式(即图像和文本)中产生了有挑战性的负面样本。利用这些生成硬性负样本,我们在涉及多模式综合推理的任务中显着提高了VLMS的性能。我们的代码和数据集在https://ugorsahin.github.io/enhancing-- vlm.html上发布。

1982 年信息法案 (OIA),所有书面建议和报告......
项目融合已证明自己是一个至关重要的实验和锻炼,使新西兰能够在可互操作的测试床中验证和证明新兴的军事能力,并与我们的盟友和跨国公司一起进行互操作性测试。通过在我们地区增加地缘政治竞争的背景下构建,这努力强调了综合和合并的军事行动的重要性(根据OIA的第6(a)条撤销)。我们感谢结果和数据的相互交流,从而加深了我们的战略联盟并增强了我们的集体防御姿势。[根据OIA的第6(a)条扣留]。我们致力于确保我们的部队通过这种参与度进行多功能,响应迅速和操作。

