
XiaoMi-AI文件搜索系统
World File Search SystemPrompt

提示了定量审查摘要的方面关键点分析
关键点分析(KPA)的目的是定量摘要,该摘要提供了关键点(KPS)作为衡量其患病率的简洁文本摘要和量子。KPA对论点和评论的研究。大多数KPA研究都采用监督的学习,将简短的句子视为KP,然后与KP匹配以审查量化KP患病率的评论。最近的抽象方法仍基于句子产生KP,通常会导致KP具有重叠和幻觉的意见,并且量化不准确。在本文中,我们提出了提示的方面关键点分析(PAKPA),以进行定量审查摘要。pakpa采用方面情感分析,并促使使用大型语言模型(LLMS)的文本学习生成和量化基于业务实体的KPS,这可以通过准确的量化来实现信仰的KP,并重新提高了对大量调查数据进行监督培训的需求。在流行评论数据集Yelp和面向方面的评论摘要数据集的步伐上进行的实验表明,我们的框架实现了最先进的性能。源代码和数据可用:https://github.com/ antangrocket1312/pakpa

FDP Gen AI和提示Engg海报
Dayananda Sagar机构由有远见的Shri R Dayananda Sagar于1960年代建立,以卓越的教育享有声誉,并获得了NAAC认证,并获得了A+等级。基于这一遗产,Dayananda Sagar University(DSU)于2014年由卡纳塔克邦州的一项法案建立,强调了高质量的教育,受到了强大的研究,创新和孵化的支持。DSU具有最先进的基础设施,其中包括400,000平方英尺的现代设施和25,000平方英尺的行业级实验室,致力于以强大的行业支持来促进企业家志向。大学提供跨学科的全面本科,研究生和博士课程,例如工程,医学,计算机应用,管理,商业,商业,法律,法律,药学,物理疗法,护理和科学,并将严格的学术课程与实践经验相结合,以确保学生在理论和应用知识>

一致性引导的及时学习视觉语言...
我们提出了一致性引导的及时学习(COPROMPT),这是一种新的视觉模型微调方法。我们的方法在几次设置的下游任务上进行了微调时,改善了大型基础模型的概括。共同启动的基本思想是在预测可训练和预训练的模型的预测中执行一致性约束,以防止在下游任务上过度适应。此外,我们将以下两个组件引入我们的同意约束中,以进一步提高性能:在两个扰动的输入上执行一致性,并结合了调谐,提示和适配器的两个主导范式。在扰动输入上执行一致性可以进一步正规化一致性约束,从而改善了概括。此外,适配器和提示的集成不仅可以增强下游任务上的性能,而且还提供了提高的输入和输出空间的调谐灵活性。这有助于在几次学习设置中更有效地适应下游任务。实验表明,在一系列评估套件上,副业的表现优于现有方法,包括基本到新颖的概括,域的概括和交叉数据库评估。在概括方面,coprompt改善了零弹药任务的最先进和11个数据集的整体谐波平均值。详细的消融研究表明了共同局限性中每个组件的有效性。我们在https://github.com/shuvenduroy/coprompt上提供代码。
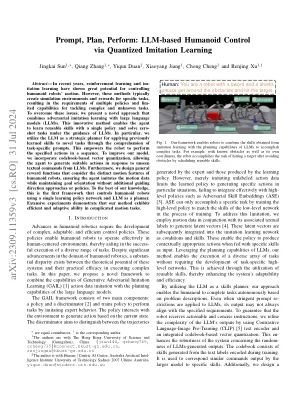
提示,计划,执行:通过量化模仿学习
摘要 - 近年来,强化学习和进化学习表现出了控制人形机器人运动的巨大潜力。但是,这些方法通常会为特定任务创建模拟环境和奖励,从而产生了多种策略和限制功能的要求,以解决复杂和未知任务。为了克服这些问题,我们提出了一种新颖的方法,将对抗性模仿学习与大语言模型(LLMS)相结合。这种创新方法使代理商可以通过单个政策学习可重复使用的技能,并在LLMS的指导下解决零拍摄任务。特别是,我们利用LLM作为战略规划师,通过理解特定于任务的提示,将先前学到的技能应用于新颖的任务。这使机器人能够以序列执行指定的动作。为了改善我们的模型,我们合并了基于代码的向量量化,使代理可以生成合适的操作,以响应LLM的看不见的文本命令。此外,我们设计了一般的奖励功能,考虑了人形机器人的独特运动特征,确保代理模仿运动数据,同时保持目标取向,而无需其他指导方向方法或策略。据我们所知,这是第一个使用单个学习策略网络和LLM作为计划者来控制人形机器人的框架。广泛的实验表明,我们的方法在复杂的运动任务中表现出有效和适应性的能力。

使用提示自动生成建模元素...
智能技术系统(ITS)的开发需要高级方法,以满足不断增长的系统复杂性和各种利益相关者要求的种类。基于模型的系统工程(MBSE)已被证明是一种有前途的开发方法,可以应对不断增长的系统复杂性和提高企业敏捷性(Friedenthal 2023)。通常,系统工程(SE)致力于开发整体解决方案和集成系统组件以满足客户需求和功能(Hitchins 2007)。se首先定义系统要求,然后设计系统元素,合成和复杂系统验证(Walden 2023)。MBSE是基于文档的SE的扩展,其中有关系统的信息在系统模型中被形式化。这种以模型为中心的方法可以为跨学科系统开发所需的一致且可追溯的系统设计(Friedenthal 2023)。系统模型有助于更深入地了解系统需求与系统新兴属性,内部结构和行为之间的联系。建模使整合易于管理的不同观点的复杂性。系统模型是在研讨会中设计的,其中随后将模型数字化,或者使用建模工具直接以数字形式进行数字化(Tschirner 2016)。正式的建模语言,例如Sysml(Delligatti 2014),用于以正式的方式捕获系统设计。
设备上的天气基础模型的联合及时学习
天气预报的设备智能使用本地深度学习模型来分析没有集中云计算的天气模型,对支持人类激活具有重要意义。联邦学习是通过在不共享原始数据的情况下进行协作模型培训来实现协作模型培训的一种有希望的解决方案。但是,它面临着妨碍其可靠性的三个主要挑战:(1)由于地理差异而导致设备之间的数据异质性; (2)单个设备中的数据同质性和(3)发送大型模型参数以进行协作而进行的通信过载。为了应对这些挑战,本文为天气模型(FEDPOD)提供了供您提供的供应的p rompt学习,该模型(FEDPOD)启动了启动的设备,以在维持沟通效率的同时获得高度定制的模型。具体而言,我们的自适应及时调整杆轻巧的提示指导冷冻基础模型产生更精确的预测,还进行了迅速的基于基于多层次的沟通,以鼓励多源知识知识效果并调节优化。此外,Dy-Namic图建模构造了提示的图形,优先考虑具有与异质性相似的数据分布的设备之间的协作培训。广泛的实验表明,FEDPOD在现实世界内部的天气预报数据集中领导着最先进的基线的性能。
学习仅使用一个正常图像提示
摘要。使用自我发明变压器的无监督重建网络已通过单个模型实现了多级(统一)异常检测的最新性能。然而,这些自我注意重建模型主要基于目标特征,这可能会导致正常和异常特征的完美重建,这是由于与上下文的高度一致性,从而导致异常发生故障。此外,由于在低空间分辨率潜在的潜在空间中进行重建,这些模型通常会产生不准确的异常分割。为了使重建模型具有高效率,同时增强其对统一异常探测的概括,我们提出了一种简单而有效的方法,可以重建正常功能并仅使用一个正常图像提示(ONENIP)恢复异常功能。与以前的工作相比,Onenip首次仅用一个正常图像提示重建或恢复异常,从而有效地增强了统一的异常检测性能。此外,我们提出了一种有监督的炼油厂,该炼油厂通过使用实际正常和合成的异常图像来回归构造错误,从而显着改善了像素级异常分割。ONENIP优于三个行业异常脱轨基准的先前方法:MVTEC,BTAD和VISA。

面向学生的 AI 使用反思提示示例
• 简短而精炼:添加注释,说明您使用了哪种 AI 工具以及如何使用它,包括您使用的提示和日期 • 以学习为重点:1) AI 在哪些方面帮助您实现了此作业/项目的学习目标?学习过程的哪些方面没有得到 AI 的帮助?解释原因 • 批判性视角:您采取了哪些步骤来确保在工作中合乎道德地使用 AI?您将来如何改进对 AI 工具的使用?• 以使用和作者为重点:在您的作品结尾处写一个简短的段落 (1),解释您如何以及为何使用 ChatGPT。包括您使用的提示,并回答这个问题:谁是这部作品的作者?然后解释您的答案。

DetToolChain:释放 MLLM 检测能力的全新提示范式
摘要。我们提出了一种新颖的提示范式 DetToolChain,以释放多模态大型语言模型 (MLLM)(例如 GPT-4V 和 Gemini)的零样本物体检测能力。我们的方法包括一个受高精度检测先验启发的检测提示工具包和一个用于实现这些提示的新思路链。具体来说,工具包中的提示旨在引导 MLLM 关注区域信息(例如放大)、根据测量标准读取坐标(例如叠加尺子和圆规)以及从上下文信息中进行推断(例如叠加场景图)。基于这些工具,新的检测思路链可以自动将任务分解为简单的子任务,诊断预测并规划渐进式框细化。我们的框架的有效性在一系列检测任务中得到了证明,尤其是在困难情况下。与现有的最先进方法相比,使用我们的 DetToolChain 的 GPT-4V 可将最先进对象检测器的 AP 50 在 MS COCO Novel 类集(用于开放词汇检测)上提高 21.5%,在 RefCOCO val 集(用于零样本指称表达理解)上提高 24.23%,在 D-cube 描述对象检测 FULL 设置上提高 14.5% AP。代码将在接受后发布。

lmpt:长尾多标签视觉识别的特定于类的嵌入损失
长尾的多标签视觉识别(LTML)任务是由于标签共发生和不平衡的数据分布,这是一项极具挑战性的任务。在这项工作中,我们为LTML提出了一个统一的框架,即促使特定于班级的嵌入损失(LMPT)进行调整,从而通过结合文本和im im Im operational数据来捕获语义功能相互作用,并在头部和尾部同步改进型号。具体来说,LMPT通过班级感知的软边距和重新投资介绍了嵌入式损失函数,以学习特定的班级上下文,并带有文本描述(字幕)的好处,这可以帮助建立类之间的语义关系,尤其是在头和尾部之间。fur-hoverore考虑到类失样的类别,分配平衡的损失被用作分类损失函数,以进一步提高尾部类别的性能而不会损害头部类别。在VOC-LT和可可-LT数据集上进行了广泛的实验,这表明我们的方法显着超过了先前的最新方法,而LTML中的零拍夹。我们的代码在https://github.com/richard-peng-xia/lmpt上完全公开。