
XiaoMi-AI文件搜索系统
World File Search SystemRepresentation

Zignerf:带有可逆生成神经辐射场
生成的神经辐射场(NERF)通过学习一组未经未介绍的图像的分布来综合多视图图像,表现出非常熟练的熟练程度。尽管现有的生成nerf具有在数据分布中生成3D一致的高质量随机样本的才能,但创建单数输入图像的3D表示仍然是一个巨大的挑战。在此手稿中,我们介绍了Zignerf,这是一种创新的模型,该模型执行零击生成的对抗网(GAN)倒置,以从单个脱离分布图像中生成多视图。该模型的基础是一个新型逆变器的基础,该逆变器映射到了发电机歧管的潜在代码中。毫无意义,Zignerf能够将对象从背景中解散并执行3D操作,例如360度旋转或深度和水平翻译。使用多个实数数据集对我们的模型的效率进行验证:猫,AFHQ,Celeba,Celeba-HQ和Compcars。

Bishopton Villages Action Group(BVAG)的书面代表
(3)BVAG对EXA规则6字母的响应 - 关于检查程序和时间表的书面提交(2024年7月),包括建议的地点进行现场检查和/或无人陪伴,并附加了其他太阳能计划的地图和桌子,该地图和桌子列出了附近地区。
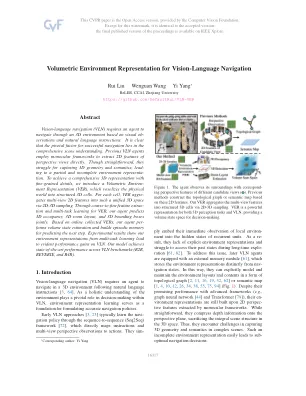
视觉导航的体积环境表示
Vision语言导航(VLN)要求代理在基于视觉观察和自然语言说明的3D环境中导航。很明显,成功导航的关键因素在于全面的场景理解。以前的VLN代理使用单眼框架直接提取透视视图的2D特征。虽然很简单,但他们为捕获3D几何和语义而努力,导致部分不完整的环境代表。为了实现具有细粒细节的全面3D表示,我们引入了体积环境(VER),将物理世界脱氧于结构化的3D细胞中。对于每个单元格,通过2D-3D采样将多视图2D特征归纳到如此统一的3D空间中。通过对VER的粗略到纤维特征进行推断和多任务学习,我们的代理人可以共同预测3D占用率,3D房间布局和3D边界框。基于在线收集的vers,我们的代理构成了体积状态估计,并构建情节内存以预测下一步。实验结果表明,我们从多任务学习的环境表示导致了VLN的可观绩效提高。我们的模型在VLN基准(R2R,Reverie和R4R)之间实现了最新的性能。
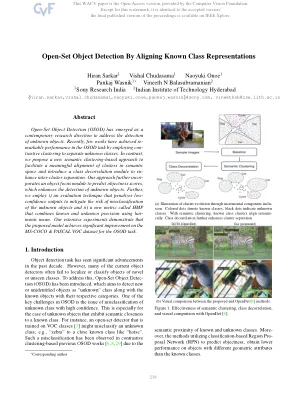
通过对齐已知类表示
开放式对象检测(OSOD)已成为当代研究方向,以解决对未知对象的检测。最近,很少有作品通过使用Con-Contrastive聚类来分开未知类,在OSOD任务中实现了可观的性能。相比之下,我们提出了一种新的基于语义聚类的方法,以促进语义空间中有意义的群集的对齐,并引入一个类去相关模块以实现群间间的分离。我们的方法进一步不适合对象焦点模块预测对象分数,从而增强了未知对象的检测。此外,我们采用了i)一种评估技术,该技术对低置信度输出进行了惩罚,以减轻对未知对象的错误分类的风险,ii)一种称为HMP的新指标,该指标使用hMP使用Har-nonic Mean结合了已知和未知的精度。我们的广泛实验表明,所提出的模型可以在OSOD任务上对MS-Coco&Pascal VOC数据集有显着改进。

从EEG脑记录中学习强大的深视觉表示
解码人脑一直是神经科学家和人工智能研究人员的标志。重新构建来自脑电脑脑电图(EEG)信号的视觉图像,由于其在脑部计算机接口中的应用,引起了人们的极大兴趣。本研究提出了一种两阶段的方法,其中第一步是获得脑电图衍生的特征,以稳健地学习深度代表,然后将学习的表示形式用于图像产生和分类。我们使用具有监督和对比度学习方法的深度学习体系结构在三个不同的数据集中进行了特征提取管道的普遍性。我们已经执行了零摄影的脑电图分类任务,以进一步支持概括性索赔。我们观察到,与脑电图和图像之间的联合代表学习相比,在单峰设置中仅使用脑电图数据来学习一个单独使用脑电图数据的近距离线性分离的视觉表示。最后,我们提出了一个新颖的框架,将看不见的图像转换为脑电图空间,并以近似值重建它们,从而展示了来自EEG信号的图像重建潜力。我们提出的来自EEG的图像合成方法显示了62。9%和36。EEGCVPR40和ThoughtViz数据集的成立得分提高了13%,这比GAN 1中的最先进的表现效果。EEGCVPR40和ThoughtViz数据集的成立得分提高了13%,这比GAN 1中的最先进的表现效果。

使用4D隐式神经表示
构建准确的地图是构成可靠的局部设备,计划和导航的关键构建块。我们提出了一种新的方法,可以利用LiDAR扫描来建立动态环境的准确地图。为此,我们建议将4D场景编码为新的时空隐式神经图表示,通过将时间依赖性的截断符号距离函数拟合到每个点。使用我们的代表,我们通过填充动态零件来提取静态图。我们的神经表示基于稀疏特征网格,一种全球共享的解码器和时间依赖性的BAIS函数,我们以无监督的方式共同优化。要从一系列li-dar扫描学习此表示形式,我们设计了一个简单而有效的损耗函数,以分段方式监督地图优化。我们在包含静态图的重建质量和动态点云的分割的各种场景上评估了我们的方法1。实验结果表明,我们的方法是删除输入点云的动态部分的过程,同时重建准确而完整的3D地图,以超出几种最新方法。

人机交互中的用户表征
摘要 光标、头像、虚拟手或工具以及其他渲染的图形对象使用户能够与 PC、游戏机或虚拟现实系统等计算机进行交互。我们从用户的角度在“用户表征”的统一概念下分析这些不同对象的作用。这些表征是虚拟对象,它们人为地延伸了用户的身体,使他们能够通过执行不断映射到其用户表征的运动动作来操纵虚拟环境。在本文中,我们确定了一组与不同用户表征相关的概念,并对用户表征的控制和主观体验背后的多感官和认知因素进行了多学科回顾。这些概念包括视觉外观、多模态反馈、主动感、输入法、近体空间、视觉视角和身体所有权。我们进一步为这些概念提出了研究议程,这可以引导人机交互社区从更广泛的视角了解用户如何通过他们的用户表征进行感知和交互。

第 7 课:数据表示和存储
文件格式对于数据兼容性和质量至关重要,因为它们决定了数据在文件中的编码、压缩和结构。选择合适的文件格式可确保与不同的软件应用程序、操作系统和设备兼容,让用户无缝共享、分发和访问数字内容。此外,文件格式会影响内容的质量和保真度,影响图像分辨率、音频清晰度和视频播放流畅度等因素。了解常见的数字文件格式及其特性有助于用户在创建、共享和使用数字内容时做出明智的决定。
用于数据特征选择和压缩特征表示的量子算法
量子计算已成为一个新兴领域,可能彻底改变信息处理和计算能力的格局,尽管物理上构建量子硬件已被证明是困难的,而且当前嘈杂中型量子 (NISQ) 时代的量子计算机容易出错且其包含的量子比特数量有限。量子机器学习是量子算法研究中的一个子领域,它对 NISQ 时代具有潜力,近年来其活动日益增多,研究人员将传统机器学习的方法应用于量子计算算法,并探索两者之间的相互作用。这篇硕士论文研究了量子计算机的特征选择和自动编码算法。我们对现有技术的回顾使我们专注于解决三个子问题:A) 量子退火器上的嵌入式特征选择,B) 短深度量子自动编码器电路,以及 C) 量子分类器电路的嵌入式压缩特征表示。对于问题 A,我们通过将岭回归转换为量子退火器固有的二次无约束二元优化 (QUBO) 问题形式并在模拟后端对其进行求解来演示一个工作示例。对于问题 B,我们开发了一种新型量子卷积自动编码器架构,并成功运行模拟实验来研究其性能。对于问题 C,我们根据现有技术的理论考虑选择了一种分类器量子电路设计,并与相同分类任务的经典基准方法并行进行实验研究,然后展示一种将压缩特征表示嵌入到该量子电路中的方法。
基于空间表征语义层次的机器人探索与绘图策略
许多科学家 [Lynch,1960;Piaget 和 Inhelder,1967;Siegel 和 White,1975] 已经观察到认知地图被组织成连续的层,并提出对大规模环境的有用且有力的描述的核心要素是拓扑描述。分层模型包括从局部感官信息中识别和辨认地标和地点;路线控制知识(从一个地方到另一个地方的过程);连通性、顺序和包含的拓扑模型;以及形状、距离、方向、方位以及局部和全局坐标系的度量描述。看来,认知地图的分层结构是人类在大规模空间中稳健表现的原因。我们的方法试图将这些方法应用于机器人探索和地图学习问题。我们定性方法中对环境的核心描述是拓扑模型,如 TOUR 模型 [Kuipers,1978]。该模型由一组节点和弧组成,其中节点代表环境中可识别的位置,弧代表连接它们的行进路径。节点和弧是根据机器人的感觉运动控制能力程序性定义的。度量信息添加到拓扑模型之上。