
XiaoMi-AI文件搜索系统
World File Search SystemSynthe

与潜在抗氧化剂和抗
摘要 - 在高等教育中,培养鼓励学生参与现实世界挑战的环境对于专业发展至关重要。这一原则为我们与第八学期纳米技术工程专业学生的合作努力支撑。通过创新的方法,例如合成结合菠萝果皮的聚合物纤维,我们解决了环境问题并利用菠萝废物的未开发潜力。菠萝行业每年产生大量的非利用废物,主要是茎,牙冠和果皮,占整个水果的67%。菠萝果皮富含生物活性化合物(如多酚)对化妆品行业的应用有望,如果将它们纳入合适的输送系统中,则可能会增强产品(例如提拉配方)。在目前的工作中,使用商业挤出机合成了装有10%,20%和30%菠萝果皮粉(PP)的聚乳酸(PLA)和多碳酸酯(PCL)纤维。傅立叶变换红外和差异扫描量热法证实了由于形成了新的化学键和相互作用的有效PP掺入纤维中。使用扫描电子显微镜(SEM)进行的形态表征表明,纤维的横截面长度从3.7μm到90.19μm。高性能液相色谱和叶核方法评估了酚类化合物含量和释放速率。PLA纤维具有20%的PP,显示出酚类化合物的最大保留率,为1243.69±234.14 µg化合物/ g纤维),而PCL纤维在24小时内显示出迅速释放,高达95.79±5.94%。这些结果表明,商业挤出机可以在化妆工业中可能使用的聚合物微纤维作为菠萝果皮中酚类化合物的递送系统的可行性。
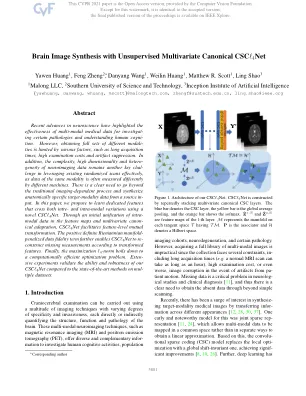
大脑图像合成,无监督的多元规范CSCL4NET
神经科学的最新进展强调了多模式医学数据在研究某些病理和了解人类认知方面的有效性。但是,获得一组不同的模态的完整集受到各种因素的限制,例如长期获取时间,高检查成本和伪影抑制。此外,神经影像数据的复杂性,高维度和异源性仍然是有效地利用现有随机扫描的另一个关键挑战,因为不同机器通常对相同方式的数据进行了不同的测量。显然需要超越传统成像依赖性过程,并从源中综合解剖学特定的目标模式数据。在本文中,我们建议学习使用新型CSCℓ4NET跨内部和模式内变化的专用特征。通过特征图和多元典范适应性中的模态数据的初始统一,CSCℓ4净4净促进了特征级别的相互转换。正定的riemannian歧管 - 惩罚数据限制项进一步使CSCℓ4NET可以根据变换的特征重新构建缺失测量值。最后,最大化ℓ4 -norm沸腾到计算上有效的优化问题。具有较大的实验可以验证我们的CSCℓ4NET的能力和鲁棒性与Multiple数据集中的最新方法相比。

Lee,B。H.,Shin,H.,Rasouli,A。S.,Choubisa,H.,Ou,P.,Dorakhan,R。,...&Sargent,E。H.(2023)。支撑的金属邻thal的超分子调整 朝着bory的合成(氨基甲基... ROS如何诱导Netosis?氧化DNA损伤,DNA修复和染色质脱凝 使用斑马鱼研究多外观跳过作为的潜在疗法 啮齿动物的心肌病和心力衰竭的啮齿动物模型,用于翻译研究和治疗发现
1.3 T HIS W ORK ................................................................................................................................................ 21


使用编码器-解码器框架从颅内深度电极合成语音
图 6 示例性注意力矩阵,可视化三位参与者在收敛时的注意力得分(来自随机选择的训练样本)(值越亮表示注意力得分越高)。解码器中的时间步长在 y 轴上表示,编码器的时间步长在 x 轴上表示。对角线结构表明注意力得分在时间域上是很好地对齐的,例如输出中的后续步骤关注输入中的后续步骤。该图还表明,填充输入 sEEG 序列(语音规划和理解)可能是不必要的,因为没有太多注意力放在第一个和最后一个输入步骤上。

LiDAR4D:用于新型时空视图 LiDAR 合成的动态神经场
尽管神经辐射场 (NeRF) 在图像新视图合成 (NVS) 方面取得了成功,但 LiDAR NVS 仍然基本上未被探索。以前的 LiDAR NVS 方法采用了与图像 NVS 方法的简单转变,同时忽略了 LiDAR 点云的动态特性和大规模重建问题。鉴于此,我们提出了 LiDAR4D,这是一个可微分的 LiDAR 专用框架,用于新颖的时空 LiDAR 视图合成。考虑到稀疏性和大规模特性,我们设计了一种结合多平面和网格特征的 4D 混合表示,以由粗到细的方式实现有效重建。此外,我们引入了从点云衍生的几何约束来提高时间一致性。对于 LiDAR 点云的真实合成,我们结合了光线丢弃概率的全局优化来保留跨区域模式。在 KITTI-360 和 NuScenes 数据集上进行的大量实验证明了我们的方法在实现几何感知和时间一致的动态重建方面具有优越性。代码可在 https://github.com/ispc-lab/LiDAR4D 获得。

gen-ze:燃料电池发生器最终可行性报告
这不是因为我们已经用完了数据,否则我们已经用完了所有互联网!我们的问题通常不是数量,而是相关的。合成数据还可以消除通常与现实数据相关的风险,例如偏见或隐私问题。由于缩放问题,我们还创建了合成数据。我们可能希望对天气事件进行建模,并且极端天气记录可能不足以在现实世界数据集中表示整体的百分比。同样适用于用于医学分析的建模系统。,当稀有疾病特别稀疏(占普通人群的一部分)时,可能很难为稀有疾病建模。理想的数据有效地被绝大多数人淹没了。偏见是AI建模的另一个问题,特别是算法偏差。这是数据可能反映历史不平等现象或文化偏见的地方,并散布了抽样错误。使用综合数据,我们可以公平地重新平衡数据集 - 当然,我们可以正确地做到这一点。我们还创建了有隐私问题的合成数据集,例如数据可能具有个人身份特征。匿名数据可以是

与情节的热带美洲中树生物多样性的合成...
自2022年以来由生物多样性中心资助,该项目是通过四个面对面的研讨会开发的,还有其他三个在线会议,参与者共同努力在实现上述目标所需的特定工作流程上合作:S:1-数据库协调; 2-树多样性的模式; 3-树木多样性的驱动因素;和4-树木脆弱性对于气候变化情景(作为新热带生物多样性保护的原始工作的一部分)。

证据综合报告第一部分:碳信用额
2. 传达活动气候相关绩效的工具:这些工具用于确定活动(例如特定商品的生产或加工)的排放概况。排放概况可以直接通过活动的排放强度确定,也可以通过传达有助于确定活动排放概况的属性间接确定。这可能包括商品是否使用零碳技术生产,或者来自不会导致森林砍伐和/或转化的活动或地区。根据颁发证书的活动类型,这些工具可分为以下非详尽类别:能源证书(例如可再生能源证书、可再生气体证书、可持续航空燃料证书和绿色氢证书)和商品证书(认证和传达有关不同商品生产过程的可持续性信息的工具,例如绿色钢铁)。呼吁提供有关 EAC 在企业气候目标中有效性的证据

布局 - 敏捷场景文本图像综合与扩散模型
虽然扩散模型已显着提高了图像生成的质量,但它们在这些图像中准确且相干渲染文本的能力仍然是一个重大挑战。场景文本生成的常规基于扩散的方法通常受到对中间布局输出的依赖的限制。这种依赖性通常会导致文本样式和字体的多样性限制,这是布局生成阶段的确定性质所引起的固有限制。为了应对这些挑战,本文介绍了SceneTeTgen,这是一种基于新颖的扩散模型,专门设计用于规避预定义布局阶段的需求。这样做,场景 - 文本促进了文本的更自然和多样化的代表。SceneTextGen的新颖性在于其三个关键组成部分的整体:一个字符级编码器,用于捕获详细的印刷属性,并与字符级实例分割模型和Word-