
XiaoMi-AI文件搜索系统
World File Search SystemVF

量子多模型拟合 - CVF 开放获取
几何模型拟合是一个具有挑战性但又十分基础的计算机视觉问题。最近,量子优化已被证明可以增强单模型情况的稳健拟合,同时多模型拟合的问题仍未得到解决。为了应对这一挑战,本文表明后一种情况可以从量子硬件中显著受益,并提出了第一种多模型拟合 (MMF) 的量子方法。我们将 MMF 表述为一个问题,现代绝热量子计算机可以对其进行有效采样,而无需放宽目标函数。我们还提出了一种迭代和分解版本的方法,该方法支持真实世界大小的问题。实验评估在各种数据集上都显示出有希望的结果。源代码可在以下位置获得:https://github.com/FarinaMatteo/qmmf 。
古存者的眼睛Ex Machina -CVF Open Access
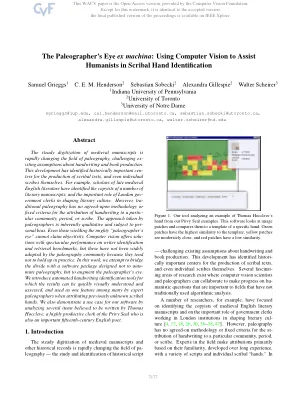
中世纪手稿的稳定数字化正在迅速改变古编目的领域,这挑战了关于手写和书籍生产的假设。这一发展已经确定了历史上重要的文字文本,甚至个人抄写本身。例如,已故中世纪英语文学的学者确定了许多文学手稿的抄写者,以及伦敦政府秘书在塑造文学文化中的重要作用。然而,传统的古学尚无协议的方法或固定标准,可以将手写归因于特定社区,时期或抄写员。古存者采用的方法本质上是定性的,并且存在着人的偏见。即使是那些挥舞着强大的“古征象者”的人也无法声称客观性。计算机视觉提供了在作者识别和检索基准方面具有出色表现的解决方案,但是古老社区并未广泛采用这些方法,因为它们往往不会在实践中坚持下去。在这项工作中,我们试图用旨在自动化古征学的软件包桥接鸿沟,而是要增强古造型者的眼睛。我们介绍了自动手写识别工具,可以在视觉上快速理解和评估结果,并在归因于以前未知的抄写员时,将其用作众多专家的一项功能。我们还通过分析托马斯·霍克夫夫(Thomas Hoccleve)撰写的几个物品(私人印章的高产店员),也是一个重要的十五世纪英语诗人,我们还为我们的软件展示了一个用例。
基于事件流的视觉对象跟踪-CVF打开访问
以生物风格的活动相机跟踪近年来引起了人们的兴趣。现有的作品要么利用对齐的RGB和事件数据进行准确跟踪,要么直接学习基于事件的跟踪器。前者会产生较高的推理成本,而后者可能容易受到嘈杂事件或稀疏空间分辨率的影响。在本文中,我们提出了一个新型的分层知识蒸馏框架,该框架可以在培训期间完全利用多模式 /多视图信息,以促进知识转移,使我们能够仅使用事件信号来实现测试过程中高速和低潜伏期视觉跟踪。特别是,基于教师变压器的多模态跟踪框架首先是通过同时喂食RGB框架和事件流来训练的。然后,我们设计了一种新的分层知识蒸馏策略,其中包括成对相似性,功能表示和基于响应地图的知识蒸馏,以指导学生变形金刚网络的学习。在术语中,由于现有的基于事件的跟踪数据集都是低分辨率(346×260),因此我们提出了名为EventVot的第一个大规模高分辨率(1280×720)数据集。它包含1141个视频,并涵盖了许多类别,例如行人,车辆,无人机,乒乓球等。对低分辨率(Fe240Hz,Vi-Sevent,Coesot)和我们新提出的高分辨率EventVot数据集的进行了实验进行了实验
节能自适应3D传感-CVF开放访问
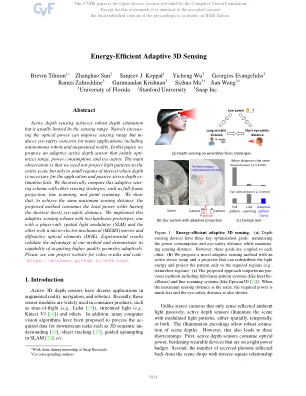
主动深度传感可实现强大的深度估计,但通常受感应范围的限制。天真地增加光学能力可以改善传感范围,但对许多应用(包括自主机器人和增强现实)的视力安全关注。在本文中,我们提出了一个自适应的主动深度传感器,该传感器可以共同介绍范围,功耗和眼部安全。主要观察结果是,我们不需要将光模式投影到整个场景,而只需要在关注的小区域中,在应用程序和被动立体声深度所需的深度失败的情况下。理论上将这种自适应感知方案与其他感应策略(例如全帧投影,线扫描和点扫描)进行了比较。我们表明,为了达到相同的最大感应距离,提出的方法在最短(最佳)眼部安全距离时会消耗最小的功率。我们用两个硬件原型实现了这种自适应感测方案,一个具有仅相位空间光调制器(SLM),另一个带有微电动机械(MEMS)镜像和衍射光学元素(DOE)。实验结果验证了我们方法的优势,并证明了其能力自适应地获得更高质量的几何形状。请参阅我们的项目网站以获取视频结果和代码:

基于事件的结构 - 轨道 - CVF Open Access
事件传感器提供高时间分辨率的视觉感应,这使其非常适合感知快速视觉效果,而不会遭受运动模糊的困扰。机器人技术和基于视觉的导航中的某些应用需要3D感知在静态相机前进行圆形或旋转的物体,例如恢复对象的速度和形状。设置等于用轨道摄像头观察静态对象。在本文中,我们提出了基于事件的结构 - 轨道(ESFO),其目的是同时重建从静态事件摄像头观察到的快速旋转对象的3D结构,并恢复相机的等效轨道运动。我们的贡献是三重的:由于最新的事件特征跟踪器无法处理由于旋转运动而导致的定期自我遮挡,因此我们根据时空聚类和数据关联开发了一种新颖的事件特征跟踪器,可以更好地跟踪事件数据中有效特征的螺旋螺旋传播。然后将特征轨道馈送到我们的新颖因素基于图形的结构后端端,该结构从后端进行计算轨道运动插曲(例如自旋速率,相对旋转轴),从而最大程度地减少了重新投影误差。进行评估,我们在旋转运动下生成了一个新事件数据集。比较与地面真理表示ESFO的功效。

触觉增强的辐射场 - CVF Open Access
我们提出了一个场景表示形式,我们称之为触觉的辐射场(TARF),它将视觉和触摸带入共享的3D空间。此表示形式可用于估计场景中给定3D位置的视觉和触觉信号。我们从一系列照片和稀疏采样触摸探针中捕获了场景的tarf。我们的方法利用了两个见解:(i)基于常见的触摸传感器建立在普通摄像机上,因此可以使用多视图几何形状中的方法对图像进行注册,并且(ii)在视觉和结构上相似的场景区域具有相同的触觉效果。我们使用这些见解将触摸信号注册到捕获的视觉场景中,并训练有条件的扩散模型,该模型带有从神经辐射场呈现的RGB-D图像,生成其相应的触觉信号。为了评估我们的方法,我们收集了一个TARF的数据集。此数据集比预先持有的现实世界数据集包含更多的触摸样本,并且为每个捕获的触摸信号提供了空间对齐的视觉信号。我们揭示了跨模式生成模型的准确性以及在下游任务上捕获的视觉效果数据的实用性。项目页面:https:// dou- yiming.github.io/tarf。

NAVFAC 开放环境修复资源 (OER2):确定 MEC/MPPEH 水下埋藏深度的方法军用弹药被发现在某些水下位置,这是历史处置活动以及实弹训练、测试和其他操作的结果。在水下环境中仍能发挥作用的射弹和其他弹药构成爆炸危险,可能会迁移,使人员接触到这些弹药。这种爆炸危险的管理很复杂,取决于特定地点的考虑因素,例如弹药类型、海洋环境、移动潜力以及人员如何接触和与弹药互动。本次网络研讨会的目的是总结为了解水下环境中弹药的移动性和埋藏而开发的科学。将介绍环境观测、弹药观测技术、移动性和埋藏现场观测、移动与埋藏的物理学以及埋藏的物理过程建模。演示将以将这些知识在现有场地的实际应用结束。 演讲者:Bryan Harre,NAVFAC EXWC 和 Joe Calantoni,美国 NRL 博士 日期:2022 年 11 月 9 日,星期三 时间:太平洋时间上午 11 点 | 美国东部时间下午 2 点 通过以下链接注册参加网络研讨会:https://einvitations.afit.edu/inv/anim.cfm?i=697664&k=0468450F7D53 如果您无法点击链接,请将地址复制并粘贴到您的网络浏览器中。 州际技术与监管委员会 (ITRC) 关于可持续弹性修复 (SRR) 的网络研讨会 极端天气事件会对修复措施保护人类健康和环境的能力产生不利影响。可持续弹性修复 (SRR) 被定义为“清理和再利用危险废物场地的优化解决方案,可限制负面影响、最大化社会和经济效益并增强对日益增加的威胁的抵御能力”。该网络研讨会介绍了一些工具,可帮助将可持续和有弹性的实践融入修复项目中。主题:可持续的弹性修复演讲者:ITRC 日期:2022 年 11 月 17 日时间:太平洋时间上午 10 点 | 美国东部时间下午 1 点通过以下链接注册参加 ITRC 网络研讨会:https://clu-in.org/conf/itrc/SRR/有关更多信息,请查看 ITRC 关于此主题的报告:https://srr-1.itrcweb.org/ RPM 培训活动主题的最后一次征集 RPM 培训主题的最后一次征集:现在到 2022 年 11 月 16 日链接:https://einvitations.afit.edu/inv/anim.cfm?i=699708&k=04684B0E7B5F RPM 培训日期更新:2023 年 3 月 14 日至 16 日*这与原始/预计日期不同* 正在评估场地,活动举办批准将决定最终日期和地点。
NAVFAC 开放环境修复资源 (OER2):确定 MEC/MPPEH 水下埋藏深度的方法军用弹药被发现在某些水下位置,这是历史处置活动以及实弹训练、测试和其他操作的结果。在水下环境中仍能发挥作用的射弹和其他弹药构成爆炸危险,可能会迁移,使人员接触到这些弹药。这种爆炸危险的管理很复杂,取决于特定地点的考虑因素,例如弹药类型、海洋环境、移动潜力以及人员如何接触和与弹药互动。本次网络研讨会的目的是总结为了解水下环境中弹药的移动性和埋藏而开发的科学。将介绍环境观测、弹药观测技术、移动性和埋藏现场观测、移动与埋藏的物理学以及埋藏的物理过程建模。演示将以将这些知识在现有场地的实际应用结束。 演讲者:Bryan Harre,NAVFAC EXWC 和 Joe Calantoni,美国 NRL 博士 日期:2022 年 11 月 9 日,星期三 时间:太平洋时间上午 11 点 | 美国东部时间下午 2 点 通过以下链接注册参加网络研讨会:https://einvitations.afit.edu/inv/anim.cfm?i=697664&k=0468450F7D53 如果您无法点击链接,请将地址复制并粘贴到您的网络浏览器中。 州际技术与监管委员会 (ITRC) 关于可持续弹性修复 (SRR) 的网络研讨会 极端天气事件会对修复措施保护人类健康和环境的能力产生不利影响。可持续弹性修复 (SRR) 被定义为“清理和再利用危险废物场地的优化解决方案,可限制负面影响、最大化社会和经济效益并增强对日益增加的威胁的抵御能力”。该网络研讨会介绍了一些工具,可帮助将可持续和有弹性的实践融入修复项目中。主题:可持续的弹性修复演讲者:ITRC 日期:2022 年 11 月 17 日时间:太平洋时间上午 10 点 | 美国东部时间下午 1 点通过以下链接注册参加 ITRC 网络研讨会:https://clu-in.org/conf/itrc/SRR/有关更多信息,请查看 ITRC 关于此主题的报告:https://srr-1.itrcweb.org/ RPM 培训活动主题的最后一次征集 RPM 培训主题的最后一次征集:现在到 2022 年 11 月 16 日链接:https://einvitations.afit.edu/inv/anim.cfm?i=699708&k=04684B0E7B5F RPM 培训日期更新:2023 年 3 月 14 日至 16 日*这与原始/预计日期不同* 正在评估场地,活动举办批准将决定最终日期和地点。

生成量子颜色成像-CVF开放访问
单光摄像机的惊人发展为科学和工业成像创造了前所未有的机会。但是,这些1位传感器通过这些1位传感器进行的高数据吞吐量为低功率应用创造了重要的瓶颈。在本文中,我们探讨了从单光摄像机的单个二进制框架生成颜色图像的可能性。显然,由于暴露程度的差异,我们发现这个问题对于标准色素化方法特别困难。我们论文的核心创新是在神经普通微分方程(神经ode)下构建的暴露合成模型,它使我们能够从单个观察中产生持续的暴露量。这种创新可确保在Col-Orizers进行的二进制图像中保持一致的曝光,从而显着增强了着色。我们演示了该方法在单图像和爆发着色中的应用,并显示出优于基准的生成性能。项目网站可以在https://vishal-s-p.github.io/projects/ 2023/generative_quanta_color.html

无培训预处理的模型合并-CVF Open Access
最近,模型合并技术已浮出水面,作为将多个单元模型组合为单个多泰模型组合的解决方案。但是,该领域的先前努力需要进行其他培训或细调过程,或者要求模型具有相同的预先训练的初始化。在这项工作中,我们在W.R.T.先前的工作中确定了一个缺点。单位相似性在重量空间和激活空间中的不一致性。为了解决这种不一致,我们提出了一个创新的模型合并框架,该模型是在双空间约束(MUDSC)下合并的。具体而言,我们主张探索位于双重空间中统一高相似性的区域中的置换矩阵,而不是仅仅使单个空间的目标最大化,这是通过激活和重量相似性矩阵的线性组合实现的。为了提高可用性,我们还对群体结构进行了对企业的适应,包括多头关注和群体标准化。全面的实验比较表明,MUDSC可以很明显地提高具有各种任务组合和体系结构的合并模型的性能。此外,多任务损失景观中合并模型的可视化表明,MUDSC使合并的模型能够驻留在重叠段中,其中每个任务都有统一的较低损失。我们的代码可在https://github.com/zju-vipa/training_free_model_merging上公开获取。

截至 2023 年 1 月 24 日的海军西北司令部工作量预测
项目、设计和施工工具列表旨在提高您对 NAVFAC PACIFIC 机会的认识。如果您对列出的任何项目感兴趣,请访问 www.SAM.gov。位置可能不反映项目的实际物理位置。在发布项目概要后确认项目位置。对于设计代理,IH =