
XiaoMi-AI文件搜索系统
World File Search Systemgme
在伪装实例分段中揭示隐藏上下文
摘要。预测隐藏在com-plex上下文中的对象的实例级掩码是伪装实例分割(CIS)的目标,这一任务因伪装的obs obsptss and Anckatiks之间的惊人相似之处而复杂。伪装观察的各种外观,包括不同的角度,部分可见性和模棱两可的信息,进一步加剧了这一挑战。先前的作品考虑在高不确定性区域内clasifulsiful sifialpixels,而无需考虑其文本语义,从而导致许多假阳性。我们提出了一种称为Mask2Camouflage的新颖方法,该方法同时增强了上下文特征的建模,并完善了实例级别的预测地图。mask2Camouflage利用多尺度功能集成了骨干线中提取的功能。然后,引入了全局细化的交叉注意模块(GCA),以补充前景面罩和背景掩盖,以减少假阳性。fur-hoverore,通过模拟全球换档聚类过程,我们介绍了全球偏移的多头自我注意力(GSA),该过程使对象查询不仅可以从早期功能中捕获信息,还可以从结构性概念中捕获信息,从而降低与评估的数据验证的掩体对象检测任务中的类内部问题。与15种最先进的方法相比,我们的Mask2Camouflage显着提高了伪装实例细分的性能。我们的代码可在https://github.com/underlmao/mask2camouflage上找到。

互相抓挠:通过类别意识群体自我支持学习
尽管磁共振成像(MRI)对脑肿瘤分割和发现非常有帮助,但它在临床实践中缺乏某些方式。作为一种态度,预测绩效的退化是不可避免的。根据当前的实现,在模态特征的训练过程中,不同的模式被认为是独立的,彼此之间是独立的,但是它们是互补的。在本文中,考虑到不同方式对各种肿瘤区域的敏感性,我们提出了一种意识到类别的G组大量学习框架(称为GSS),以弥补本性模态模态提取阶段的信息。确切地说,在每个预测类别中,所有模态的预测构成了一个组,其中选择了最出色的灵敏度的预测作为组领导者。小组领导者与成员之间的合作努力以高的一致性和确定性为基础。作为我们的次要贡献,我们引入了一个随机面具,以减少可能的偏见。GSS采用标准培训策略而无需具体的建筑选择,因此可以轻松地插入现有的全模式内脑肿瘤分段中。在BRATS2020,BRATS2018和BRATS2015数据集上进行了明显的,广泛的实验表明,GSS可以平均证明现有的SOTA算法的性能平均为1.27-3.20%。该代码在https://github.com/qysgithubopen/gss上发布。
用黄体和富马酸亚铁补充黄河鲤鱼饮食:生长性能,消化酶活性,皮肤色素沉着和肠道菌群
在这项研究中,研究了叶黄素和富马酸亚铁对黄河鲤鱼(Cyprinus carpio)的影响,旨在评估皮肤色素沉着,肠道消化酶,肠道微生物多样性和生长性能。设计了三种实验饮食,包括对照组,一组150mg/kg叶黄素)以及叶黄素和富马酸铁蛋白酶混合物(150mg/kg叶黄素和100mg/kg富马酸铁酸铁酸铁酸酯)。用实验饮食喂食42天的鲤鱼(n = 135; 25.0±2.0g)。结果表明,与对照组相比,与对照组(P <0.05相比,与蓝色(b*),颜色差异(δe)和Chroma(δe)和乳头较高的值相比,蛋白质的无关指数(ISI)和内脏指数(ISI)和内脏指数(VSI)增加,伴随着蓝色(B*),色差(δe)和Chroma(CH*)的较高价值(与对照组相比(P <0.05)相比,身体颜色的显着变化。同时,在混合物组中观察到淀粉酶,脂肪酶和胰蛋白酶的较高活性(p <0.05)。高通量测序和维恩图表明,叶黄酸或亚铁富马酸盐对鲤鱼的肠道微生物群具有明显的影响。与对照组相比,与混合物组相比,用混合物组的鲤鱼中的静脉细菌和黄杆菌的丰度显着增加。总而言之,在饲料中添加叶黄素和富马酸亚铁可以改变黄河鲤鱼的皮肤色素沉着和肠道微生物组成,从而增强鱼类的着色效果和消化功能。这些发现为优化饲料配方和水产养殖管理提供了宝贵的见解,这可以有助于提高黄河鲤鱼的质量和农业效率。

机器学习Clifford不变的Ade Coxeter元素
摘要。胸肌分割是乳腺磁共振成像(MRI)的各种计算机辅助应用中的关键步骤。由于胸部和乳房区域之间的伪影和同质性,胸肌边界估计并不是一项琐碎的任务。在本文中,提出了一种基于深度学习的全自动分割方法,以准确描述轴向乳房MR图像中的胸肌边界。提出的方法涉及两个主要步骤:胸肌分割和边界估计。对于胸肌分割,基于U-NET结构的模型用于从输入图像中分离胸肌。接下来,通过候选点检测和轮廓分割来估计胸肌边界。使用两个Real-World数据集,我们自己的私人数据集和一个公开可用的数据集对所提出的方法进行了定量评估。第一个数据集包括12名患者乳房MR图像,第二个数据集由80名患者乳房MR图像组成。所提出的方法在第一个数据集中达到了95%的骰子得分,第二个数据集的骰子得分为89%。在大规模定量乳房MR图像上评估该方法的高分割性能表达了其在将来的乳腺癌临床应用中的潜在适用性。

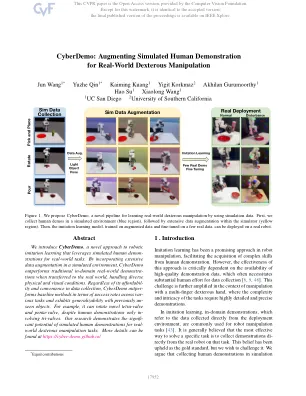
Cyberdemo:增强现实世界灵巧操纵的模拟人类示范
我们介绍了Cyberdemo,这是一种用于机器人模仿学习的新方法,该方法利用了模拟人类的策略来实现现实世界的任务。通过在模拟环境中纳入广泛的数据增强,CyberDemo在转移到现实世界中的传统现实世界中的表现优于传统的现实世界中的演示,从而处理了多样化的物理和视觉条件。无论其负担能力和在数据收集中的便利性如何,Cyberdemo Opper-pers-pers-pers-pers of-lip-term-term of基线方法在跨不同任务的成功率方面,并具有以前未见的对象的普遍性。例如,尽管只有人类的示范插入三瓣,但它仍可以旋转新型的四阀和五角谷。我们的研究证明了模拟人类示范对现实世界灵活操纵任务的重要潜力。更多详细信息可以在https://cyber-demo.github.io/
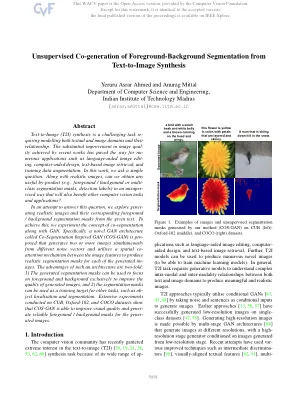
从文本到图像综合的前景 - 背景分割的无监督共同生成
文本对图像(T2I)合成是一项艰巨的任务,该任务是对文本和图像域及其关系进行建模。最近作品实现的图像质量的实质性改进为Nuberon应用程序铺平了道路,例如语言辅助图像编辑,计算机辅助设计,基于文本的图像检索和培训数据增强。在这项工作中,我们提出了一个简单的问题:与逼真的图像一起,我们是否可以以一种不受影响的方式获得任何有用的副产品(例如前景 /背景或多类分割掩码,检测标签,检测标签),这也将使其他计算机视觉任务任务和应用受益?试图回答这个问题,我们探索了从给定文本中的逼真的图像及其相应的前景 /背景分割掩码。为了实现这一目标,我们与GAN一起实验了共进行分割的概念。具体而言,提出了一种名为“共裂”启发的GAN(COS-GAN)的新型GAN结构,该结构同时从不同的噪声矢量中同时生成两个或多个图像,并利用图像特征之间的空间关注机制来生成逼真的分段掩码,以生成生成的Im-Im-Im-Im-Im-Im-Im-Im-Im-Im-Im-Agens。这种架构的优点是两倍:1)生成的分割掩码可用于专注于前景和背景,以改善生成的图像的质量,2)分段蒙版可以用作其他任务的训练目标,例如访问本地化和分割。在CUB,Oxford-102和可可数据集上进行的广泛实验表明,Cos-Gan能够改善视觉质量,并为发电图像提供可靠的前景 /背景掩码。

用原始特征重新思考知识蒸馏
用于半分割的大多数现有知识蒸馏方法着重于从原始特征中提取各种复杂知识。但是,这种知识通常是手动设计的,并且像传统功能工程一样依赖于先前的知识。在本文中,我们旨在提出一种使用RAW功能的简单有效的功能蒸馏方法。为此,我们重新审视了功能蒸馏中的开创性工作,Fitnets可以将平方误差(MSE)损失(MSE)损失最小化。我们的实验表明,在某些情况下,这种幼稚的方法可以产生良好的结果,甚至超过了一些精心设计的方法。但是,它需要仔细调整蒸馏损失的重量。通过将fitnets的损失函数分解为差异项和角度差项,我们发现角度差异项的重量受教师特征和学生特征的幅度的影响。我们通过实验表明,角度差异项在特征蒸馏中起着至关重要的作用,而不同模型产生的特征的大小可能会有很大变化。因此,很难确定各种模型的适合减肥体重。为了避免角度蒸馏术语的重量受到特征的影响,我们提出了角度蒸馏,并探索沿不同效率尺寸的蒸馏角度信息,以进行语义分割。广泛的例子表明,我们的简单方法对超级参数表现出极大的效果,并实现了语义细分的最先进的蒸馏性能。

多元化和个性化的多评价医学图像细分
注释歧义由于固有的数据不确定性,例如医学扫描中的界限模糊以及不同的观察者专业知识和偏好已成为训练基于深度学习的医学图像模型的主要观点。为了解决这个问题,普遍的做法是从不同专家那里收集多个注释,导致多评价医学图像分割的设置。现有的作品旨在将不同的注释合并到“地面真实”中,而在众多医疗环境中通常无法实现,或者产生不同的结果,或产生与个人专家评估者相对应的个性化结果。在这里,我们提出了一个更雄心勃勃的多评价医学图像细分的目标,即遵守多元化和个性化结果。指定,我们提出了一个名为d-persona的两个阶段框架(第一个d iversification,然后是角色lization)。在第I阶段,我们利用多个给定注释来训练一个可能性的U-NET模型,并具有约束损失,以证明预测多样性。以这种方式,在第I阶段建造了一个共同的空间,其中不同的潜在代码表示多样化的专家意见。然后,在第二阶段,我们设计了多个基于注意力的投影头,以适应来自共享潜在空间的相应专家提示,然后执行个性化的医疗图像细分。我们评估了内部鼻咽癌数据集和公共肺结核数据集(即LIDC-IDRI)的拟议模型。我们的代码将在https://github.com/ycwu1997/d-persona上发布。的实验实验表明,我们的D-Persona可以同时获得多元化和个性化的结果,从而实现了多评位者医疗图像细分的新SOTA性能。

使用UNET变压器神经网络在染色的微观切片上进行定量木材解剖结构
森林在地面碳循环中至关重要,并且对它们对持续气候变化的反应的了解对于确定未来的碳浮动和气候轨迹至关重要。在具有对比季节的区域,树木形成可以分配给日历年的离散年环,从而可以提取有关树木对环境的反应的宝贵信息。木材的解剖结构提供了有关树木对气候的反应和适应的高度分辨信息。定量木材解剖结构有助于通过使用木材微剖面的高分辨率图像在细胞水平上测量木材来检索这些信息。然而,尽管在识别细胞结构方面已经取得了很大的进步,但获得有意义的细胞信息仍然受图像上正确的年度树环界定的阻碍。这是一项耗时的任务,需要经验丰富的操作员手动界定环边界。基于像素值的自动分割的经典方法正在用能够区分结构的新方法代替,即使分界需要高水平的专业知识。尽管已使用神经网络进行木环的分割,但木制的木材图像,但阔叶物种染色的微观切片中细胞模式的复杂性需要自适应模型才能准确地完成此任务。我们在山毛榉核心染色的横截面微隔板图像上使用神经网络提出了自动树环边界划定。基于卷积神经网络的应用我们训练了一个UNETR,一个UNET的联合神经网络和视觉变压器的注意机制,以自动分段年度环边界。考虑到具有手动分割的差异以及数量木材解剖学分析目标的差异以及差异的后果。在大多数情况下(91.8%),自动分割匹配或改进了手动细分,即使将手动细分视为更好的情况,两种类别之间的船只分配率也相似。