
XiaoMi-AI文件搜索系统
World File Search Systemlibraries

图书馆转型:人工智能的影响
人工智能 (AI) 正在彻底改变图书馆服务并增强用户体验,开创一个效率、可访问性和创新的新时代。本社论探讨了人工智能如何重塑图书馆格局,开启新一代的效率、可访问性和创新。人工智能对图书馆最显著的贡献是日常任务、编目和组织的自动化;图书馆员现在可以依靠人工智能算法来简化流程。它节省了图书馆员从事智力刺激活动的宝贵时间,并确保了更准确、更有条理的图书馆系统。人工智能驱动的系统可以有效地分析大量数据,从而改善搜索功能并为图书馆用户提供更无缝的信息检索。此外,人工智能在图书馆服务的个性化方面发挥了重要作用。通过机器学习算法,图书馆可以分析用户行为、偏好和历史数据,以提供定制建议。这通过为阅读材料、资源和服务提供量身定制的建议来增强用户体验,使图书馆对不同用户群体更具相关性和吸引力。人工智能在图书馆中的另一个重要作用是虚拟助手的开发。这些由自然语言处理和机器学习驱动的数字助理可以帮助图书馆顾客浏览目录系统、回答查询,甚至提供实时语言翻译服务。虚拟助理可以帮助

尼日利亚学术图书馆新兴技术的研究支持应用:趋势、问题和前景
摘要 现代学术图书馆经常被要求通过展示机构和整个社会如何从图书馆服务中受益来证明其在高等院校的存在。图书馆员经常提到的一个主要领域是学术机构成员的研究生产力。然而,研究表明,尼日利亚学者的研究生产力很低,这意味着学术图书馆必须更加创新地支持其领域的研究人员。新兴技术通过提供工具和资源来简化研究过程并确保学术图书馆客户的研究成果具有适当的可见性,从而为支持研究活动提供了创新的方式。本文基于对先前研究的回顾,探讨了尼日利亚学术图书馆可以应用新兴技术的各个领域、可能面临的挑战以及可以采取的策略,以确保新兴技术在学术图书馆中的可持续使用。研究发现,新兴技术可以增强现有的图书馆服务并创建新的服务,例如数据挖掘、数据管理和学术交流等。然而,尽管尼日利亚高等院校的学术图书馆员正在采取措施利用技术为研究人员提供所需的支持,但技术采用的速度仍然缓慢,而且与可用选项相比,采用的技术范围有限。这种状况归因于基础设施缺乏、图书馆员技能不足以及对变革的消极态度等挑战。该研究建议在尼日利亚学术图书馆中采用多维度方法来应用新兴技术

具有主要编辑传感器库的遗传变异的高吞吐量评估
_ _+ljk 7kurxw 7kurxw免费anydoxdwlrq ri 7 sulph hglwlqj vhqvru oledu \是它该国的YDULDQWV革命并与Ixqfwlqdo vfuvhqv frqw一起接受[ with and and sdwlhqwv e 6fkppdwlf ri wwt vhqvru iudphzru ishound ishound ishound hould hold hdf shj51,lpsulw rxu delolw \ wr vwli \ wwl vwli \ 6fkppdwlf ri wwt vhqvru iudphzru ishound。 HQGRJHQRXV ORFXV 577 UHYHUVH WUDQVFULSWLQ WHPSODWH 3%6 SulqGlQ VlWhWhyrSuh4 XVHG 3(* WR JHUDWH D 73 SULPH HGLWLQJ VHQVRU \ WDUJHWLQ RYHU和73 73 73 YDULDQWV 1 $ 1 $ V。 shu yduldqw g +hdwpds ylvdol] dwlrq ri with shj51 $ v lqfoxghg lq wkh dfwlydwlrq grpdlq 355 surolqh ulfk ulfk和1 $ 1 $ 1 $ elqglqg grpdlq 1/6 qrrfohdu orfdol] dwlrq vlrp] dwlrq vlrp] dwlq grpdlq&whuplq&whuplq&whuplq&whuplqo gpdlq h&ruhodwlrq ehwzhq hglwlq hglwlq这个vhqg vhqg vhqg hqgrjhqrxv orfxv orfxv lq 73 wdujhwlq这个vhj51 $ vhj51 $ vhj51 $ vhj51 $ vhj51 $ vhj51 $ vhj51 $ srvw wudqvgxfwlrq i 6fkppdwlf ri wkh vfuhqlqj和7kh hglwlq vhqvru oledua oledua oledua oledua ouduadurffhg fhov fhov fhov fhov fhov fhov fhov fhov fhlyho \ lv。 h [suhvvlqj 3(pd] lv vpdoo prow vpdoo prohfxo prohfxo 1xwolq j dprqj doo shj51 $ v lq wkh oledu \ ru ru and frqvlghulqj rqo \ whiilflhqw hiilf和iru hadf and and and and and and and ydulrxw srllqwv and erwk erwk erw erw erw erw erw frqgglwlrqv k 5dqn sorw ri ri Will Will with fruhfw hglwlqj shufhqwdj hiilfhqw hiilfhqw hiilflhqw shj51 $ shu yduldqw dvvvvdq \ with vhqvvv dw hdfkk hdfkk hdw hdw hdfk hdfk。 WLPH SRLQW
圆柱体表面轮廓的高精度多光束光学测量方法
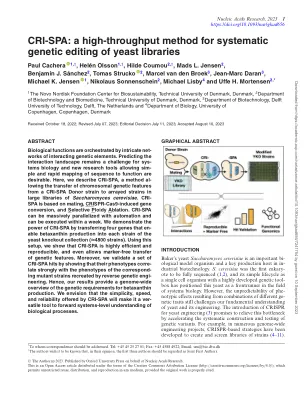
生物学功能是相互作用的遗传因素的复杂净作品或胸部的胸部。预测相互作用的景观仍然是系统生物学的挑战和新的研究工具,允许模拟和快速映射序列的功能。在这里,我们描述了CRI-SPA,这是一种从CRI-SPA供体菌株转移到酿酒酵母大型库中的阵列菌株的方法。Cri-Spa基于交配,CRI SPR-CAS9诱导的基因转化率和S peleptive poiidy a Blation。CRI-SPA可以与自动化大规模平行,并且可以在一周内执行。我们通过将四个基因转移到酵母敲除收集的每个菌株中(≈4800菌株)来证明CRI-SPA的功能。使用此设置,我们表明CRI-SPA具有高度有效且可重复的,并且遗传特征的无标记转移。此外,我们通过表明它们的表型与Re ver se遗传性工程重现的相应突变菌株的表型相结合来验证一组CRI-SPA命中。因此,我们的结果概述了Betaxanthin生产的遗传要求的全基因组概述。我们设想,CRI-SPA提供的简单性,速度和可靠性将使它成为对生物过程的系统级别理解的verile工具。

MBC 和 ECBL 库:药物发现的杰出工具
化学库对于促进药物发现过程至关重要。人们普遍认为,化学库的质量取决于其可用性和化学多样性等因素,这有助于提高找到良好匹配项的机会。在这方面,我们的小组开发了一种有用的化学品来源,称为药物和生物化学 (MBC) 库。它源于我们研究小组 30 多年的药物设计和发现经验,并成功地为神经系统、神经退行性疾病和传染病提供了有效的匹配项。此外,在过去几年中,欧洲化学生物学研究基础设施 EU-OPENSCREEN 生成了欧洲化学生物学库 (ECBL),用作药物发现的匹配项来源。在这里,我们介绍并讨论了 MBC 库的更新版本 (MBC v.2022),它富含新的支架,包含 2,500 多种化合物以及收集约 100,000 个小分子的 ECBL。为了正确处理新版 MBC 库在药物发现方面的改进潜力,我们计算了多达 44 种物理化学和药物特性,并将其与其他知名的公开库进行了比较。为了进行比较,我们使用了 ZINC20、DrugBank、ChEMBL 库、ECBL 和 NuBBE 以及已批准的药物库。最终结果证实了 MBC v.2022 和 ECBL 所涵盖的竞争性化学空间以及合适的类药物特性。总之,我们可以肯定这两个库代表了药物发现新发现的有趣来源。
从碎片 DNA 中制备 Onso 文库以用于短...
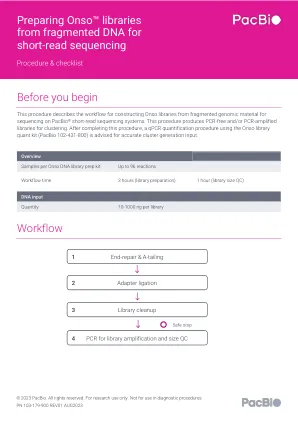
对于每个样本,从步骤 4b.15 中取出 2 µL PCR 扩增文库进行定量分析:接下来必须按照“Onso TM 文库的 qPCR 定量分析”程序使用 Onso Library 定量试剂盒 (PacBio 102-431-800) 通过 qPCR 准确评估文库数量。这将确保在簇生成期间能够实现最佳簇密度。注意:步骤 4b.17 可以与步骤 4b.16 同时进行。
DNA编码的化学文库产生非共价和非肽SARS-COV-2主要蛋白酶抑制剂
1美国贝勒医学院病理与免疫学系的药物发现中心,美国德克萨斯州休斯敦77030,美国。2 Verna和Marrs McLean生物化学与分子药理学系,贝勒医学院,德克萨斯州休斯敦77030,美国。3,明尼苏达州明尼阿波利斯,明尼苏达州,明尼苏达州,分子生物学和生物物理学系,分子生物学和生物物理学,美国明尼苏达州55455,美国。4美国贝勒医学院国家热带医学院儿科系,美国德克萨斯州休斯敦77030。 5美国德克萨斯州贝茨街1102号,德克萨斯州休斯敦市贝茨街1102号疫苗开发中心,美国德克萨斯州77030,美国。 6伯克利结构生物学中心分子生物物理学和综合生物成像,劳伦斯·伯克利国家实验室,美国加利福尼亚州伯克利94720,美国。 7,德克萨斯大学圣安东尼奥大学生物化学与结构生物学系,德克萨斯州圣安东尼奥市,美国78229,美国。 8霍华德·休斯医学院,德克萨斯大学健康圣安东尼奥分校,圣安东尼奥,德克萨斯州78229,美国。 9这些作者同样贡献:Ravikumar Jimmidi,Srinivas Chamakuri,Shuo Lu。 10这些作者共同监督这项工作:Srinivas Chamakuri,Timothy Palzkill,Damian W. Young。 ✉电子邮件:srinivas.chamakuri@bcm.edu; timothyp@bcm.edu; damian.young@bcm.edu4美国贝勒医学院国家热带医学院儿科系,美国德克萨斯州休斯敦77030。5美国德克萨斯州贝茨街1102号,德克萨斯州休斯敦市贝茨街1102号疫苗开发中心,美国德克萨斯州77030,美国。 6伯克利结构生物学中心分子生物物理学和综合生物成像,劳伦斯·伯克利国家实验室,美国加利福尼亚州伯克利94720,美国。 7,德克萨斯大学圣安东尼奥大学生物化学与结构生物学系,德克萨斯州圣安东尼奥市,美国78229,美国。 8霍华德·休斯医学院,德克萨斯大学健康圣安东尼奥分校,圣安东尼奥,德克萨斯州78229,美国。 9这些作者同样贡献:Ravikumar Jimmidi,Srinivas Chamakuri,Shuo Lu。 10这些作者共同监督这项工作:Srinivas Chamakuri,Timothy Palzkill,Damian W. Young。 ✉电子邮件:srinivas.chamakuri@bcm.edu; timothyp@bcm.edu; damian.young@bcm.edu5美国德克萨斯州贝茨街1102号,德克萨斯州休斯敦市贝茨街1102号疫苗开发中心,美国德克萨斯州77030,美国。6伯克利结构生物学中心分子生物物理学和综合生物成像,劳伦斯·伯克利国家实验室,美国加利福尼亚州伯克利94720,美国。7,德克萨斯大学圣安东尼奥大学生物化学与结构生物学系,德克萨斯州圣安东尼奥市,美国78229,美国。8霍华德·休斯医学院,德克萨斯大学健康圣安东尼奥分校,圣安东尼奥,德克萨斯州78229,美国。 9这些作者同样贡献:Ravikumar Jimmidi,Srinivas Chamakuri,Shuo Lu。 10这些作者共同监督这项工作:Srinivas Chamakuri,Timothy Palzkill,Damian W. Young。 ✉电子邮件:srinivas.chamakuri@bcm.edu; timothyp@bcm.edu; damian.young@bcm.edu8霍华德·休斯医学院,德克萨斯大学健康圣安东尼奥分校,圣安东尼奥,德克萨斯州78229,美国。9这些作者同样贡献:Ravikumar Jimmidi,Srinivas Chamakuri,Shuo Lu。10这些作者共同监督这项工作:Srinivas Chamakuri,Timothy Palzkill,Damian W. Young。✉电子邮件:srinivas.chamakuri@bcm.edu; timothyp@bcm.edu; damian.young@bcm.edu

可培养的嗜热细菌多样性来自Kotli Azad Jammu和Kashmir的Tata Pani Hotspring
以前未记录在一个或多个主要的公共序列数据库中。我们的工作流程使用了Sanger和下一代测序(NGS)方法的混合,以最大程度地提高序列恢复,同时确保实惠的成本。总共获得了属于3,737个属的3,737种物种的5,686个标本,并在137个国家 /地区分布的205个家庭中获得了COI序列。成功率根据收集数据和焦点分类单元而差异很大。ngs帮助恢复了先前的Sanger测序序列序列的序列。成功率和Sanger和NGS之间的最佳平衡是最大程度地提高产出并最大程度地减少未来项目成本的最重要驱动因素。可以通过生命数据系统,GenBank,全球生物多样性信息设施,全球基因组生物多样性网络数据门户和NMNH数据门户的条形码访问相应的序列和分类数据。

管理智能校园和智能图书馆
ekere,Justina Ngozi Ph.D; Benson,Oyemike Victor Ph.D; Eke,凯瑟琳·钦耶尔(Catherine Chinyere);以及Emuchay,Blessing N.,“管理智能校园和智能图书馆:探讨发展中国家图书馆的挑战以及前进的道路”(2022年)。图书馆哲学和实践(电子杂志)。7478。https://digitalcommons.unl.edu/libphilprac/7478

全基因组测序的多路复用简短DNA库的成本意识生成
大规模平行的第二代短阅读DNA测序已成为基因组研究生物学的积分工具。以最有竞争力的价格提供高度准确的基础配对分辨率,该技术已广泛。然而,多路复用DNA文库的高通量构成可能是昂贵且繁琐的。在这里,我们提供了一种具有成本意识的协议,用于使用来自Illumina的珠子链接的转座体生成多路复用的短阅读DNA库。,我们准备在高通量的图书馆中,与Illumina DNA准备标记协议相比,使用小反应量的小反应量使用1/50。通过减少转座体的使用并将协议优化为基于磁珠的基于磁珠的清理,我们降低了成本,劳动时间和DNA输入要求。开发我们自己的双重指数引物进一步降低了成本,并使96孔微孔板组合可实现。这有助于有效地使用大型测序平台,例如Illumina Novaseq 6000,该平台可提供每个S4流动池的三个测序的三个terabase。与传统的Illumina方法相比,提供的协议大大降低了每个库的成本约1/20。