
XiaoMi-AI文件搜索系统
World File Search Systemplain
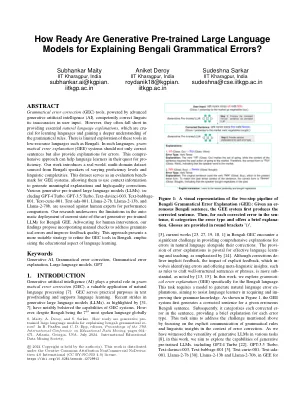
如何准备好生成的预训练的大语言模型来解释孟加拉语语法错误?
抽象的语法校正校正(GEC)工具,由先进的生成人工智能(AI)提供动力,在用户输入中有效地纠正了语言的不准确性。但是,它们通常在提供基本的自然语言解释方面缺乏,这些解释是学习语言并获得对语法规则的更深入的理解。在低资源语言(例如孟加拉语)中对这些工具的探索有限。在这样的语言中,革命错误说明(GEE)系统不仅应正确句子,而且还应提供错误的解释。这种综合方法可以帮助语言学习者寻求提高能力。我们的工作介绍了一个现实世界中的多域数据集,该数据集来自孟加拉语扬声器,具有不同的义务水平和语言复杂性。此数据集可作为GEE系统的评估基准标记,允许他们使用上下文信息来生成有意义的解释和高质量的更正。Various generative pre-trained large language models (LLMs), in- cluding GPT-4 Turbo, GPT-3.5 Turbo, Text-davinci-003, Text-babbage- 001, Text-curie-001, Text-ada-001, Llama-2-7b, Llama-2-13b, and Llama-2-70b, are assessed against human experts for performance comparison.我们的研究强调了自动部署孟加拉人GEE的当前最新生成预培训的LLM的局限性。主张进行人干预,我们的发现提议合并手动检查以解决语法错误并提高反馈质量。这种方法提出了一种更合适的策略,以重新确定孟加拉语的GEC工具,并阐明了语言学习的教育方面。


耶鲁大学/GRA ACC模型:可用于自然的新独特工具;解释器
科学家用来解释生态系统中捕获和存储的碳量的数学工具很少考虑动物的影响。这源于这样的假设:由于动物比生态系统中的植物和微生物要稀有得多,因此它们的潜在影响应该是最小的。然而,现场研究已经开始表明,这种假设可能不是准确的,如2023年3月下旬的《自然气候变化》杂志发表的《自然气候变化可以扩大自然气候解决方案》中所示。这导致了一个新的询问领域,称为碳循环(ACC)。

激光的基本原理 解释...的过程
异质和非同质 无 同质和非同质 激光沿 -------------- 方向发射光。 各种 1 2 无 1 激光辐射具有 --------------- 相干度。 低 高中 非常低 高 时间不相干性是光束的特性 ----------- 单一 多重 a 和 b 以上都不是 单一 时间相干性的另一个名称是 ----------- 相干性 横向 空间 纵向 以上都不是 纵向 ----------- 是光泵浦稀土激光系统的最佳例子 钙离子 铒离子 铀离子 钕离子 钕离子 发现荧光量子效率接近 -------- 零 小于 1 1 大于 1 1 光束强度降至中心值的 1/e 倍的点称为 ---------- 内边 半边 全边 外边 外边
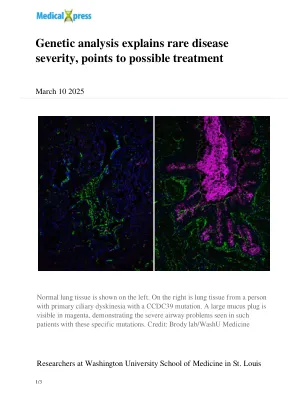
遗传分析解释了罕见疾病的严重程度,指向可能的治疗
由遗传学教授苏珊·荷兰(Susan K.除了功能失调的睫状网络之外,缺失的结构还导致某些应该具有纤毛的细胞产生粘液,这可能会导致气道问题增加。

DNA脱甲基解释了番茄如何将其苦毒素转化为更可口的
要找出蛋白质在转化过程中扮演的角色,研究人员设计了番茄植物来开关和关闭生产,使他们能够看到他们的影响。他们发现了一种叫做DML2的,该DML2在关闭产量时阻止了糖基类动物的分解,使水果太苦了,无法吃。进一步的研究表明,该蛋白质能够通过称为脱甲基化的化学过程分解糖基虫类。
解释了CDK介导的细胞周期控制中的冗余:统一连续性和定量模型
摘要:在真核生物中,Cyclin依赖性激酶(CDKS)是DNA复制和有丝分裂的必需的,并且在整个细胞周期中,依次激活了不同的CDK-循环蛋白复合物。普遍认为,特定的复合物需要遍历G1中细胞周期的承诺,并分别促进S期和有丝分裂。因此,根据一个流行的模型,几十年来一直占据了领域的流行模型,在细胞周期的每个阶段,针对不同底物的独特CDK – cyclin compleces固有的特定座位生成了事件的正确顺序和时间。但是,编码细胞周期蛋白和CDK的基因敲除的结果不支持此模型。通过许多最近的工作验证的替代性“定量”模型表明,CDK活性的总体水平(具有相反的磷酸酶输入)决定了S期和有丝分裂的时间和顺序。我们通过建议将细胞周期分为离散阶段(G0,G1,S,G2和M)的细分被过时且有问题,从而进一步采用了该模型。相反,我们恢复了细胞周期的“连续性”模型,并提出与定量模型的结合更好地定义了理解细胞周期控制的概念框架。
葡萄糖:可解释的餐后血糖预测和体育锻炼
摘要 - 以餐后的血糖水平超过正常范围的标志性的植物性高血糖,这是在糖尿病和健康个体中向2型糖尿病进展的关键指标。饮食后了解血糖动力学的关键指标是曲线下的餐后区域(PAUC)。根据人的饮食和活动水平预测PAUC,并解释什么影响餐后血糖可以使人可以相应地调整其生活方式以维持正常的葡萄糖水平。在本文中,我们提出了葡萄糖,这是一种可解释的机器学习,以预测饮食,活性和最近的葡萄糖模式中的PAUC和高血糖。我们对10个全职工作人员进行了为期五周的用户研究,以开发和评估计算模型。我们的机器学习模型采用多模式数据,包括空腹葡萄糖,近期葡萄糖,最近的活性和大量营养素量,并提供了可解释的餐后葡萄糖模式的预测。我们对收集到的数据的广泛分析表明,训练有素的模型达到了0.123的归一化均方根误差(NRMSE)。平均而言,带有随机森林主链的葡萄糖素比基线模型可获得16%的结果。此外,血糖素可以准确地预测高血糖率74%,并建议通过不同的反事实解释来帮助避免高血糖。可用代码:https://github.com/ab9mamun/glucolens。

o r i g i n a l r e s a r c h可解释的预测芬兰2型糖尿病患者的长期糖化血红蛋白反应变化
目的:本研究应用机器学习(ML)和可解释的人工智能(XAI)来预测HbA1c水平的变化,这是监测血糖控制的关键生物标志物,在诊断为2型糖尿病患者的患者中,在启动一种新的抗糖尿病药物后的12个月内。它还旨在确定与这些变化相关的预测因素。患者和方法:来自芬兰北卡雷利亚(North Karelia)的10,139名2型糖尿病患者的电子健康记录(EHR)用于训练整合了随机对照试验(RCT)衍生的HBA1C变化值作为预测变量的预测因子,创建将RCT洞察力与现实世界中集成的偏移模型。各种ML模型 - 包括线性回归(LR),多层感知器(MLP),山脊回归(RR),随机森林(RF)和XGBoost(XGB) - 使用R²和RMSE衡量标准进行评估。基线模型在药物启动之前或之前使用的数据,而随访模型包括第一个药物后HBA1C测量,通过合并动态患者数据来改善性能。模型性能也与临床试验中预期的HBA1C变化进行了比较。结果:结果表明,ML模型的表现要优于RCT模型,而LR,MLP和RR模型具有可比性的性能,RF和XGB模型表现出过于拟合。与基线模型相比,随访MLP模型的表现优于基线MLP模型,其R²得分(0.74,0.65)和较低的RMSE值(6.94,7.62)与基线模型(R²:0.52,0.54; RMSE; RMSE:9.27,9.50)相比。HBA1C变化的关键预测因子包括基线和药后HBA1C值,禁食等离子体葡萄糖和HDL胆固醇。未来的研究将探索治疗选择模型。结论:使用EHR和ML模型可以开发对HBA1C变化的更真实和个性化的预测,考虑到更多样化的患者人群及其异质性,为管理T2D提供了更量身定制和有效的治疗策略。XAI的使用提供了对特定预测因子影响的见解,从而增强了模型的解释性和临床相关性。关键字:类型2糖尿病,HBA1C,治疗效果估计,机器学习,Shap