
XiaoMi-AI文件搜索系统
World File Search Systemsuper
组装金属超水的化学模板
ecent di sc o of tal s tal s up h y d r d r d i d i d i d e es p r o v id e a n e n e n e n e w r om om to r oom -te m p eary tu e e e e e e e e erc ondu o to to to rs to rs。How ever , th e i r s t r u c tu re t re nd s a nd th e c h e mi ca l d r i v ing fo rce n ee d e d to di ss o c i a t e H 2 a nd fo rm H c o va l e nt n e two rk ca nno t b e explained b y di rec t me t a l-h y d r og e n bond s .here,如何将其构成,以征求意见。By a n a l y zing high-th r oughput ca l c ul a tion res ult s of me t a l s acr o s s t h e pe r iodi c tabl e a nd in var iou s l a tti ces , w e s how th a t, a ft er rem o v ing H, th e rema ining me tal l a t t i ces ex hibit l ar g e e l ec t r on o cc up a n n a a a a a t e c int ect i a l o a ls a ls a ls a llentl y to tti ces and tti ces and tti ces and t e i r w ave fun c tion s li ke li ke a te m p te m pl a t te m pl a t te t te t te t te t te t te t te t te t te t te t te t te t te t te t te t te t te t te t t t t te m pl a t te。fu r therm o re,在3 d ar o ma ti c构建单位的s i s tti c e s c上,在a r e g e g e e tabiliz e d b y c y c h em i ca e em i ca l t em t em t e em t e em t e e e t a e e t a l s n ear t e s s s s s -d b b b b d b r d er th e t e e t e e s the。Thi s th e or y can n a tu ra ll y ex pl a in th e s t a bilit y a nd s t r u c tu re t re nd s of s up er h y d r id es a nd gr eat l y enhance th e e ffi c i e n cy of p re di c ting n e w ma t er i a l s , s u c h as two-m eta l supe r h y d r id es .

结合监督和无监督机器学习
最后,Darktrace 还使用各种机器学习技术来自动执行调查工作流程中执行的重复且耗时的任务。通过分析专家网络分析师如何与 AI 的输出进行交互(例如他们如何分类威胁警报以及他们如何使用第三方来源),Darktrace 能够复制这些专家行为并自动执行某些分析师功能。这使得所有成熟度级别的分析师都能进行越来越高效和简化的调查。它还为安全团队提供了他们所需的关键时间,使他们能够专注于更高价值的战略工作,例如管理风险和专注于更广泛的业务改进。

通过增强学习
学习表征捕获对世界的非常基本的理解是机器学习的关键挑战。隐藏在数据中的解释因素的层次结构是如此一般的表示,并且可以通过分层VAE实现。然而,培训层次的VAE总是遭受“后塌陷”的苦难,其中数据信息很难传播到更高级别的潜在变量,因此导致层次结构不良。为了解决这个问题,我们首先是从信息理论的角度来减轻后层崩溃的现有方法的缺点,然后突出了正规化的必要性,即在维持不同级别之间的依赖性的同时,将数据信息明确传播到高级潜在变量。这自然会导致提出高级潜在表示作为顺序决策过程的推断,这可能受益于应用强化学习(RL)。将RL的目标与正规化的目标保持一致,我们首先引入了一条跳过的途径,以获取奖励,以评估潜在的潜在表示的信息内容,然后基于它的Q-VALUE函数可能具有正规化的一致优化方向。最后,策略梯度是典型的RL方法之一,用于训练层次VAE,而无需引入梯度估计器。1。简介实验结果坚定地支持我们的分析,并证明我们提出的方法有效地减轻了后塌陷问题,学习了信息的层次结构,获得了可解释的潜在表示,并且在下游任务中明显优于其他基于层次的VAE方法。
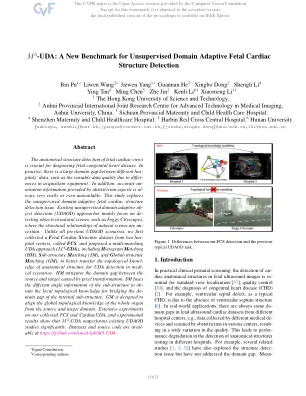
m3-uda:无监督域自适应胎儿心脏结构检测的新基准
胎儿心脏视图的解剖结构检测对于诊断胎儿先天性心脏病至关重要。实际上,不同的Hos-Pitals数据之间存在较大的域间隙,例如由于采集设备的不同而引起的可变数据质量。此外,产科专家提供的准确的符号信息非常昂贵甚至无法使用。本研究探讨了无监督的域自适应胎儿心脏结构检测问题。现有的无监督域自适应观察检测(UDAOD)的方法主要集中在自然场景中的特定物体,例如雾gy的城市景观中,自然场景的结构关系是不确定的。Unlike all previous UDAOD scenarios, we first collected a F etal C ardiac S tructure dataset from two hos- pital centers, called FCS , and proposed a multi-matching UDA approach ( M 3 -UDA ), including H istogram M atching (HM), S ub-structure M atching (SM), and G lobal-structure M atching (GM), to better transfer the在医疗场景中进行UDA检测的解剖结构的拓扑知识。HM减轻由像素转换引起的源和目标之间的域间隙。sm融合了子结构的不同角度信息,以遵循局部拓扑知识,以弥合内部子结构的主要间隙。GM旨在使整个器官的全球拓扑知识与目标域相结合。对我们收集的FCS和Cardiacuda进行了广泛的实验,实验结果表明,M 3 -UDA的表现胜过现有的UDAOD研究。数据集和源代码可在https://github.com/xmed-lab/m3-uda

探究澳大利亚向绿色能源超级大国转型的过程
过去十年,澳大利亚最大的出口产品是铁矿石。澳大利亚拥有清洁能源未来所需的几乎所有金属储量,居世界首位。如今,澳大利亚将这些金属的大部分以矿石形式出口,在其他地方提炼成金属。89% 的澳大利亚铁矿石未经提炼成钢就直接出口。炼钢成本的三分之一实际上是提炼矿石所需的能源。我们有矿石,我们有能源超级大国,我们应该利用多余的能源来提炼矿石。如果我们将能源嵌入制造过程并出口更多精炼金属(售价高得多),我们就有了一个超级大国的机会,非常适合澳大利亚的自然资源优势——金属矿石和低成本能源。钢铁的售价大约是铁矿石的 10 倍。举一个简单的例子,今天我们从铁矿石出口中获得了约 780 亿美元的收入。如果我们将其提炼并作为钢铁出口,收入可高达 7070 亿美元。
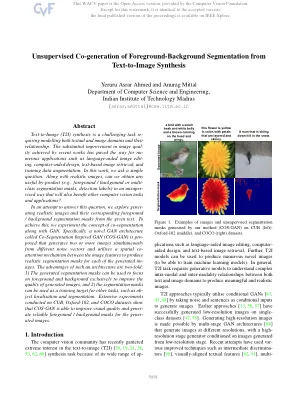
从文本到图像综合的前景 - 背景分割的无监督共同生成
文本对图像(T2I)合成是一项艰巨的任务,该任务是对文本和图像域及其关系进行建模。最近作品实现的图像质量的实质性改进为Nuberon应用程序铺平了道路,例如语言辅助图像编辑,计算机辅助设计,基于文本的图像检索和培训数据增强。在这项工作中,我们提出了一个简单的问题:与逼真的图像一起,我们是否可以以一种不受影响的方式获得任何有用的副产品(例如前景 /背景或多类分割掩码,检测标签,检测标签),这也将使其他计算机视觉任务任务和应用受益?试图回答这个问题,我们探索了从给定文本中的逼真的图像及其相应的前景 /背景分割掩码。为了实现这一目标,我们与GAN一起实验了共进行分割的概念。具体而言,提出了一种名为“共裂”启发的GAN(COS-GAN)的新型GAN结构,该结构同时从不同的噪声矢量中同时生成两个或多个图像,并利用图像特征之间的空间关注机制来生成逼真的分段掩码,以生成生成的Im-Im-Im-Im-Im-Im-Im-Im-Im-Im-Im-Agens。这种架构的优点是两倍:1)生成的分割掩码可用于专注于前景和背景,以改善生成的图像的质量,2)分段蒙版可以用作其他任务的训练目标,例如访问本地化和分割。在CUB,Oxford-102和可可数据集上进行的广泛实验表明,Cos-Gan能够改善视觉质量,并为发电图像提供可靠的前景 /背景掩码。

截至 2019 年末已核准的附属学院导师名单......
2024 年 3 月 13 日 — 建模与设计)、微电子学和量子电子学、计算电子学、天线设计、人工智能 gurmohan@cdac.in。9417483045。

Tri-VAE:用于脑肿瘤 MRI 无监督异常检测的三重变分自动编码器
由于带注释的样本稀缺,病理性脑损伤在图像数据中的复杂表现对监督检测方法提出了挑战。为了克服这个困难,我们将重点转移到无监督异常检测。在这项工作中,我们专门使用健康数据训练所提出的模型,以识别测试期间未见的异常。这项研究需要调查基于三元组的变分自动编码器,以同时学习健康脑数据的分布和去噪能力。重要的是,我们纠正了先前基于投影的方法中固有的一个误解,该误解依赖于这样的假设:图像内的健康区域在重建输出中将保持不变。这无意中暗示了病变图像和无病变图像在潜在空间表示上存在相当大的相似性。然而,这种假设可能并不成立,特别是由于病变区域强度对投影过程的潜在重大影响,特别是对于具有单一信息瓶颈的自动编码器。为了克服这个限制,我们将度量学习与潜在采样分离。这种方法确保病变和无病变输入图像都投影到相同的分布中,特别是无病变投影。此外,我们引入了一个语义引导的门控交叉跳过模块来增强空间细节检索,同时抑制异常,利用解码器更深层中存在的健壮健康大脑表示语义。我们还发现,将结构相似性指数测量作为额外的训练目标可以增强所提模型的异常检测能力。

进化:增强无监督的持续学习与多位专家
近年来在未加强的持续学习方法中取得了重大进展。尽管它们在受控设置中取得了成功,但它们在现实世界中的实用性仍然不确定。在本文中,我们首先从经验上介绍了现有的自我保护的持续学习方法。我们表明,即使有了重播缓冲液,现有的methods也无法保留与时间相关输入的视频的关键知识。我们的见解是,无监督的持续学习的主要挑战源于无法预测的意见,缺乏监督和先验知识。从Hybrid AI中汲取灵感,我们介绍了E Volve,这是一个创新的框架,它是云中的多个预审预周化模型,作为专家,以加强对Lo-cal Clister的现有自我监督的学习方法。e Volve通过新颖的专家聚合损失来利用专家指导,并从云中返回并返回。它还根据专家的信心和量身定制的先验知识将权重动态分配给专家,从而为新流数据提供自适应监督。我们在几个具有时间相关的实地世界数据流中广泛验证了E volve。结果令人信服地表明,E Volve超过了最佳的无监督持续学习方法,在跨Var-IOS数据流的Top-1线性评估准确性中,volve持续了6.1-53.7%,从而确认了多样化的专家指南的功效。代码库位于https://github.com/ orienfish/evolve。

监督与无监督的学习
●Breiman(2001)首先提出了随机森林算法,但基于1995年的Tim Kan Ho●RF采用了两种集合技术:首先是训练样本,以种植基于不同培训训练数据的树木森林。第二个是特征空间的子采样。●如果我选择变量的子集(例如x1, x3, x7) to create a split in a node of a decision tree, and another subset (x2, x4, x5, x7) to create a different one, there will be events that get classified in a different way by the two nodes ● Often there is a dominant variables that is used to decide the split, offsetting the power of the subdominant ones.rf通过减少不同树的相关性来避免该问题