
XiaoMi-AI文件搜索系统
World File Search System具有
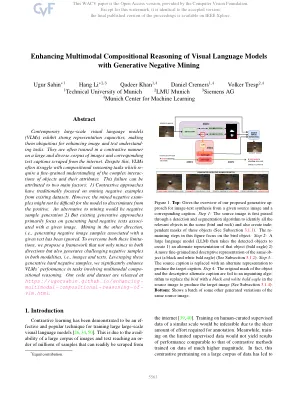
增强具有生成负面挖掘的视觉语言模型的多模式组成推理
当代的大规模视觉语言模型(VLM)具有强大的表示能力,使它们无处不在,可以增强图像和文本理解任务。他们经常以对比的方式受到大量图像和相应的文本字幕的对比方式进行训练。尽管如此,VLMS经常在构图推理任务上挣扎,这些任务对对象及其属性的复杂相互作用进行了精细的了解。此失败可以归因于两个主要因素:1)对比的方法传统上专注于从现有数据集中开采负面示例。但是,该模型可能不难区分阳性检查。替代采矿的替代方法是负样本2),但现有的生成方法主要集中于生成与给定图像相关的硬性负面文本。在另一个方向上进行挖掘,即生成与给定文本相关的负面图像样本已被忽略。为了克服这两种限制,我们提出了一个框架,不仅在两个方向上矿山,而且在这两种方式(即图像和文本)中产生了有挑战性的负面样本。利用这些生成硬性负样本,我们在涉及多模式综合推理的任务中显着提高了VLMS的性能。我们的代码和数据集在https://ugorsahin.github.io/enhancing-- vlm.html上发布。

细菌假设蛋白可能具有功能性
基因组分析是许多微生物学研究人员日常工作的一部分。这些分析经常揭示以不确定功能编码蛋白质的基因,对于许多细菌物种,这些未知基因构成了其基因组编码序列的显着比例。由于这些基因没有定义的功能,因此在分析中通常会忽略它们。实验确定基因的功能可能具有挑战性;但是,生物信息学工具的持续进步,尤其是在蛋白质结构分析中,使得逐渐更容易地将功能分配给假设序列。利用各种互补工具和自动化管道来注释假设序列,最终可以增强我们对微生物功能的理解,并为新的实验室实验提供方向。

在具有LEAP的临床前癌模型中预测基因的本质和药物反应:自动编码器和
临床前扰动筛选,其中在疾病模型上系统地测试了遗传,化学或环境扰动的影响,由于其规模和因果性质,对机器学习增强的药物发现具有巨大的希望。预测模型可以根据分子特征来推断以前未经测试的疾病模型的扰动反应。这些在计算机标签中可以扩展数据库并指导实验优先级。但是,对扰动特异性效应进行建模并在各种生物环境中产生健壮的预测性能仍然难以捉摸。我们介绍了LEAP(自动编码器和预测变量的分层集合),这是一个新颖的集合框架,可改善稳健性和概括。LEAP利用多个Damae(数据增强蒙版的自动编码器)表示和套索回归器。通过结合从不同随机初始化中学到的多种基因表达表示模型,在预测未见细胞系,组织和疾病模型中基因本质或药物反应方面始终胜过最先进的方法。值得注意的是,我们的结果表明,结合表示模型而不是仅预测模型会产生出色的预测性能。超出其性能增长,LEAP在计算上是有效的,需要最小的高参数调整,因此很容易将其纳入药物发现管道中,以优先考虑有希望的目标并支持生物标志物驱动的分层。这项工作中使用的代码和数据集可公开使用。

具有激发正常模式的涡流散射
Abelian-Higgs模型[1]是一种相对论场理论,其在(2Þ1)维度中的激发采用拓扑稳定的孤子的形式,称为涡旋。该场理论由一个复杂的标量场φ组成,该场φ耦合到u - 1Þ量规场Aμ。静态理论等同于有效的金茨堡 - 兰道理论[2],它描述了一个通过涡旋数量量化的超导体的磁场。涡流解决方案的动力学是这两种理论不同的地方。 Abelian-Higgs模型具有Lorentz不变性[3-5]的二阶动力学[3-5],而依赖时间的Ginzburg-Landau模型则表现出一级动力学[6,7]。这是我们将在本文中重点关注的前二阶动力。请注意,在(3þ1)中的尺寸涡流显示为像弦类似的物体,所产生的宇宙字符串,如果存在,则可以通过对早期宇宙宇宙学的重力贡献来检测到它们[8]。涡流散射已经对单个参数λ的所有值进行了很好的研究[3 - 5,9,10]。此参数将模型分为两种类型; I型I(λ<1)其中涡流表现出长距离吸引力,而II型(λ> 1),其中涡旋在远距离排列。相比之下,在临界耦合(λ¼1)处,

tcl-net:具有频率域融合和多角度注意的轻巧有效的飞行网络
摘要。朦胧的图像带来了一个具有挑战性的问题,由于信息丢失和颜色失真而遭受。当前的基于深度学习的去悬式方法通过增加网络深度来增强性能,但会导致大量参数开销。同时,标准卷积层集中在低频细节上,通常会说出高频信息,这阻碍了模糊图像中提出的先前信息的有效利用。在本文中,我们提出了TCL-NET,这是一个轻巧的飞行网络,该网络强调了频域特征。我们的网络首先包含一个用于提取高频和低频内形式的所谓层,该层是针对原始模糊图像的快速变压器专门设计的。同时,我们设计了一个频率域信息融合模块,该模块将高频和低频信息与后续卷积层的卷积网络作品集成在一起。此外,为了更好地利用原始图像的空间信息,我们引入了一个多角度注意模块。使用上述设计,我们的网络以仅0.48MB的总参数大小实现了出色的性能,与其他最先进的轻量级网络相比,参数的数量级降低了。
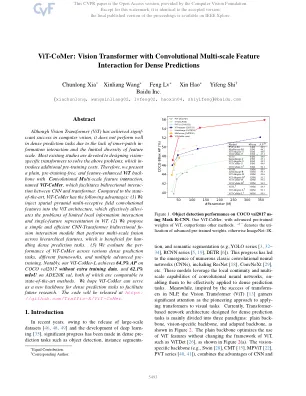
VIT-COMER:具有卷积多尺度特征相互作用的视觉变压器,用于密集预测
尽管Vision Transformer(VIT)在计算机视觉方面取得了显着的成功,但由于缺乏内部绘制互动和特征量表的多样性有限,它在密集的预测任务中表现不佳。大多数现有的研究致力于设计视觉特定的变压器来解决上述问题,从而涉及额外的培训前成本。因此,我们提出了一种普通的,无培训的且具有特征增强的vit背骨,并具有指定性的特征性动作,称为Vit-Comer,可促进CNN和Transformer之间的双向相互作用。与现状相比,VIT-COMER具有以下优点:(1)我们将空间金字塔多触发性场卷积特征注入VIT体系结构,从而有效地减轻了VIT中局部信息相互作用和单场表述的有限问题。(2)我们提出了一个简单有效的CNN转换器双向交互模块,该模块在跨层次特征上执行多尺度融合,这对Han-dling密集的预测任务有益。(3)我们评估了在各种密集的预测任务,不同框架和多个高级预训练中VIT-COMER的能力。值得注意的是,我们的VIT-COMER-L在没有额外训练数据的情况下可可Val2017上的AP达到64.3%,而ADE20K Val上的MIOU为62.1%,这两种方法都与最先进的方法相当。我们希望VIT-COMER可以作为密集预测任务的新骨干,以促进未来的研究。该代码将在https://github.com/traffic-x/vit-comer上发布。

具有自增强自适应性能的分级多孔钢整体结构
铁是一种丰富的化学元素,自古以来就以钢和铸铁的形式用于制造工具、器皿和武器。[1,2] 钢铁目前每年的产量为 1.4 亿吨,是人类文明中最广泛利用的材料之一。[1] 如此高的产量和当前加工技术的高碳足迹,使钢铁成为现代社会减少材料对环境影响的首选材料。[3] 虽然全世界的大部分钢铁生产都用于制造致密的建筑结构元件,但人们也在探索将多孔铁块用于催化、[4] 储能、[5] 组织再生 [6] 和结构应用。[7] 对环境影响较小的轻质结构的需求日益增长,人们对此类多孔金属以及它们对旨在更有效地利用自然资源的非物质化战略的潜在贡献的兴趣日益浓厚。海绵铁是通过将矿石在熔点以下直接还原而获得的,是多孔金属最早的例子之一。[8] 由于其强度相对较低,这种多孔铁在过去被用作制造致密结构的前体。多孔金属的低强度源于众所周知的材料强度和相对密度之间的权衡。[9] 根据 Gibson-Ashby 分析模型的预测,[10] 多孔和胞状结构的强度和刚度与固相相对密度 (φ) 呈幂律关系:P∼φm,其中 P 是关注的属性,m 是缩放指数。重要的是,高度多孔的大型结构(φ<0.20)通常表现出的刚度和承载能力远低于这种简单分析模型的预期水平。 [11] 事实上,实验和计算研究表明,当材料的相对密度接近其渗透阈值时,只有一小部分固相能有效地增加多孔结构的刚度。[12,13] 这是因为在多孔网络结构整体变形过程中存在未受载荷的悬挂元素。[14]
具有固定电荷的混合态的量子关联与经典关联的有效分离
纠缠是量子技术的关键资源,是令人兴奋的多体现象的根源。然而,当现实世界的量子系统与其环境相互作用时,量化其两部分之间的纠缠是一项挑战,因为后者将跨边界的经典关联与量子关联混合在一起。在这里,我们使用混合态的算子空间纠缠谱有效地量化了这种现实开放系统中的量子关联。如果系统具有固定电荷,我们表明谱值的子集编码了不同跨边界电荷配置之间的相干性。这些值的总和,我们称之为“配置相干性”,可用作跨边界相干性的量化器。至关重要的是,我们证明了对于纯度非增映射,例如具有 Hermitian 跳跃算子的 Lindblad 型演化,配置相干性是一种纠缠度量。此外,可以使用状态密度矩阵的张量网络表示有效地计算它。我们展示了在存在失相的情况下在链上移动的无自旋粒子的配置相干性。我们的方法可以量化广泛系统中的相干性和纠缠,并激发有效的纠缠检测。

受大脑启发的具有脉冲神经元的多层感知器
近年来,多层感知器 (MLP) 成为计算机视觉任务领域的研究热点。由于没有归纳偏差,MLP 在特征提取方面表现良好并取得了惊人的效果。然而,由于其结构简单,其性能高度依赖于局部特征通信机制。为了进一步提高 MLP 的性能,我们引入了脑启发神经网络的信息通信机制。脉冲神经网络 (SNN) 是最著名的脑启发神经网络,在处理稀疏数据方面取得了巨大成功。SNN 中的泄漏积分和触发 (LIF) 神经元用于在不同时间步骤之间进行通信。在本文中,我们将 LIF 神经元的机制合并到 MLP 模型中,以在不增加 FLOP 的情况下实现更好的准确率。我们提出了一种全精度 LIF 操作来在块之间进行通信,包括不同方向的水平 LIF 和垂直 LIF。我们还建议使用组 LIF 来提取更好的局部特征。借助 LIF 模块,我们的 SNN-MLP 模型在 ImageNet 数据集上分别仅使用 4.4G、8.5G 和 15.2G FLOP 就实现了 81.9%、83.3% 和 83.5% 的 top-1 准确率,据我们所知,这是最先进的结果。源代码将在 https://gitee.com/mindspore/models/tree/master/research/cv/snn mlp 上提供。

infinigen:具有动态KV缓存管理的大语言模型的有效生成推断
基于变压器的大语言模型(LLMS)在各种自然语言处理任务中都具有令人印象深刻的表现。为LLM推断为生成长含量而构成挑战,这是由于瞬态状态的巨大内存足迹(称为键值(KV)缓存),该状态以序列长度和批处理大小缩放。在本文中,我们提出了Infinigen,这是一种针对Longext Genertion量身定制的新型KV缓存管理框架,该框架协同与现代卸载基于卸载的推理系统合作。Infinigen利用了关键见解,即可以通过对当前层的最小彩排以及查询权重的一部分和后续层的关键缓存进行最小化的彩排来推测,对于计算变压器中后续注意力层至关重要的重要洞察力。这使我们只能预取基本的KV缓存条目(不提供所有内容),从而在基于卸载的LLM服务系统中减轻主机内存中的提取开销。我们对几种代表性LLMS的评估表明,与先前的KV高速缓存管理方法相比,Infinigen将基于现代卸载系统的总体性能提高了3.00倍,同时提供了更好的模型准确性。