
XiaoMi-AI文件搜索系统
World File Search System多模

生成的多模式模型是良好的类增量学习者
在班级学习(CIL)方案中,由于阶级的偏见对当前任务的偏见引起的灾难性遗忘者长期以来一直引起了重大挑战。它主要由判别模型的特征引起。随着生成性多模式模型的日益普及,我们将探索用CIL生成的歧视模型代替歧视模型。,从歧视到生成模式过渡需要解决两个关键挑战。主要挑战在于将生成的文本信息转移到不同类别的分类中。在方面,它需要在生成框架内制定CIL的任务。为此,我们提出了一种新颖的生成性多模式模型(GMM)框架,用于类增量学习。我们的方法直接使用改编的生成模型为图像生成Labels。获得详细的文本后,我们使用文本编码器来阐述文本特征,并采用匹配的功能来确定最相似的标签与分类的标签。在传统的CIL设置中,我们在长期序列的任务方案中取得了更好的影响。under少数CIL设置,与所有当前最新方法相比,我们的精度至少提高了14%,而遗忘的遗忘明显较小。我们的代码可在https://github.com/doubleclass/gmm上找到。

可控文本到图像合成,适用于多模态 MR 图像
近年来,生成模型取得了重大进展,尤其是在文本到图像合成领域。尽管取得了这些进展,但医学领域尚未充分利用大规模基础模型的功能来生成合成数据。本文介绍了一种文本条件磁共振 (MR) 成像生成框架,解决了与多模态考虑相关的复杂性。该框架包括一个预先训练的大型语言模型、一个基于扩散的提示条件图像生成架构和一个用于输入结构二进制掩码的附加去噪网络。实验结果表明,所提出的框架能够生成与医学语言文本提示一致的逼真、高分辨率和高保真的多模态 MR 图像。此外,该研究根据文本条件语句解释了生成结果的交叉注意力图。这项研究的贡献为未来文本条件医学图像生成的研究奠定了坚实的基础,并对加速医学成像研究的进步具有重要意义。
通过非侵入式脑机接口和生成式人工智能辅助多模式软件记录梦境
摘要:本研究提出了一种新的梦境记录方法,该方法结合了非侵入式脑机接口 (BMI)、思维输入软件和生成式 AI 辅助多模态软件。该方法旨在将 REM 睡眠期间的意识过程升华到半意识状态,并产生用于思维输入的信号。我们概述了一个两阶段的过程:首先,使用生成式 AI 开发多模态软件来补充文本流并生成多媒体内容;其次,采用基于摩尔斯电码的打字方式来简化信号要求并提高打字速度。我们通过建议一种涉及植入 BMI 的用户的控制系统来优化非侵入式信号,从而应对非侵入式 EEG 的挑战。文献综述重点介绍了 BMI 打字、意识过程升华以及生成式 AI 在基于文本提示的思维输入方面的潜力方面的最新进展。

镜子u-net:将多模式裂变与多任务学习嫁给医学成像中的语义分割
正电子发射断层扫描(PET)和计算的刻录术(CT)通常共同用于检测肿瘤。PET/CT分割模型可以自动化肿瘤的描述,但是,当前的多模式模型不能完全阐明每种模式中的互补信息,因为它们要么串联PET和CT数据,要么在决策水平上融合它们。为了对抗这一点,我们提出了镜像u-net,它通过将多模式表示形式分配到模态特异性的解码器分支和辅助多模态解码器中,以多模态化的方式代替了传统的融合方法。在这些分支上,镜像u-net标志着一个针对每种模式量身定制的任务,以增强单峰特征,同时保留共享表示中的多模式特征。与以前的方法相比使用了其他方法或多任务学习,Mirror U-net将两个范式结合在一个统一的框架中。我们探索各种任务组合,并检查在模型中共享的哪些参数。我们在Autopet PET/CT和多模式MSD Braintumor数据集上评估了Mirror U-NET,证明了其在多模式分段中的有效性并在两个数据集中实现了先进的性能。代码:https://github.com/zrrrrr1997/ autopet_challenge_mirrorunet
L2词汇音调采集中的多模式提示
海洋生物膜是全球无处不在的表面相关微生物群落,由于其独特的结构和功能,引起了人们的关注。The aim of this study is to provide a comprehensive overview of the current scienti fi c understanding, with a speci fi c focus on naturally occurring bio fi lms that develop on diverse marine abiotic surfaces, including microplastics, sea fl oor sediments, subsurface particles, and submerged arti fi cial structures susceptible to biocorrosion and biofouling induced by marine bio fi LMS。本文介绍了有关海洋环境中这些表面相关微生物群落的多样性,结构,功能和动态的最新进展和发现,突出了它们的生态和生物地球化学维度,同时也是为了进一步研究海洋生物生物LMS的灵感。
多模式面部图像生成的扩散驱动的GAN倒置
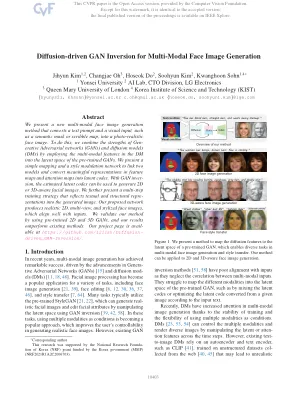
摘要我们提出了一种新的多模式面部图像生成方法,该方法将文本提示和视觉输入(例如语义掩码或涂鸦图)转换为照片真实的面部图像。为此,我们通过使用DM中的多模式特征在预训练的GAN的潜在空间中使用多模式特征来结合一般的对抗网络(GAN)和扩散模型(DMS)的优势。我们提供了一个简单的映射和一个样式调制网络,可将两个模型链接起来,并在特征地图和注意力图中将有意义的表示形式转换为潜在代码。使用gan inversion,估计的潜在代码可用于生成2D或3D感知的面部图像。我们进一步提出了一种多步训练策略,该策略将文本和结构代表反映到生成的图像中。我们提出的网络生成了现实的2D,多视图和风格化的面部图像,这些图像与输入很好。我们通过使用预训练的2D和3D GAN来验证我们的方法,我们的结果表现优于现有方法。我们的项目页面可在https://github.com/1211SH/diffusion-driven_gan-inversion/。

大多数:运动预测的多模式场景象征化
许多现有的运动预测方法都依赖于符号感知输出来生成代理轨迹,例如边界框,路图信息和traf-fight。这种符号表示是现实世界的高级表现,它可能会使运动预测模型容易受到感知错误的影响(例如,在检测开放式录音障碍时失败),而缺少场景中的显着信息(例如,糟糕的道路条件)。另一种范式是从原始传感器中端到端学习。但是,这种方法缺乏解释性,需要大量的培训资源。在这项工作中,我们提出将视觉世界的标记化为一组紧凑的场景元素,然后利用预先训练的图像基础模型和LiDAR神经网络以开放式播音方式进行编码所有场景元素。图像基础模型使我们的场景令牌可以编码开放世界的一般知识,而LiDAR神经网络编码几何信息。我们提出的表示形式可以有效地用几百个令牌编码多帧多模式观察,并且与大多数基于变压器的体系结构兼容。为了评估我们的方法,我们使用了带有凸轮嵌入的Waymo开放运动数据集。通过Waymo开放运动数据集进行的实验表明,我们的方法会导致对最先进的表现的显着改善。
地理空间植被预测的多模式学习
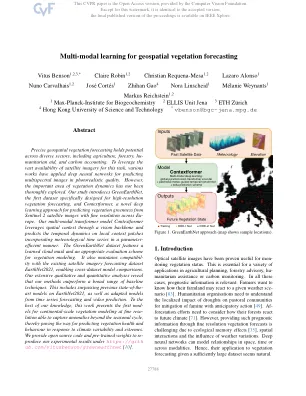
精确的地理空间植被预测具有各个部门的潜力,包括农业,林业,植物援助和碳会计。为了利用卫星图像的广泛可用性来完成此任务,各种作品应用了深层神经网络,以预测具有逼真质量的多光谱图像。但是,尚未彻底探索植被动力学的重要领域。我们的研究介绍了Greenearthnet,这是第一个专门为高分辨率植被预测设计的数据集,以及ContextFormer,这是一种新颖的深度学习方法,可预测Sentinel 2卫星2卫星图像,并在整个Eu-Rope之间进行精细分辨率。我们的多模式变压器模型上下文形式通过视觉主链利用空间上下文,并以参数有效的方式预测局部上下文贴片上包含气象时间序列的时间动态。Greenearthnet数据集具有学习的云蒙版和适当的植被建模评估方案。它还与现有的卫星图像预测数据集SEARNET2021保持兼容性,从而实现了跨数据库模型比较。我们广泛的定性和定量分析表明,我们的方法的表现优于广泛的基线技术。这包括超越了SEARNET2021上的先前最先进的模型,以及时间序列预测和视频预测的改编模型。我们提供开源代码和预训练的权重,以根据https:// gith ub.com/vitusbenson/greenearthnet [10]重新产生我们的实验结果。据我们所知,这项工作为大陆规模植被建模的第一个模拟介绍了良好的分辨,能够在季节性周期以外捕获异常,从而为对气候变化和极端的响应铺平了预测植被健康和行为的道路。
利用非脑和多模态脑成像数据预测健康和病理衰老过程中未来的认知能力下降
a 瑞士苏黎世大学心理学系可塑性研究方法 b 瑞士苏黎世大学和苏黎世联邦理工学院苏黎世神经科学中心 (ZNZ) c 瑞士苏黎世大学大学研究优先计划“健康老龄化动力学” d 法国帕莱索巴黎萨克雷大学、Inria、CEA e 德国莱比锡马克斯普朗克人类认知和脑科学研究所神经病学系 f 加拿大魁北克省蒙特利尔蒙特利尔大学老年医学研究所功能神经影像科 g 美国德克萨斯州奥斯汀德克萨斯大学戴尔医学院计算神经影像实验室 h 美国密歇根州底特律韦恩州立大学老年学研究所和心理学系 i 加拿大蒙特利尔康考迪亚大学心理学系 j 大脑与运动研究所认知神经解剖学实验室épinière,法国巴黎 k 德克萨斯大学心理学系,美国德克萨斯州奥斯汀
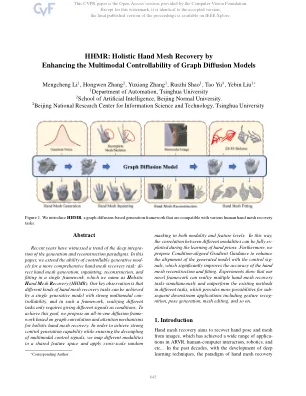
HHMR:通过增强图扩散模型的多模式可控性
近年来见证了一代和重建范式深入融合的趋势。在本文中,我们扩展了可控制的生成模块的能力,以实现更全面的手网恢复任务:在单个框架中,手工网格的生成,内部网状,重建,重建和拟合,我们将其命名为H olistic H和MESH R Ecovery(HHMR)。我们的主要观察结果是,具有强大多模式可偿还性的单个生成模型可以实现不同类型的手网恢复任务,并且在这样的框架中,实现不同的任务只需要给出不同的信号作为条件。为了实现这一目标,我们提出了基于图形卷积和整体手工网状恢复的注意力卷积和注意力机制的多合一扩散框架。为了实现强大的控制能力,同时确保多模式控制信号的解耦,我们将不同的模态映射到共享特征空间并应用跨尺度随机