
XiaoMi-AI文件搜索系统
World File Search System定量
膜蛋白质 - 含量的定量,时间分辨测量
图。5:用酪蛋白钝化的悬臂背面的AFM图像在0.5pm T5溶液的溶液中孵育1.5h(箭头标记T5噬菌体或可能的酪蛋白聚集体)请注意,这里的条件与手稿中呈现的原位实验不同。


关于单词顺序和方面的跨语言,基于语料库的定量建模
人类语言最引人注目的特征之一是它们的极端变化。更加惊人的是,在统治其形式和功能的强烈代表性和认知规律的明显变化背后的存在:语言普遍性。我们在这里讨论我们小组的一些最新工作,其中大规模,数据密集型计算建模技术用于解决有关语言规律性的基本语言问题。在单词顺序区域中,我们在此处报告工作,这些工作利用大量单语和平行语料库数据来开发名词短语(通用20)和一般结构最小化原则的内部结构的计算模型。在事件持续时间的领域,我们报告的工作利用了深厚的相似性和表面差异来开发真正的跨语言自然语言处理工具。

使用定量聚合酶链反应(QPCR)方法
目前,使用猪污染的食物成分和或加工食品已成为当前的关注和加强问题。这种情况鼓励开发准确的方法,以特别检测猪污染的存在。本研究使用两种样品:(1)新鲜猪肉作为阳性内部控制和(2)用猪肉(碎肉,肉丸,咸牛肉和香肠)制成的加工肉类产品,这些产品使用DNA标记进行了测试。使用猪肉处理的样品是确定加工对DNA片段的影响,并在所使用的检测过程中测试提取方法的刚性。本研究旨在使用定量聚合酶链反应(QPCR)方法检测猪DNA片段。研究首先使用RNA提取试剂盒,DNA提取试剂盒和盐提取方法提取新鲜的猪肉和加工产品,然后使用分光光度计测量DNA/RNA的纯度和浓度。RNA提取物被转化为互补DNA(cDNA),并与使用QPCR分析的DNA提取物(SUS SCROFA)。结果表明,获得的RNA和DNA提取物的浓度为71.1-296,025 ng/ul,纯度不同。在CT 23-28 ng/ul范围内,所有加工产品和阳性内部的样品都是放大的对照,在这种情况下,肉的加工不会影响分析的加工产品的DNA,因此可以检测到DNA片段。关键字:beta aktin,循环阈值,新鲜猪肉,DNA猪肉,qpcrqPCR DNA在工作时间上比cDNA qPCR更有效,因为它不需要RNA的转录阶段。

引用本文:Laura Sheppard,Jonathan Reades&R。P. J. Freeman(2023):Gendering和多样化研究管道:定量的FEMI
妇女和性别少数群体在学术界的领导和资历方面的人数不足。对高等教育中性别的研究(HE)的规模和方法论方法各不相同,从大规模的全球调查到具有访谈和焦点小组的小规模项目,在对早期职业研究人员和博士生的关注方面存在明显的差距,以及他们的经验以及他们的经验从分期计,机构到机构,部门和“部门级别” ”利用性别理论将性别与权力和性别组织联系起来,我们将这种理论观点与HE中的性别研究联系起来。 本文提出了一个新的议程,以通过将定量和女权主义地理汇总到HE内的不同“ palatial”量表的问题上,以加深我们对他中的性别的理解。 我们建议扩大定量研究中经常使用的性别的定义,并考虑使用开源数据,以提供对HE中性别动力学的新颖和可重复的见解,并使用定量地理学方法来发展对这些动态的多层次理解。 关键词:女权主义地理,性别,高等教育,定量地理。”利用性别理论将性别与权力和性别组织联系起来,我们将这种理论观点与HE中的性别研究联系起来。本文提出了一个新的议程,以通过将定量和女权主义地理汇总到HE内的不同“ palatial”量表的问题上,以加深我们对他中的性别的理解。我们建议扩大定量研究中经常使用的性别的定义,并考虑使用开源数据,以提供对HE中性别动力学的新颖和可重复的见解,并使用定量地理学方法来发展对这些动态的多层次理解。关键词:女权主义地理,性别,高等教育,定量地理。
定量降水估计(QPE)天气雷达使用衰减校正和Z-R关系算法的比率
定量降水估计(QPE)天气雷达在东Java Laode Nodeman的某些部分中使用Z-R关系算法的衰减和比较Z-R关系算法,Retnadi Heru Jatmiko博士,硕士。; Emilya Nurjani博士,S.Sc.,M.Sc。

选民投票率的经济决定因素:一种定量方法
对选民投票率的研究认为,低经济绩效会影响选民投票率。然而,学者们继续在这种关系的方向上不同意,因为有些人认为经济表现不佳是对选民投票的威慑,而其他人则认为这是投票的动机。采用定量方法本文旨在进一步阐明选民投票率与选民经济绩效之间的关系。该研究发现经济逆境与选民投票率之间有着牢固的关系。重要的是,研究发现,这种关系虽然很强,但这种关系是复杂且多层的。总体而言,本文旨在进一步就经济绩效与选民投票率之间的关系进行辩论,并阐明影响其力量和方向的机制。
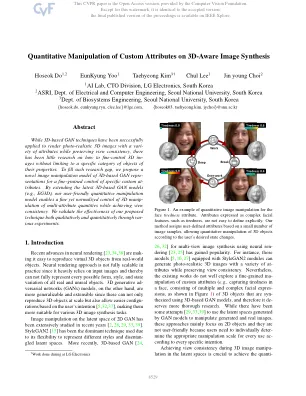
3D感知图像合成上自定义属性的定量操纵
尽管基于3D的GAN技术已成功地应用于具有各种属性的照片真实的3D图像,同时保持视图一致性,但很少有关于如何罚款3D impersimens的研究,而不会限制其属性特定对象的特定对象类别。为了填补此类研究空白,我们提出了一个基于3D的GAN代表的新型图像操纵模型,以对特定的自定义贡献进行细粒度控制。通过扩展最新的基于3D的GAN模型(例如,EG3D),我们的用户友好定量操作模型可以实现对3D操作多属性数量的精细而归一化的控制,同时实现了视图一致性。我们通过各种实验验证了我们提出的技术的有效性。

关于在地球科学中使用监督机器学习使用的定量分析
地球科学中标记的培训数据的可用性反映在监督分析中使用的训练数据数量中。除了上述10年的分析外,我们还从2018 - 2019年的AGU论文中手动提取了其他相关信息,包括应用的ML算法,标记的培训数据的数量和数据类型(模型输出,卫星,原位,原位,重新分析等)。在我们调查的论文中,大多数ML算法是使用数百个标记样品培训的。但是,对于使用模型输出或大型,已建立的数据集的某些应用程序,培训数据的数量范围更大。缺乏训练数据在生物学科学和陆地水圈(水文)研究中尤其急切。

定量确定coenzyme-q10-from-dietary- ...
“最终出版物可在link.springer.com上获得” doi:10.1007/s00216-015-8506-8分析和生物分析化学407(10):2887-2898