
XiaoMi-AI文件搜索系统
World File Search System主动
通过扩展主动推理进行目标导向规划和目标理解:通过模拟和物理机器人实验进行评估
摘要:我们表明,通过扩展主动推理框架,可以在目的论框架中制定目标导向的行动规划和生成。所提出的模型建立在变分递归神经网络模型上,具有三个基本特征。这些特征是:(1)可以为静态感官状态(例如要达到的目标图像)和动态过程(例如围绕物体移动)指定目标;(2)该模型不仅可以生成目标导向的行动计划,还可以通过感官观察来理解目标;(3)该模型根据从过去的感官观察推断出的当前状态的最佳估计,为给定目标生成未来的行动计划。通过在模拟移动代理以及执行对象操作的真实人形机器人上进行实验来评估所提出的模型。

Onyx | Terahertz技术用于薄膜和2D材料的非接触电气表征 Thales Eric Belhaire 高精度放置 - 被动与主动对准... 发光光子学:«哇»效果 通过施加薄玻璃的光子系统包装(PSIP) 缩放光子集成和混合多... 的包装 Sara Pourjamal,VTT 使用光子连接和包装多核纤维... 镜头(FAML)到光子线键合(PWB) Micro-Optics Datacom的促成技术 Martin Hermatschweiler,首席执行官兼联合创始人9月... Katharina Jag-Lauber系统工程师08。2024年10月8日,Quantum Effectes 机器学习驱动激光束表征
在半导体和高级材料行业中需要使用非接触式和非毁灭性工具,以表征散装,薄膜和2D材料的电气性能。

生物囊膜的主动和被动矿化...
1口腔生物学系,维也纳医科大学大学牙科诊所,奥地利1090年; caroline7_k@hotmail.com(k.a.a.a.); layla.panahipour@meduniwien.ac.at(L.P.)2 Karl Donath硬组织和生物材料研究实验室,维也纳医科大学牙科诊所,奥地利1090,奥地利维也纳; patrick.heimel@trauma.lbg.ac.at(P.H.); stefan.tangl@meduniwien.ac.at(S.T。); stefan.lettner@meduniwien.ac.at(S.L.); carina.kampleitner@meduniwien.ac.at(C.K。)3奥地利维也纳1090号组织再生的奥地利集群4路德维希·鲍尔茨曼创伤学院,与AUVA合作研究中心,奥地利维也纳维也纳1200号,奥地利维也纳大学诊所,奥地利1090 Vienna,奥地利1090 Vienna,奥地利,奥地利,奥地利1090; ulrike.kuchler@meduniwien.ac.at 6牙科医学院牙科医学学院,伯尔尼大学3010,瑞士伯尔尼 *通信:Reinhard.gruber.gruber@meduniwien.ac.at3奥地利维也纳1090号组织再生的奥地利集群4路德维希·鲍尔茨曼创伤学院,与AUVA合作研究中心,奥地利维也纳维也纳1200号,奥地利维也纳大学诊所,奥地利1090 Vienna,奥地利1090 Vienna,奥地利,奥地利,奥地利1090; ulrike.kuchler@meduniwien.ac.at 6牙科医学院牙科医学学院,伯尔尼大学3010,瑞士伯尔尼 *通信:Reinhard.gruber.gruber@meduniwien.ac.at
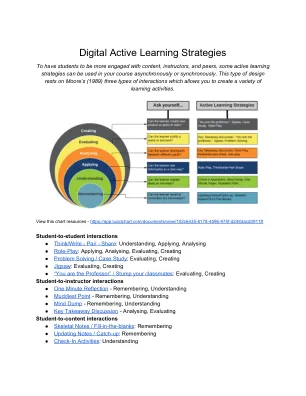

明智的帮助:在家庭中积极主动和自适应机器人帮助的战略对手建模
尽管在日常任务中对弱势群体(例如,老年人,儿童和残疾人)的辅助技术有很大的需求,但对高级AID辅助解决方案的研究确实满足了他们的各种需求,这仍然很少。传统的人机互动任务通常需要机器来简单地帮助您对人类能力和感觉的细微差别,例如他们进行实践和学习的机会,自我改善感和自尊心。解决这一差距时,我们定义了一个关键而新颖的挑战智能帮助,旨在为各种残疾人的人提供积极主动而自适应的支持,并在各种任务和环境中提供动态目标。为了确定这一挑战,我们利用AI2- [32]来构建一个新的互动3D实体家庭环境,以完成智能帮助任务。我们采用了一个创新的对手建模模块,该模块对主要代理的能力和目标有细微的理解,以优化辅助代理人的帮助政策。严格的实验验证了我们的模型组件的功效,并显示了我们整体方法与已建立基线的优越性。我们的发现说明了AI所辅助机器人在改善弱势群体的福祉方面的潜力。

电池管理系统中的主动电池平衡
抽出时间从忙碌的日程中为我们提供了很多帮助,支持和指导我们在项目的各个方面都努力工作。她的观点一直是公平的,在鼓励和建设性批评之间取得了完美的平衡。她的建设性技巧和建议有助于我们的项目。
主动学习信心 - 自由函数在机器人中 -
老龄化社会的需求提出了在日常情况下机器人支持人类的希望。对于这些辅助机器人,与用户自然通信的功能能力至关重要。但是,当前对话系统中使用的最先进技术远远不令人满意。对于使用这些技术的机器人选择适当的动作,例如朝橱柜移动或在听到命令“带给我杯子”时,这不是一件容易的事。房屋内部可以有许多候选杯子,并且需要将其移交给用户的特定杯子根据情况而不同。例如,它可能与准备一顿饭菜或被清除的一顿饭有关。出于实际原因,服务机器人采用的大多数对话管理机构是言语(用户的话语)和非语言(例如,视觉,运动和背景)的信息。使用这些机制,当机器人处理发音时,情况和以前的经历都没有考虑到,因此它可能会执行用户没有想象的动议。在这项研究中,当机器人由于识别误差而执行不良运动时,我们将“运动失败”定义为发生的。这项研究的目的是减少失败的风险。专注于语言理解与运动之间的关系,我们不处理成功识别用户命令的情况,但执行的运动最终导致了不良的结论。考虑一个机器人成功识别命令“选择对象”的情况,但是机器人在尝试捡起时未能掌握指定的对象。

主动组件电气技术&...
连接器D38999/20 THRU D38999/49 M24308/L THRU M24308/26 M39012/1 THRU M39012/124 M39029/1 THRU M83513/01 THRU M83513/09 M83723/l THRU M83723/98 MS3100 THRU MS3116 MS3400 THRU MS3459 MS3470 THRU MS3476 MS24264 TKRU MS24266 MS27466 THRU MS27656 MS27472 THRU MS27508 Relays &插座AN3342直至AN3380 M128843/40到达M128843/48 M5757/L THRU M5757/103 M6106/1 THRU M6106/36 MS21330 M39016/42 MS1305 M83383/1至M83383/4 MS3536/1 THRU M83536/25 MS3726/1 THRU M83726/27开关M83726/27开关M8805/111 M9419 M83731/9 THRU M83731/16 MS14001 THRU MS14003 MS14003 MS16106 THRU MS18152 MS24000 THRU MS35059 MS90310 THRU
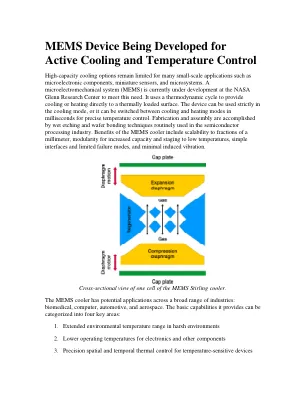
正在开发用于主动冷却和温度控制的 MEMS 设备
对于许多小型应用,如微电子元件、微型传感器和微系统,高容量冷却选项仍然有限。NASA 格伦研究中心目前正在开发一种微机电系统 (MEMS) 来满足这一需求。它使用热力学循环直接为热负荷表面提供冷却或加热。该设备可以严格在冷却模式下使用,也可以在几毫秒内切换冷却和加热模式,以实现精确的温度控制。制造和组装是通过半导体加工行业常用的湿法蚀刻和晶圆键合技术完成的。MEMS 冷却器的优点包括可扩展到几分之一毫米、模块化以提高容量和分级到低温、简单的接口和有限的故障模式,以及最小的诱导振动。
使用变分循环神经网络进行主动推理,为习惯智能体进行目标导向规划
摘要:至关重要的是要问,代理如何仅使用通过习惯性感觉运动经验获得的部分世界模型来生成行动计划,从而实现目标。尽管许多现有的机器人研究都使用了前向模型框架,但存在高自由度的泛化问题。当前的研究表明,采用生成模型的预测编码 (PC) 和主动推理 (AIF) 框架可以通过学习低维潜在状态空间中的先验分布来开发更好的泛化,该先验分布表示从习惯性感觉运动轨迹中提取的概率结构。在我们提出的模型中,学习是通过推断最佳潜在变量以及突触权重来最大化证据下限来进行的,而目标导向规划是通过推断潜在变量来最大化估计下限来完成的。我们提出的模型在模拟中使用简单和复杂的机器人任务进行了评估,通过为正则化系数设置中间值,证明了在有限的训练数据下学习中具有足够的泛化能力。此外,比较模拟结果表明,由于先验学习将运动计划的搜索限制在习惯轨迹范围内,因此所提出的模型在目标导向规划中优于传统的前向模型。