
XiaoMi-AI文件搜索系统
World File Search System文本
人工智能法案合并文本
• 使用潜意识、操纵或欺骗手段扭曲行为,妨碍知情决策,造成重大伤害。 • 利用与年龄、残疾或社会经济状况相关的弱点扭曲行为,造成重大伤害。 • 生物特征分类系统推断敏感属性(种族、政治观点、工会会员资格、宗教或哲学信仰、性生活或性取向),但标记或过滤合法获取的生物特征数据集,或执法部门对生物特征数据进行分类的情况除外。 • 社会评分,即根据社会行为或个人特征对个人或群体进行评估或分类,对这些人造成有害或不利的待遇。 • 仅根据分析或性格特征评估个人犯罪的风险,但用于增强基于与犯罪活动直接相关的客观、可验证事实的人类评估的情况除外。 • 通过从互联网或闭路电视录像中无针对性地抓取面部图像来编制面部识别数据库。 • 在工作场所或教育机构推断情绪,医疗或安全原因除外。 • 在公共场所为执法部门提供“实时”远程生物特征识别 (RBI),但以下情况除外:

FCC 提出首创的人工智能生成的自动拨号和机器人文本规则
这些拟议的自动拨号规则是委员会为保护消费者免受人工智能生成的骗局而采取的一系列行动中的最新举措,这些骗局会误导消费者并误导公众,使消费者能够做出明智的决定。委员会提出了新的透明度标准,要求在广播和电视的政治广告中使用人工智能技术时进行披露。委员会最近通过了一项宣告性裁决,明确指出,在未经被叫方事先明确同意或豁免的情况下,针对消费者的常见自动拨号诈骗中使用的语音克隆技术是非法的。它还提议对使用深度伪造、人工智能生成的语音克隆技术和来电显示欺骗进行明显非法的自动拨号进行巨额罚款,以便在 2024 年 1 月初选之前向潜在的新罕布什尔州选民传播选举错误信息。
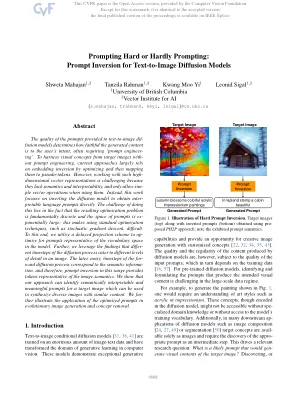
提示文本到图像扩散模型的迅速反转
提供给文本对图像差异模型的提示的质量决定了生成的内容对用户意图的忠诚程度,通常需要“及时工程”。要通过及时的工程来利用目标图像的视觉概念,当前方法在很大程度上通过优化然后将它们映射到伪tokens来依赖嵌入反演。然而,使用这种高维矢量表示是具有挑战性的,因为它们缺乏语义和可解释性,并且只允许使用它们时模拟矢量操作。相反,这项工作着重于反转扩散模型,以直接获得可靠的语言提示。这样做的挑战在于,由此产生的优化问题从根本上是离散的,提示的空间呈较大。这使得使用标准优化技术,例如随机梯度下降,困难。为此,我们利用延迟的投影方案来访问代表模型中词汇空间的提示。此外,我们利用了扩散过程的时间段与图像中不同级别的细节相差的发现。后来的,嘈杂的,前传扩散过程的时间段对应于语义信息,因此,此范围内的迅速反转提供了代表图像语义的令牌。我们表明,我们的方法可以确定目标图像的语义可解释和有意义的提示,该提示可用于合成具有相似内容的多样化图像。我们说明了优化提示在进化图像生成和概念删除中的应用。
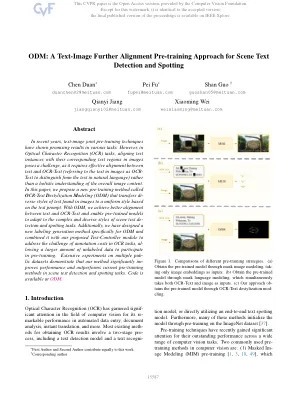
ODM:文本图像进一步的对齐预训练方法,用于场景文本检测和发现
近年来,文本图像联合预训练技术在各种任务中显示出令人鼓舞的结果。然而,在光学特征识别(OCR)任务中,将文本实例与图像中的相应文本区域对齐是一个挑战,因为它需要在文本和OCR文本之间有效地对齐(将图像中的文本称为ocr-文本以与自然语言中的文本区分开来),而不是对整体图像内容的全面理解。在本文中,我们提出了一种新的预训练方法,称为o cr-text d估计化m odeling(ODM),该方法根据文本提示将图像中的文本样式传输到统一样式中。使用ODM,我们在文本和OCR文本之间实现了更好的对齐方式,并启用预训练的模型以适应场景文本的复杂和多样化的样式。此外,我们为ODM设计了一种新的标签生成方法,并将其与我们提出的文本控制器模块相结合,以应对OCR任务中注释成本的挑战,并以大量未标记的数据参与预培训。在多个Pub-LIC数据集上进行的广泛实验表明,我们的方法显着地证明了性能,并且在场景文本检测和发现任务中的当前预训练方法优于当前的预训练方法。代码在ODM上可用。
反事实说明的文本到图像模型
本文解决了生成法定说明(CES)的挑战,涉及识别和修改最少的必要特征,以使分类器对给定图像的预测进行预测。我们提出的方法是反事实e xplanations(Time)的tept to-i mage m odels,是一种基于蒸馏的黑盒反事实技术。与以前的方法不同,此方法仅需要图像及其预测,从而忽略了分类器的结构,参数或梯度的需求。在生成反事实之前,时间将两个不同的偏见引入了文本嵌入的形式稳定扩散:与图像的结构相关联的上下文偏差和类别偏见,与目标分类器学到的类特异性特征相关。学习了这些偏见后,我们发现了使用类预测的类令牌的最佳潜在代码,并使用目标嵌入作为条件,从而产生了符合性的解释。广泛的经验研究证明,即使在黑色盒子设置中运行时,时间也可以产生可比性的解释。

战略管理:文本和案例
Gregory G. Dess是德克萨斯大学达拉斯分校的Andrew R. Cecil管理主席。他的主要研究兴趣是战略管理,组织环境关系和知识管理。他在学术和从业者期刊上发表了许多有关这些主题的文章。他还在各种以从业者为导向和学术期刊的编辑委员会中任职。在2000年8月,他被入选《管理学院名人堂》作为其特许成员之一。DES教授在美国,欧洲,非洲,香港和澳大利亚进行了执行计划。在1994年,他是葡萄牙Oporto的富布赖特学者。2009年,他获得了伯尔尼大学(瑞士)的荣誉博士学位。他获得了华盛顿大学(西雅图)的工商管理博士学位,并获得了佐治亚理工学院的BIE学位。
从文本到图像综合的前景 - 背景分割的无监督共同生成
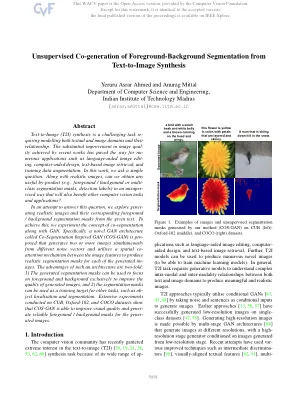
文本对图像(T2I)合成是一项艰巨的任务,该任务是对文本和图像域及其关系进行建模。最近作品实现的图像质量的实质性改进为Nuberon应用程序铺平了道路,例如语言辅助图像编辑,计算机辅助设计,基于文本的图像检索和培训数据增强。在这项工作中,我们提出了一个简单的问题:与逼真的图像一起,我们是否可以以一种不受影响的方式获得任何有用的副产品(例如前景 /背景或多类分割掩码,检测标签,检测标签),这也将使其他计算机视觉任务任务和应用受益?试图回答这个问题,我们探索了从给定文本中的逼真的图像及其相应的前景 /背景分割掩码。为了实现这一目标,我们与GAN一起实验了共进行分割的概念。具体而言,提出了一种名为“共裂”启发的GAN(COS-GAN)的新型GAN结构,该结构同时从不同的噪声矢量中同时生成两个或多个图像,并利用图像特征之间的空间关注机制来生成逼真的分段掩码,以生成生成的Im-Im-Im-Im-Im-Im-Im-Im-Im-Im-Im-Agens。这种架构的优点是两倍:1)生成的分割掩码可用于专注于前景和背景,以改善生成的图像的质量,2)分段蒙版可以用作其他任务的训练目标,例如访问本地化和分割。在CUB,Oxford-102和可可数据集上进行的广泛实验表明,Cos-Gan能够改善视觉质量,并为发电图像提供可靠的前景 /背景掩码。

选择您需要的东西:删除的表示场景文本识别和编辑
场景文本图像不仅包含样式信息(字体,背景),还包含内容信息(字符,纹理)。不同的场景文本任务需要不同的信息,但是以前的表示学习方法 - 在所有任务中使用紧密耦合的功能,从而导致次优性能。我们提出了一个旨在解开这两种功能的分解表示学习框架(亲爱的),以改善适应性,以更好地解决各种下游任务(选择您真正需要的内容)。具体来说,我们合成具有相同样式但内容不同的图像对数据集。基于数据集,我们通过监督设计将两种类型的功能分解。很明显,我们将视觉表示形式直接分为样式和内容功能,内容特征是通过文本识别损失来监督的,而对齐损失使图像对中的样式特征保持一致。然后,样式功能用于通过图像解码器重新构造对应图像的提示,以指示对应方的内容。这样的操作根据其独特属性有效地将功能分解。据我们所知,这是场景文本领域中第一次删除文本图像的固有属性。 我们的方法在场景文本识别,转换和编辑中实现了最新的性能。据我们所知,这是场景文本领域中第一次删除文本图像的固有属性。我们的方法在场景文本识别,转换和编辑中实现了最新的性能。

布局 - 敏捷场景文本图像综合与扩散模型
虽然扩散模型已显着提高了图像生成的质量,但它们在这些图像中准确且相干渲染文本的能力仍然是一个重大挑战。场景文本生成的常规基于扩散的方法通常受到对中间布局输出的依赖的限制。这种依赖性通常会导致文本样式和字体的多样性限制,这是布局生成阶段的确定性质所引起的固有限制。为了应对这些挑战,本文介绍了SceneTeTgen,这是一种基于新颖的扩散模型,专门设计用于规避预定义布局阶段的需求。这样做,场景 - 文本促进了文本的更自然和多样化的代表。SceneTextGen的新颖性在于其三个关键组成部分的整体:一个字符级编码器,用于捕获详细的印刷属性,并与字符级实例分割模型和Word-
从文本到图像模型中检查图像的地理代表性
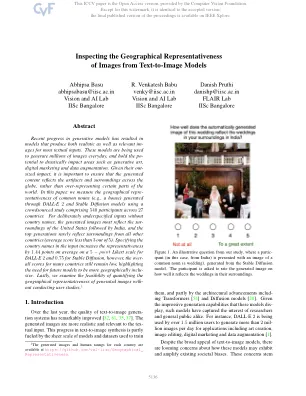
生成模型的最新进展导致了模型,这些模型既可以为大多数文本输入产生现实和相关的信息。这些模型每天都用于生成数百万张图像,并具有巨大影响诸如生成艺术,数字营销和数据增强等领域。鉴于它们的影响力,重要的是要确保生成的内容反映全球的伪影和周围环境,而不是过分代表世界的某些地区。在本文中,我们使用众包研究的研究衡量了通过dall·e 2产生的普通名词(例如房屋)的地理代表,以及稳定的扩散模型,其中包括27个国家 /地区的540名参与者。为了有意地指定没有国家名称的意见,生成的图像最反映了美国之后是印度的周围,而顶级世代很少反映出所有其他国家的周围环境(平均得分少于5分中的3个)。在输入中指定国家名称的代表性增加了1。平均在5-点李克特(Dall)的李子量表上为44点。75对于稳定的扩散,许多国家的超高分数仍然很低,这突出了将来模型在地理上更具包含的需求。最后,我们研究了量化使用用户研究的产生图像的地理代表性的可行性。1